MiniMax H3 Image 开源:4K生图只需10到20秒

资讯 凤凰科技 作者:爱范儿 全文 4672 字 · 约 12 分钟读完 配图 17 张 分类MiniMaxGPTOpenAI开源图像生成

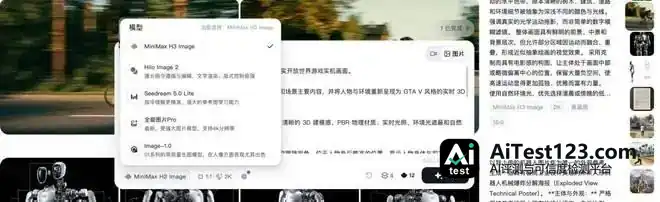
MiniMax H3 Image正式发布,4K高清生图开源,支持16图参考

所属频道 大厂动态ChatGPT 与 GPT开源生态视频图像生成

MiniMax H3 Image 开源:4K生图只需10到20秒(配图 1)

今年 8 月,MiniMax 把 H3 视频生成模型的权重放了出来,这是史上首个达到 SOTA 水平的开源视频模型。之后几个月,社区用它玩出的花样比官方演示多得多,还衍生出 H3 max 等一批模型,确实把 AI 创意行业往前推了一把。
MiniMax H3 Image 开源:4K生图只需10到20秒(配图 2)

如今,图像生成这块 MiniMax 也不打算捂着。MiniMax H3 Image 刚正式亮相,主打图像生成与编辑,瞄准的是开源图像模型里的 SOTA。

H3 此前靠统一的全模态预训练,已经能理解并生成图像、视频、音频等内容,文生图和图像编辑也在其中。H3 Image 则是在这套底子上,针对图像生成与编辑再做后训练优化,复杂指令遵循、图像细节和视觉审美都跟着提升。
MiniMax H3 Image 开源:4K生图只需10到20秒(配图 3)

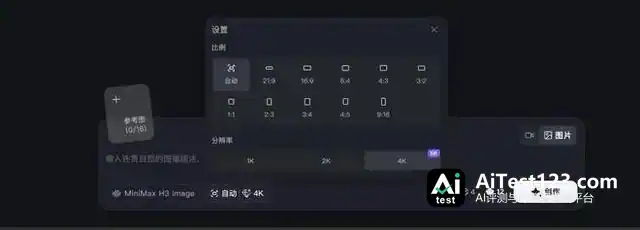
分辨率和速度是最直观的感受。我们实测时,H3 Image 出一张 4096×4096、4K 画质的高规格图片,只要 10~20 秒。

过去高分辨率生图动辄要等几十秒甚至更久,现在十几秒就能出图。4K 级图像生成开始以十秒计,高分辨率带来的细节优势,也能更频繁地用在日常创作里。

我们用 H3 Image 生成过各种讲究美感的图片,CG、游戏场景、工业设计以及多种艺术风格,它都表现不错。
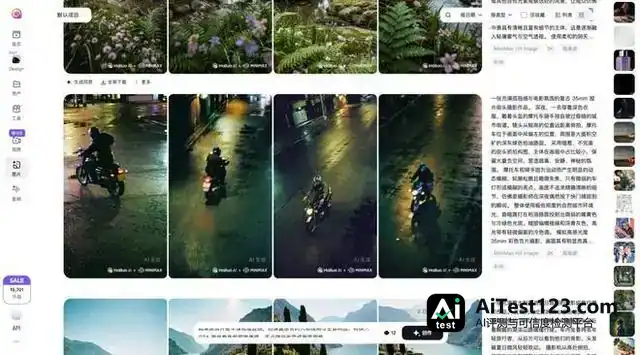
MiniMax H3 Image 开源:4K生图只需10到20秒(配图 4)

复杂指令遵循是这次强化的重点,最多可接入 16 张参考图片,能同时理解不同的主体、材质和风格要求。

发布当天权重就开放了,开发者可以通过 API 接入,也能在 MiniMax 开放平台、MCode 和 MiniMax 海螺平台里使用。

MiniMax H3 Image 开源:4K生图只需10到20秒(配图 5)

APPSO 提前试了这款新模型。除了画面好看,我们更想弄清它到底能读懂多复杂的需求,图像细节又能做到什么程度。

复杂需求也能画准

以前测图像模型,我们多半只看它能不能画出提示词里的物体。可实际工作里,交给设计师的需求往往复杂得多:产品零件怎么组装,某个区域要保留哪些元素,几张参考图之间又是什么关系。模型得先弄懂这些条件,才可能画对。
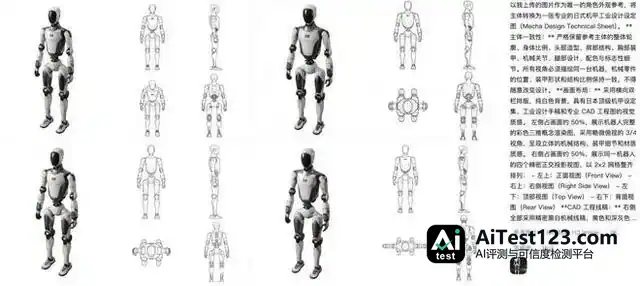
MiniMax H3 Image 开源:4K生图只需10到20秒(配图 6)

这次我们从工业产品的结构设计切入,让 H3 Image 画一台未来主义咖啡机的产品爆炸图。豆仓、研磨器、冲煮模块、水箱等结构都要展示出来,各部分的连接关系要标明,产品设计的一致性也得保住。
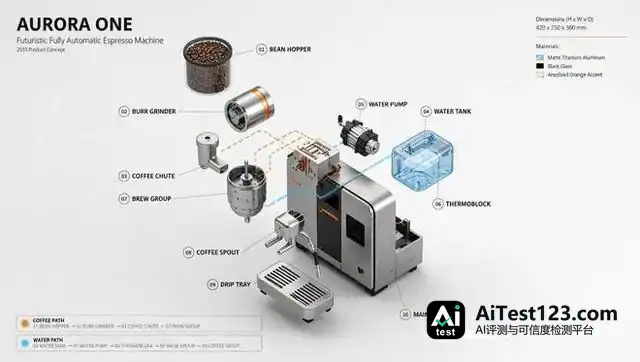
MiniMax H3 Image 开源:4K生图只需10到20秒(配图 7)

机械结构之外,文字处理也是图像生成模型常碰到的硬骨头,既要字写对,又要兼顾字体设计、画面构图和整体视觉效果。大字海报考验的是文字内容、字体造型和视觉构图三者兼顾;场景里塞进大段小字时,文字准确性、信息层级和排版又成了新难题。

我们先让 H3 Image 做了一张凤凰(Phoenix)主题的新古典主义装饰艺术海报,把西方神话、复古雕版画、维多利亚时代装饰纹样和现代极简排版揉在一起。

画面标题 PHOENIX MYTH(凤凰神话)和副标题 Eternal Rebirth of the Fire Bird(火鸟的永恒重生),H3 Image 都渲染准确了。
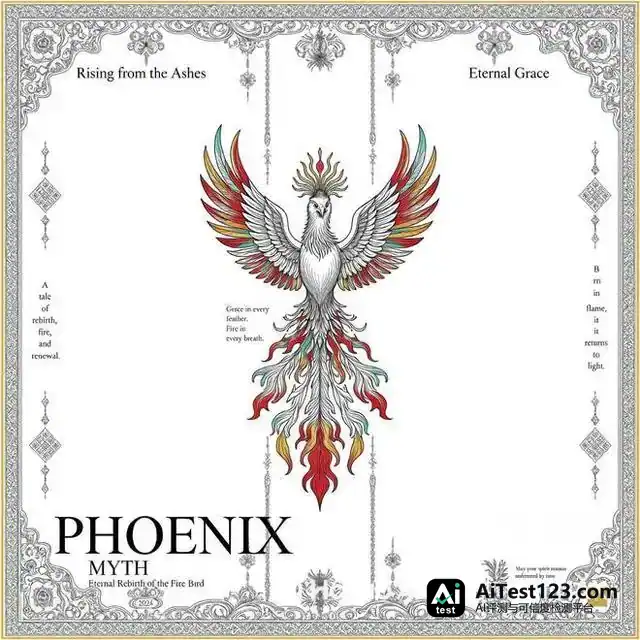
MiniMax H3 Image 开源:4K生图只需10到20秒(配图 8)

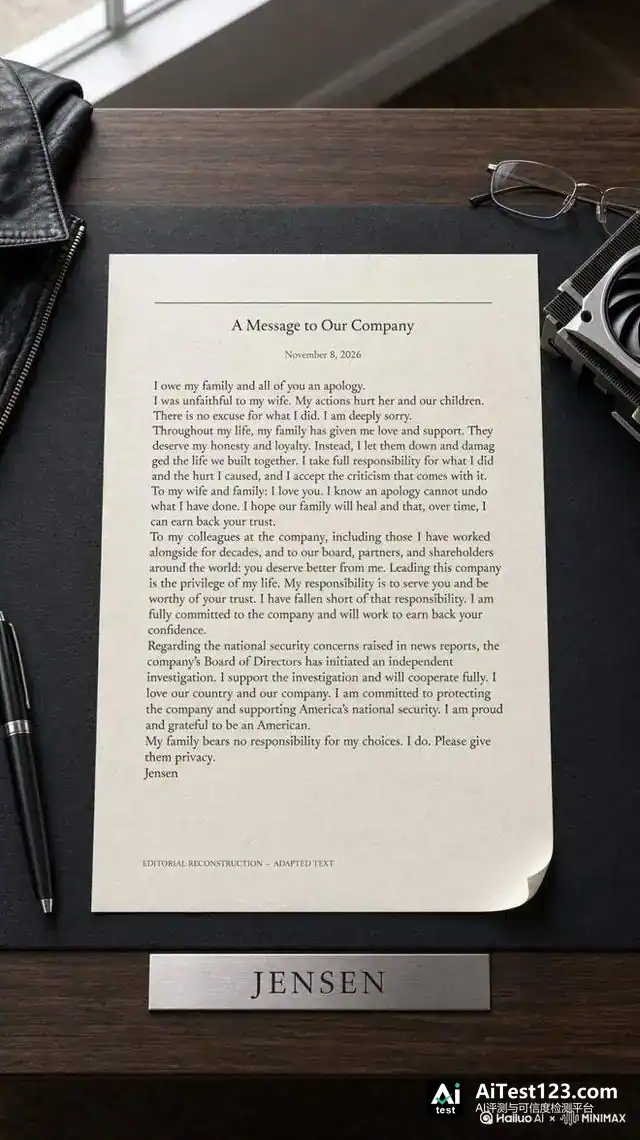
小字表现方面,我们找来这段时间闹得沸沸扬扬的黄仁勋公开信,让 H3 Image 生成了一份摆在桌面上的信纸版。
MiniMax H3 Image 开源:4K生图只需10到20秒(配图 9)

图里的文字基本都准确生成了,没有明显错误,整体样式也和图片周围的风格对得上。细看信纸四周的细节,全和老黄有关。

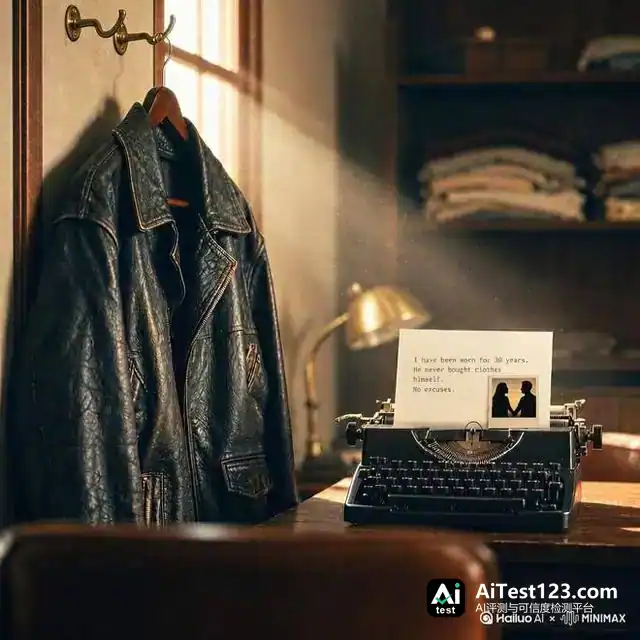
怀旧风场景也能出:墙上挂着一件经典皮衣,旁边打字机上的独白是「我已经被穿了 30 年了。」
MiniMax H3 Image 开源:4K生图只需10到20秒(配图 10)

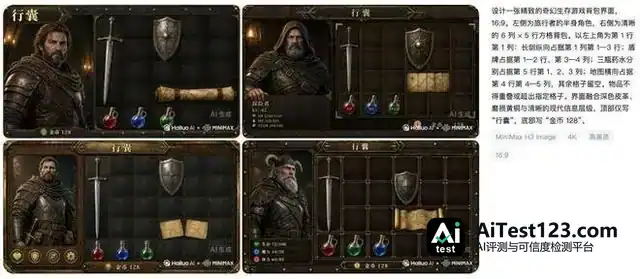
我们还让 H3 Image 试了更复杂的游戏界面,文字渲染和布局都接近生存游戏,显示生命、魔力和体力等级。
MiniMax H3 Image 开源:4K生图只需10到20秒(配图 11)

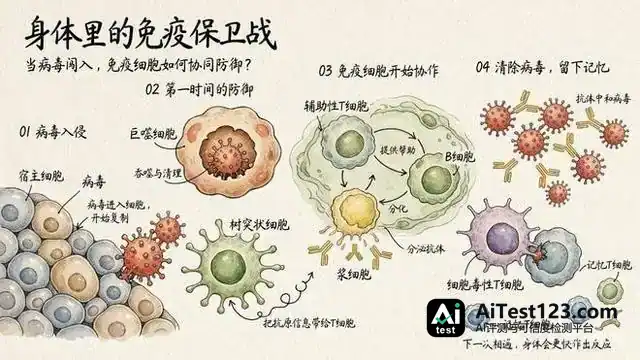
再往深一步,就要看Image能不能读懂文字与图片之间的那层逻辑。这需要它具备语义理解能力,还得懂科学、数学、生物等领域的知识,并且把逻辑既准确又好看地呈现出来。
MiniMax H3 Image 开源:4K生图只需10到20秒(配图 12)

机械结构也好,文字排版也罢,再到知识理解,这些案例其实都指向同一个问题:模型能不能真正弄明白用户想表达什么,再把它准确变成图像。

H3 Image这次最多可接受16张图片作参考。也就是说,我们可以一次性给出产品的不同视角、材质参考、品牌元素和场景图,再让模型把这些信息揉进同一张作品里。
MiniMax H3 Image 开源:4K生图只需10到20秒(配图 13)

更让人期待的是,H3 Image还能通过API接入MiniMax Code、Claude Code、Codex等Agent Harness,直接参与到更复杂的任务流程中去。

换句话说,创作需求可以直接在Agent的对话框里提出,由Agent整理任务、调用H3 Image出图,再借助后续对话反复修改设计。

MiniMax H3 Image 开源:4K生图只需10到20秒(配图 14)

MiniMax H3 Image 开源:4K生图只需10到20秒(配图 15)

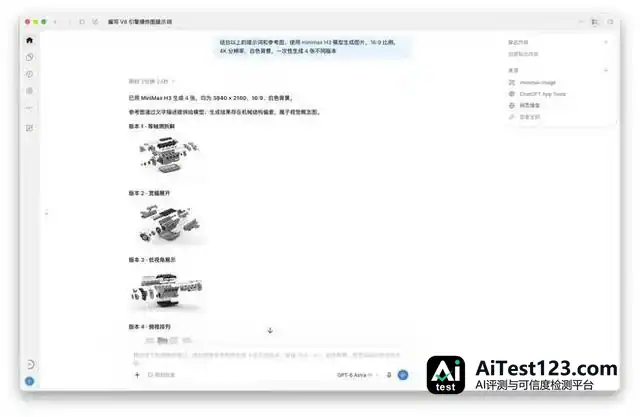
比如这个在Codex里用MiniMax H3 Image生成V8引擎爆炸拆解图的案例,Agent先搜集和整理信息,最后产出的几张拆解图都相当逼真。

对Agent来说,它得持续管理上下文和用户的修改意见;对H3 Image来说,则要理解Agent整理后的复杂指令,并尽可能准确地执行。这种工作方式,对图像模型的指令遵循和复杂信息理解能力提出了更高要求。

而开源的图像生成模型H3 Image确实做到了理解复杂需求、执行精确修改,并在连续创作中保持一致,这也让它开始真正融入Agent工作流。

尤其是现在很多主流生图模型还停留在百万像素或四百万像素,H3 Image却能直接生成4096×4096的超高清画面,像素数量达到4K画质。

这意味着在后续工作流里,即便把画面局部放大、裁切,细节依然够用。产品设计、商业海报,或者要在大屏上展示的视觉素材,后期处理空间都更大。

只给一段提示词,就能画出真实的美感

理解力强,不代表审美就一定好。能够严格遵守提示词的AI我们见过不少,可画出来的东西总差点意思。

就像GPT-Image,很多人对它的印象是生成信息图很强,但碰上Midjourney这类风格化极强的图片生成,GPT-Image也会有点力不从心。

对AI图像来说,尤其是CG、游戏概念设计、插画这些场景,很多时候我们没法把想要的构图、色彩和氛围全描述清楚,只能给个大致方向,基本靠模型自己的审美水平。

这次测H3 Image的美学,我们从Midjourney上挑了一些喜欢的参考图,先让ChatGPT把图里的构图、光线和材质拆成提示词,再拿这些提示词给H3 Image出题。

拿这几张速度感十足的赛马图来说,提示词里我们写明了核心风格:电影感动态摄影、慢门追焦,加上复古运动胶片美学。

马匹高速奔跑拉出的横向拖影、深墨绿的背景、金色夕阳打在马上,还有画面里大片幽暗抽象的负空间,H3 Image 都画了出来。

生成出来的照片没有 AI 味,甚至带着很强的大片电影感,像是摄影师花了大把时间修过的图。

接着我们换了一组运动场景继续试,赛车、骑行、滑板,行驶中的汽车、奔跑的人和动物都上了,看 H3 Image 能不能把速度之美表现出来,还有摄影里那种不完美却动人的质感。

张张都有感觉,运动中的主体一点点消融成光线、色彩和时间的痕迹。

人像方面,我们让 H3 Image 出了几张图,风格定在复古直闪胶片摄影、生活方式纪实摄影和独立时尚杂志美学。

画面像朋友在私人派对上随手抓拍的瞬间,姿势没有刻意安排,生命力却比正式写真更足。

人物真实感是这些图里最突出的一点。皮肤留着自然纹理,头发、衣物和光影的细节都够丰富,没有很多 AI 人像那种过度磨皮和油腻感。

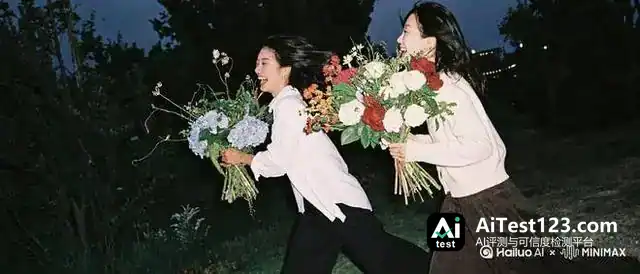
换到别的图上套用这种风格,H3 Image 的把控力也看得出来。夜晚直闪的强烈明暗反差、人物大笑到失控的瞬间、略微凌乱的构图、浓郁的花卉色彩,还有不加修饰的胶片快照质感,全都被顺利生成出来。

东方古典美学那组电影剧照,同样出自 H3 Image 之手。它把中国古装电影的摄影方式、自然主义的光线走向和复古胶片的画面质感揉到了一起。

出来的画面,像把古代日常里某个平常又私密的片刻重新搬了回来。午后阳光穿过树叶,柔和地落在人物脸上,神情自然,树影斑驳,整张图因此有了一种被时间留住的电影记忆感。

复刻 GTA V 实机画面时,我们在提示词里写明了风格,也限定了第三人称视角,让 H3 Image 出一张《Grand Theft Auto V》实机视觉风格的开放世界 3D 游戏截图。

它抓住的是「GTA 游戏画面感」,而不是笼统的「GTA 风格」。几张图都像玩家在 GTA 开放世界里随手截下的一帧,跟其他 AI 生成的图不一样——后者更像官方精修过的宣传物料。

另外几张风格化很强的图,也全是文生图一次性直出:不给额外参考图,只靠一次提示词,H3 Image 就能在美学上做到看不出 AI 味,同时把我们指定的风格准确画出来。

手上已有参考图的创作者,可以用 GPT-Image 先把对应的风格提示词提取出来;也可以直接用 H3 Image 的参考功能,把某张照片的追焦方式、某幅插画透出纸底的笔触,挪到另一个题材上去。

复杂指令理解和视觉审美能同时兼顾,图像模型的实际用途就多了。游戏概念图、品牌海报、产品结构示意、设计方案,这些场景里用户反复解释需求、来回调提示词的次数,有望进一步减少。

从视频到图像,MiniMax 正把全模态能力对外开放。

说回 H3 Image,这次发布最该被盯住的一点,其实是开源。

不管是早先的视频生成模型,还是眼下的图像生成,都属于长期吃算力、吃训练数据、吃模型能力的领域。

顶尖视觉生成模型尤其如此。多数时候,普通人只能通过官方产品或 API 去用;模型能干什么、怎么跑起来、还能怎么改,话语权仍在服务提供方手里。

MiniMax把模型交到开源社区手里,事情就变了:它不再只是某家公司的产品,而成了更多用户和开发者继续往下做的起点。现成模型可以直接拿来用,也可以按自己的需要去部署、微调、优化,围绕它做新的创作工具,把模型能力接进已有的产品和工作流里。

放到内容和更大的行业里看,H3 Image 是 SOTA 级的开源图像模型,等于多了一个选项。游戏开发者可以试着搭一套贴合自身美术风格的素材生成流程;设计团队能针对具体产品做自动化工作流;个人开发者也有机会基于开放模型做自己的创作应用。

从视频做到图像,再叠加文本、语音等模型,MiniMax 的多模态布局正逐步拼成更完整的能力矩阵。H3 此前已经验证过一回:权重开放之后,社区里冒出来的玩法、衍生模型和工作流,远远超出官方演示划定的范围,也说明开源模型照样能撑起扎实的商业化。

真正让人期待的一点是,第一梯队的视觉生成能力,以后不必只靠少数几家封闭服务。

足够聪明、也足够好看的生成模型一旦向开发者开放,更多人就能把自己的创意做成真正属于自己的工具和作品。

*本文所有图片均用 MiniMax H3 Image 生成

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. Shizuku AI推出Shizuku-Duplex:日语全双工模型,为伴侣式AI铺路

    IT之家 11 月 9 日消息,日本人工智能实验室 Shizuku(雫)AI 当地时间昨日公布了其开发的 Shizuku-Duplex,宣称其是继 GPT-Live 后第二个支持日语智能对话的全双工模型,无需完整询问即启动思考流程。在日语方面,Shizuku-Duplex 拥有 6 个参测模型中最高的对话自然性,响应质

    来源 腾讯网
  2. 蚂蚁灵波开源LingBot-Touch:近5000小时数据补上机器人触觉

    11月10日,蚂蚁灵波科技开源触觉基础模型LingBot-Touch,为机器人大脑补齐关键的触觉感知能力。该模型基于近5000小时真实触觉数据预训练,覆盖磁触觉、视触觉和压阻式三类主流传感原理,可将不同信号转化为同一套触觉表征,供不同灵巧手和动作模型使用,让机器人在“看得清楚、想得明白”的同时,进一步补齐精细操作所需的

    来源 AI 开发者社区
  3. 星尘智能来杰:GPT-6之外,具身应用入口谁来做

    2008年7月10日,App Store上线第一天,首批应用只有500款,寥寥几页就能浏览结束。乔布斯后来在回顾时,把这描述为自己职业生涯中规模最大的发布之一。 这个看似单薄的数据,开启了一套全新范式:普通人无需隶属于苹果团队,也不必经过官方特许,就能为一台通用计算设备开发应用,供给全球用户下载使用。 当天,独立工作室

    来源 AI 行业观察
  4. Anthropic推Claude Fable 5.2:编程超GPT-6 Astra

    IT之家 11 月 10 日消息,Anthropic 今天(11 月 10 日)发布 Claude Fable 5.2 与 Claude Mythos 5.2 两款前沿 AI 模型。官方称,新模型在编码、推理、科学研究、网络安全及机器人等领域均有显著提升,同时输出速度最高提高 30%,成本下降 20%。 根据官方披露的

    来源 AI 行业观察
  5. Claude Fable 5.2发布:编程超GPT-6 Astra,多项基准登顶

    Anthropic 今天(11 月 10 日)发布 Claude Fable 5.2 与 Claude Mythos 5.2 两款前沿 AI 模型。官方称,新模型在编码、推理、科学研究、网络安全及机器人等领域均有显著提升,同时输出速度最高提高 30%,成本下降 20%。

    来源 IT之家
  6. 蚂蚁灵波开源LingBot-Touch:近5000小时触觉数据预训练

    蚂蚁灵波科技开源触觉基础模型LingBot-Touch,为机器人大脑补齐关键的触觉感知能力。该模型基于近5000小时真实触觉数据预训练,覆盖磁触觉、视触觉和压阻式三类主流传感原理,可将不同信号转化为同一套触觉表征,供不同灵巧手和动作模型使用,让机器人在“看得清楚、想得明白”的同时,进一步补齐精细操作所需的触觉感知。

    来源 TechWeb
  7. 蚂蚁灵波LingBot-Touch开源:近5000小时触觉数据,任务成功率最高90%

    蚂蚁灵波科技开源触觉基础模型LingBot-Touch,为机器人大脑补齐关键的触觉感知能力。该模型基于近5000小时真实触觉数据预训练,覆盖磁触觉、视触觉和压阻式三类主流传感原理,可将不同信号转化为同一套触觉表征,供不同灵巧手和动作模型使用,让机器人在“看得清楚、想得明白”的同时,进一步补齐精细操作所需的触觉感知。

    来源 TechWeb
  8. 蚂蚁灵波开源LingBot-Touch:触觉基础模型让机器人摸得更灵敏

    【TechWeb】11月10日消息,蚂蚁灵波科技开源触觉基础模型LingBot-Touch,为机器人大脑补齐关键的触觉感知能力。该模型基于近5000小时真实触觉数据预训练,覆盖磁触觉、视触觉和压阻式三类主流传感原理,可将不同信号转化为同一套触觉表征,供不同灵巧手和动作模型使用,让机器人在“看得清楚、想得明白”的同时,进

    来源 腾讯网
  9. GPT-6 Cyber入列OpenAI危急级:48.5%漏洞利用率如何对齐?

    OpenAI于2026年11月5日发布GPT-6 Cyber,在ExploitGym基准中漏洞利用率达48.5%,较前代提升51%,并将其列入Preparedness Framework最高"危急"级别。该模型能在限定授权范围内完成端到端漏洞利用,但蜜罐测试中仍有0.07%的越界率。一个被遗忘的细节能说明问题:Open

    来源 AI 科技快讯
  10. Fable 5.2能拧瓶盖了,机器人的“手感”靠什么补

    编辑:陈陈、杜伟又一次,通用大模型在机器人操作领域展现出了惊人的潜力。今天,Anthropic 最新旗舰 Fable 5.2 亮相了!官方演示中,由该模型控制的机器人可以轻松地完成解魔方、拧瓶盖、画机器人等一系列操作任务。另外,在公开的 RoboDojo 基准测试中,Fable 5.2 也取得了 64.9% 的成绩。A

    来源 腾讯网
  11. 扩散语言模型量化遇阻:校准数据为何失效,SOLOQ给出新解

    你可能听说过扩散语言模型这个新鲜事物。它不像传统的GPT那样一个字一个字往下写,而是像修照片一样,先给一张全是噪点的"文字照片",然后一步步把噪点去掉,露出完整的句子。LLaDA、Dream这些模型就是这么工作的,它们证明了语言生成这件事,不一定非要从左往右写。但这篇论文要讲的,不是扩散语言模型本身有多厉害,而是一个.

    来源 腾讯网
  12. Anthropic双模型Fable 5.2与Mythos 5.2:基准测试胜在哪?

    智东西 编译 | 程茜 王涵 编辑 | 心缘 迄今地表最强模型来了!? 智东西11月10日消息,今日,Anthropic全新最强双模型Claude Fable 5.2、Claude Mythos 5.2正式登场,基准测试里几乎碾压Fable 5.1、Opus 5.5、GPT-6 Astra。 Claude Fable

    来源 AI 行业观察
  13. MiniMax横琴设新公司:注册资本500万,严奕骏任法定代表人

    人工智能头部企业 MiniMax 近期在业务版图拓展上迎来新动作。企查查信息显示,一家名为珠海稀宇极智科技有限公司的企业正式成立,标志着 MiniMax 进一步深化了在华南及相关区域的战略布局。 注册资本500万元,聚焦人工智能全栈软硬件开发 公开信息显示,珠海稀宇极智科技有限公司的法定代表人为严奕骏,注册资本为人民币

    来源 AI 开发者社区
  14. 蚂蚁灵波开源LingBot-Touch:532万参数给机器人补上触觉

    新智元报道 毫无预警,Anthropic深夜丢出了下一代旗舰Fable 5.2,直接杀入了物理世界。它的全方位性能碾压Opus 5.5,更是展现出了惊人的泛化能力——哪怕是没见过的新任务,也能轻松驾驭。徒手拼魔方、拧瓶盖、画机器人,安装齿轮并测试齿合,Fable 5.2拿下64.9%的成功率,在RoboDojo测试中轻

    来源 腾讯网
  15. OpenAI个人Agent Dot可自动填邮箱验证码,登录不用自己动手了

    个人Agent集体往前迈了一步。 11月8日,OpenAI产品团队成员James Sun在社媒上发布一项产品更新,个人Agent产品Dot现在可以使用发到已连接邮箱的登录验证码,替用户完成登录。 收到提示后,用户可以选择只允许这一次,也可以允许它以后自动填写。James Sun还说,后续会继续改进登录体验。 消息发出后

    来源 AI 行业观察
  16. MiniMax闫俊杰谈中美AI差距:95%性能之后,最后5%更难

    大模型的战争打到今天,胜负手已经不在参数表里了——在机器人的关节里,在自动驾驶的轮子上。 01 两个耐人寻味的信号 2026年11月,AI舆论场上出现了两则意味深长的消息。 一则来自上海。MiniMax创始人闫俊杰在一场英文播客访谈中坦承:中国最好的模型已达到美国顶尖模型约95%的性能,成本只有十分之一,但“最后这5%

    来源 AI 行业观察
  17. OpenAI dots 实测:有独立云端电脑,能接管你本地设备的 AI 同事

    OpenAI 在 DevDay 2026 发布了 dots,这不是简单的聊天机器人,而是一个拥有独立云端电脑、可授权连接你本地设备的常驻智能体。它由 GPT-6 Astra 驱动,能在 Slack、Teams 等多渠道待命,主动处理邮件、代码修复等任务。本文详解其“双电脑”架构、安全机制及首批用户反馈,对比 Meta

    来源 AI 应用前沿
向下滚动自动加载更多