

MiniMax H3 Image开源:4K生图10秒出,最多吃16张参考图
4K 像素最快 10 秒生成 #欢迎关注爱范儿官方微信公众号:爱范儿(微信号:ifanr),更多精彩内容第一时间为您奉上。
今年 8 月, MiniMax 把 H3 视频生成模型的权重放了出来,这是史上首个达到 SOTA 水平的开源视频模型。接下来几个月,社区拿它玩出的花样远远超出官方演示,H3 max 等一批衍生模型也跟着冒出来,AI 创意行业确实被往前推了一步。
眼下,图像生成模型 MiniMax 也不准备捂着了。MiniMax H3 Image 刚刚正式发布,主打图像生成与编辑,瞄准的是开源图像模型里的 SOTA。
早前的 H3 靠统一的全模态预训练,已经能理解并生成图像、视频、音频等内容,文生图和图像编辑也在其中。H3 Image 则是在这套底子上,针对图像生成与编辑再做后训练优化,复杂指令遵循、图像细节和视觉审美因此有了更好的表现。
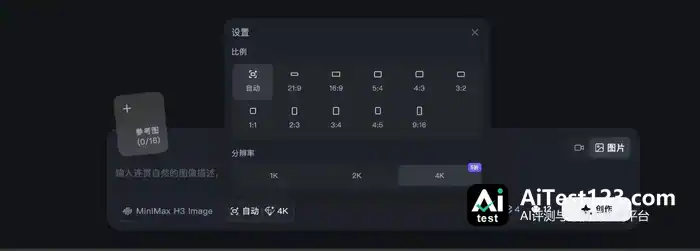
分辨率和速度是能直接感受到的两项。我们实测下来,H3 Image 出一张 4096×4096、4K 画质的高规格图片,只要 10~20 秒。
过去高分辨率生图动辄要等几十秒甚至更久,现在十几秒就能完成。4K 级图像生成正迈入以十秒计的时代,高分辨率带来的细节优势,也能用在更频繁的日常创作里了。
我们用 H3 Image 生成了一批颇具美学的图片,CG、游戏场景、工业设计以及多种艺术风格,它都拿得出手。
复杂指令遵循是它重点强化的方向,最多支持 16 张参考图片,不同的主体、材质和风格要求可以同时理解。
更关键的是,H3 Image 发布当天就开放了权重。开发者能通过 API 接入,也能在 MiniMax 开放平台、MCode 和 MiniMax 海螺平台里使用。
APPSO 提前试了这款新模型。画得好看之外,我们更想弄清楚:它到底能理解多复杂的需求,图像细节又能做到什么程度。
复杂的需求,也能准确画出来
以往测图像模型,我们大多盯着它能不能画出提示词里提到的物体。
可实际工作里,交给设计师的需求常常复杂得多。产品的零件该怎么组装,某个区域要保留哪些元素,不同参考图之间又有什么联系,模型得先把这些条件理解清楚,才有可能画对图。
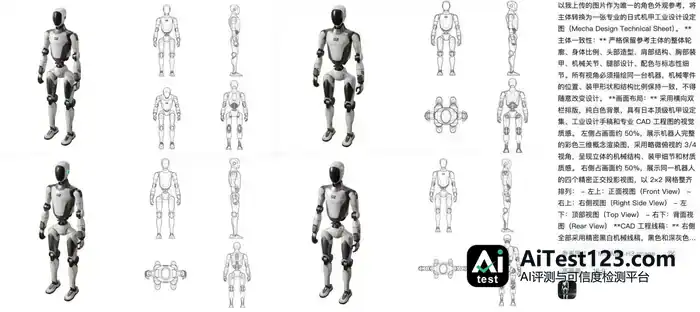
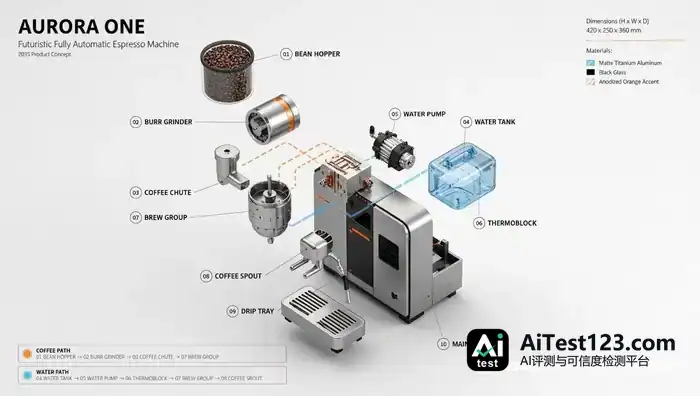
这回我们挑了个工业产品的结构设计,让 H3 Image 画一台未来主义咖啡机的产品爆炸图。豆仓、研磨器、冲煮模块、水箱等结构都要展示出来,各部分的连接关系要标清,产品设计的一致性也得保住。
机械结构之外,文字处理也是图像生成模型常碰上的硬骨头。字要写对,字体设计、画面构图和整体视觉效果还得兼顾。
大字海报上,模型得同时处理文字内容、字体造型和视觉构图。轮到包含大段小字的场景,文字准确性、信息层级和排版又成了新难题。
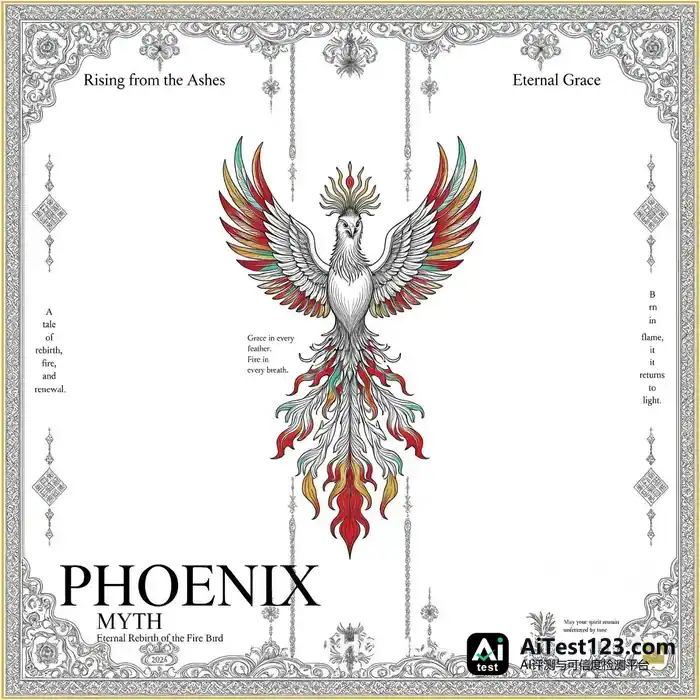
我们先让 H3 Image 出一张以凤凰(Phoenix)为主题的新古典主义装饰艺术海报,里面融合了西方神话、复古雕版画、维多利亚时代装饰纹样和现代极简排版。
画面标题 PHOENIX MYTH(凤凰神话)和副标题 Eternal Rebirth of the Fire Bird(火鸟的永恒重生),H3 Image 都准确渲染了出来。
H3 Image 在小字上表现如何,我们找来这段时间沸沸扬扬的黄仁勋公开信,让它生成一份放在桌面的信纸版。
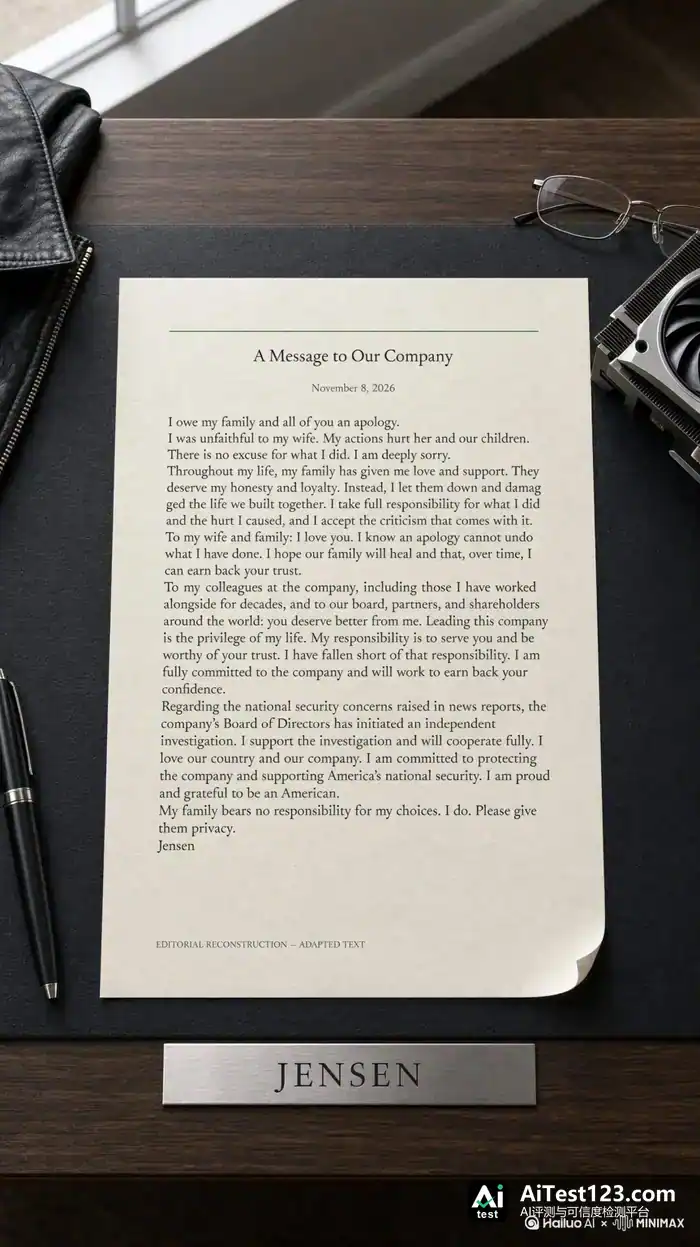
图里的文字基本都准确生成了,没有明显错误,整体样式也和图片周围的风格对得上。仔细看信纸周围的细节,都和老黄有关。
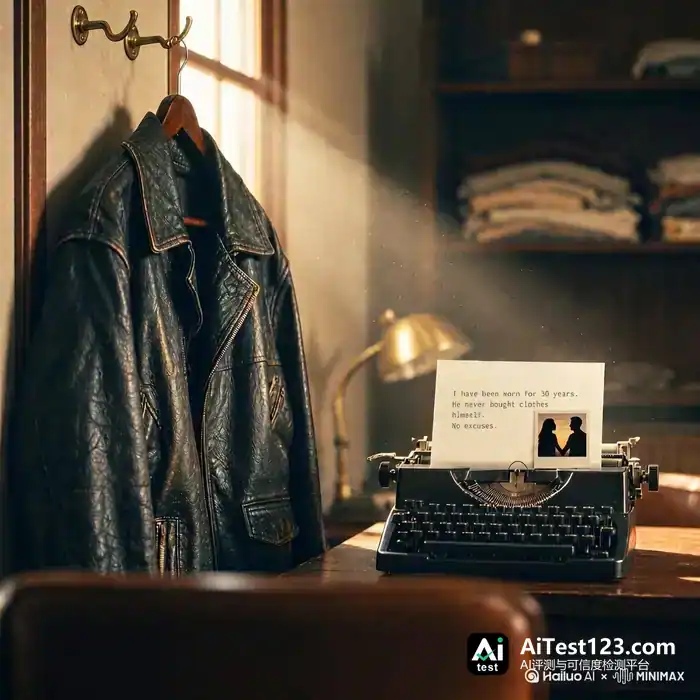
怀旧风的场景也能生成:墙上挂着一件经典皮衣,旁边打字机上是一句独白「我已经被穿了 30 年了。」
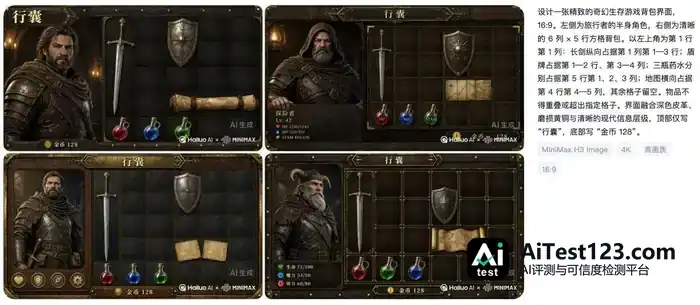
我们又让 H3 Image 生成更复杂的游戏界面,图里的文字渲染和布局都接近生存游戏,生命、魔力和体力等级都有显示。
再进一步,就看 Image 能不能理清文字与图片之间的逻辑。这要求它具备语义理解能力,还得有科学、数学、生物等知识,并且把逻辑准确、美观地呈现出来。

机械结构、文字排版、知识理解,这几类案例说到底都指向同一件事:模型能不能真正吃透用户想表达的东西,再把它准确变成图像。
这一回 H3 Image 最多能接 16 张图片当参考。换句话说,产品的不同视角、材质参考、品牌元素和场景图可以一次性喂进去,再让模型把这些信息揉进同一张作品里。
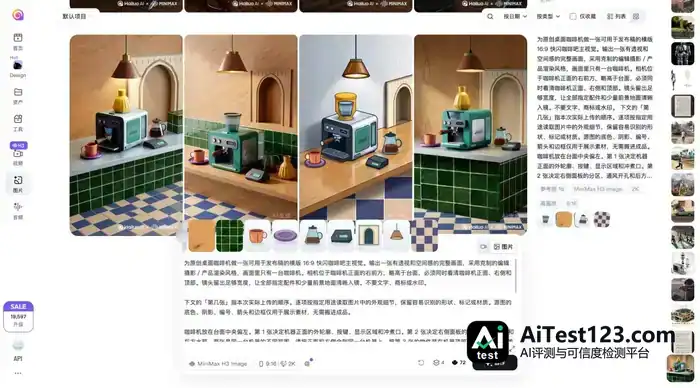
还有一点更让人期待:H3 Image 能通过 API 接进 MiniMax Code、Claude Code、Codex 这些 Agent Harness,直接参与到更复杂的任务流程中。
也就是说,创作需求可以直接在 Agent 的对话框里提,让 Agent 整理任务、调用 H3 Image 出图,再靠后续对话一轮轮改设计。


向左滑动查看更多内容
比如这个在 Codex 里用 MiniMax H3 Image 生成 V8 引擎爆炸拆解图的案例,Agent 先把信息搜集整理好,最后出来的几张拆解图都相当真实。
向左滑动查看更多内容
对 Agent 而言,它得持续管好上下文和用户的修改意见;对 H3 Image 而言,则要读懂 Agent 整理后的复杂指令,并尽量准确地执行。这种工作方式,对图像模型的指令遵循和复杂信息理解能力提出了更高要求。
而 H3 Image 这款开源图像生成模型确实做到了理解复杂需求、执行精确修改,并在连续创作中保持一致性,它也由此开始真正融入 Agent 工作流。
尤其是眼下不少主流生图模型还停留在百万像素或四百万像素,H3 Image 却能直接生成 4096×4096 的超高清画面,像素数量达到 4K 画质。
这意味着在后续工作流里,哪怕把画面局部放大、裁切,细节依然够用。产品设计、商业海报,还是需要在大屏上展示的视觉素材,后期处理空间都更大了。
只靠一段提示词,就能画出真实的美感
理解力强不代表审美就好,能严格遵守提示词的 AI 我们见过不少,画出来的东西却总差点意思。
像  GPT-Image,很多人对它的印象是生成信息图很强,但碰上 Midjourney 这类风格化极强的图片生成,它也会有点力不从心。
而对 AI 图像来说,CG、游戏概念设计、插画这些场景里,很多时候我们没法把想要的构图、色彩和氛围全描述清楚,只能给个大致方向,基本靠模型自己的审美水平。
这次测 H3 Image 的美学,我们从 Midjourney 上挑了一些喜欢的参考图,先让 ChatGPT 把图里的构图、光线和材质拆成提示词,再拿这些提示词给 H3 Image 出题。
向左滑动查看更多内容
例如这几张充满速度感的赛马图片,提示词里我们明确了核心风格:电影感动态摄影、慢门追焦摄影和复古运动胶片美学。
赛马高速奔跑产生的横向拖影、深墨绿色的背景、金色夕阳照亮的马匹,以及画面中大面积幽暗、抽象的负空间,H3 Image 都能准确描绘出来。
不用说没有 AI 味,看到这些照片被生成时,甚至还有很强的大片电影感,像是摄影摄像师花大量时间修出来的图。
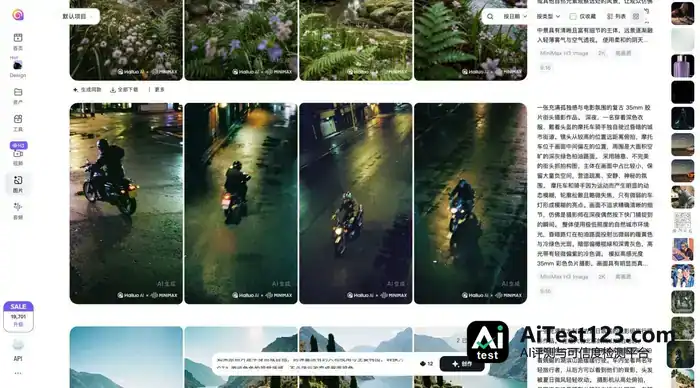
我们接着用这组提示词测试不同的运动场景,赛车、骑行、滑板,到行驶的汽车、奔跑的人和动物,看 H3 Image 能否呈现速度之美,以及摄影中那种不完美、但动人的质感。
继续滑动可看更多图。画面里,运动中的主体一点点化开,变成光线、色彩和时间留下的痕迹,每一张都挺有感觉。
再往下滑还有更多。人像这块,我们让 H3 Image 出了几张图,走的是复古直闪胶片摄影、生活方式纪实摄影加独立时尚杂志美学混在一起的路子。
出来的画面像朋友在私人派对上顺手按下的那一下,姿势没经过安排,活力反倒比正式写真足。
人物真实感是这批图里最突出的地方。皮肤留着自然纹理,头发、衣物、光影的细节也够多,很多 AI 人像那种磨皮过头、发腻的质感在这里没出现。
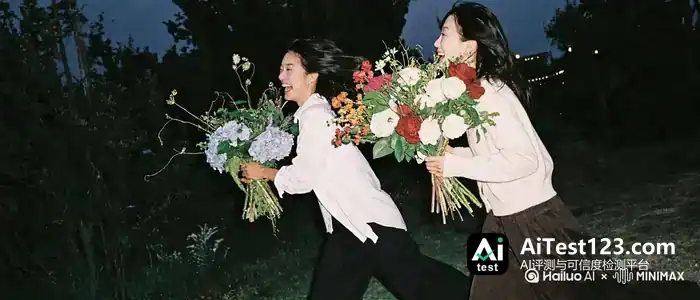
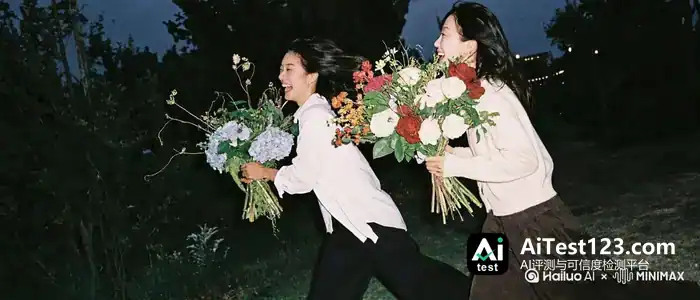
滑动查看更多内容。把这套风格搬到别的图上,H3 Image 对风格的控制力同样看得出来:夜晚直闪造成的强烈明暗反差、人物大笑到失控的瞬间、稍显凌乱的构图、浓烈的花卉色彩,还有不加修饰的胶片快照味道,都顺利生成出来了。
向左滑还有更多图。同类的还有人像,是我们用 H3 Image 生成的一张电影剧照,东方古典美学味道很足,中国古装电影摄影、自然主义光影和复古胶片的视觉质感揉在了一起。
画面里像是把古时生活某个平常又亲近的片刻定格了下来。午后阳光穿过树叶,落在人物脸上,神情自然,树影斑驳,整张图成了一段被时间存下来的电影记忆。
复刻 GTA V 实机画面时,我们在提示词里写明了风格和第三人称视角,让 H3 Image 出一张《Grand Theft Auto V》实机视觉风格的开放世界 3D 游戏截图。
向左滑动查看更多内容
它读懂了我们要的是「GTA 游戏画面感」,不是笼统的「GTA 风格」。几张图都像玩家在 GTA 开放世界里随手截下的一帧,跟别的 AI 生成图不一样——那些更像官方精修过的宣传图。
我们还试了几张风格感很强的图。全部是文生图一次性直出,没有额外图片参考,只给一次提示词,H3 Image 就能在美学上做到没有 AI 味,同时把我们点名的风格准确画出来。
手里已经有参考图的创作者,可以先用 GPT-Image 提取对应的风格提示词;也可以直接用 H3 Image 的参考功能,借某张照片的追焦方式,或者一幅插画透出纸底的笔触,再挪到另一个题材上。
复杂指令理解和视觉审美能同时顾上,图像模型的用处就多了。游戏概念图、品牌海报、产品结构示意、设计方案,用户反复解释需求、来回调提示词的次数,有望再少一些。
从视频到图像,MiniMax 正在把全模态能力开放出去
说回 H3 Image,这次发布最该关注的点,大概就是开源。
不管是早先的视频生成模型,还是如今的图像生成,向来都是对算力、训练数据和模型能力要求极高的领域。
顶尖视觉生成模型尤其如此,多数时候只能用官方产品或 API。模型能干什么、怎么跑、还能怎么改,决定权仍在服务提供方手里。
开源之后,模型不再只是一家公司的产品,而成了更多用户和开发者继续创作的起点。他们能直接用现成模型,也能按自己的需求部署、微调、优化,围绕它做新的创作工具,把模型能力接进现有的产品和工作流。
对内容行业和更大范围来说,H3 Image 作为一款 SOTA 的开源图像模型,多给了一个选项。游戏开发者可以试着搭建符合自家美术风格的素材生成流程,设计团队能针对特定产品做自动化工作流,个人开发者也有机会围绕开放模型做自己的创作应用。
视频、图像,再加上文本、语音等模型,MiniMax 的多模态布局正一步步拼成更完整的能力矩阵。H3 此前已经验证过一回:权重放开后,社区冒出的玩法、衍生模型和工作流,远超官方演示的边界,也说明开源模型撑得起扎实的商业化。
对我们而言,最值得盼的是第一梯队的视觉生成能力,不再只能靠少数几家封闭服务。
足够聪明、足够好看的生成模型也能交到开发者手上,更多人就有机会把创意做成真正属于自己的工具和作品。
*本文所有图片均用 MiniMax H3 Image 生成














