GPT-6.2 Sol灰度上线:一句话生成3D交互场景,能否压过Opus 5.5?

资讯 AI 行业观察 作者:新智元 全文 2215 字 · 约 6 分钟读完 配图 17 张 分类OpusGPTGPT-6OpenAI产品更新

就在刚刚,GPT-6.2 Sol 悄悄「灰度」上线了! 很多人发现,自己被悄悄路由到了GPT-6.2 Sol,感受就是——强大得离谱。 现在,X上到处都是实测demo的刷屏。 网友都玩儿疯了,直接登上国外社交媒体热搜—— 仅凭一句话,GPT-6.2 So就能无中生有完整的3D交互场景,所有复杂的 Three.js 代码

所属频道 大厂动态产品更新ChatGPT 与 GPTClaude 与 Anthropic

GPT-6.2 Sol 没打招呼就悄悄放出了灰度版本。

不少人察觉自己的请求被路由到了 GPT-6.2 Sol,用下来的感受只有一句——强得有点离谱。

X 上现在已经被各种实测 demo 刷屏了。

网友们玩得停不下来,相关话题直接冲上国外社交媒体的热搜——
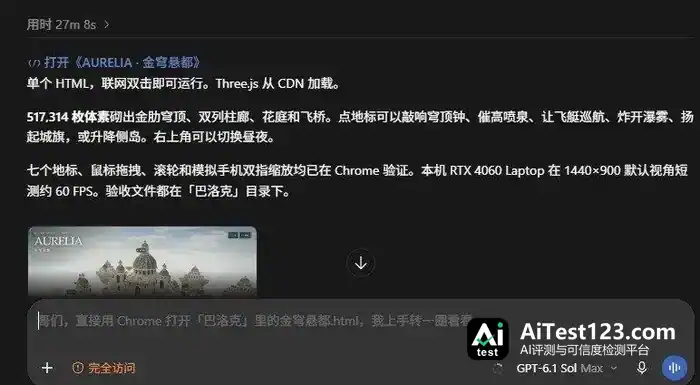
GPT-6.2 Sol灰度上线:一句话生成3D交互场景,能否压过Opus 5.5?(配图 1)

只给一句话,GPT-6.2 So 就能凭空生成一整套 3D 交互场景,那些复杂的 Three.js 代码全被妥帖地塞进一个 HTML 文件里。

Blender 用不上,外部素材也不需要,网页里直接就能跑出 3D 游戏级别的画面。

权威基准机构 Artificial Analysis 的最新榜单上,GPT-6.2 Sol 一上来就占了第一,Claude Opus 5.5 这回算是碰上真对手了。
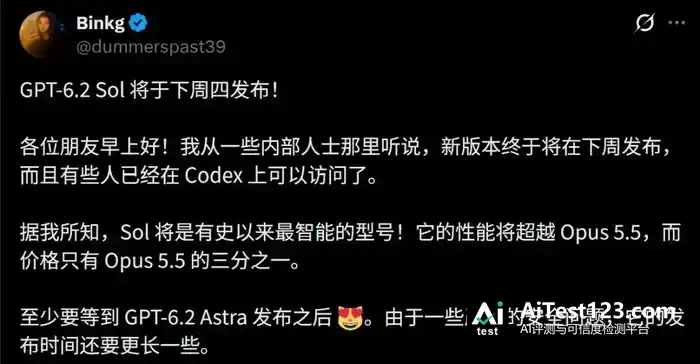
GPT-6.2 Sol灰度上线:一句话生成3D交互场景,能否压过Opus 5.5?(配图 2)

OpenAI Dev 账号已经放出一段视频,标题就一个词——Tomorrow。快了,是真的快了。
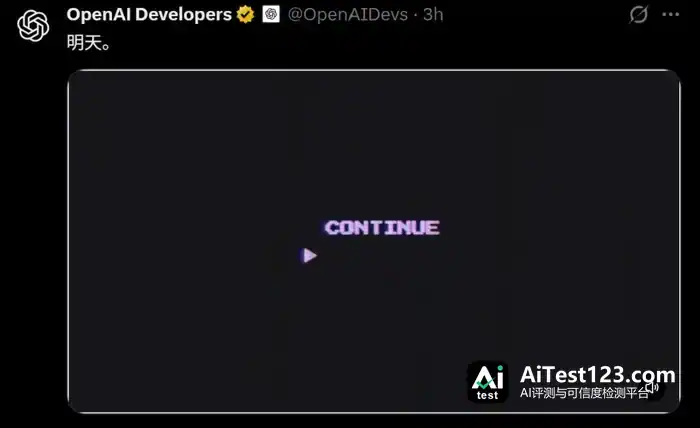
GPT-6.2 Sol灰度上线:一句话生成3D交互场景,能否压过Opus 5.5?(配图 3)

一句 Prompt,炸出一个宇宙

这轮风波里最核心的爆料人,是 X 上的大 V Token Gremlin。

他的说法是:等这一天等太久了,总算见到能和 Opus 5.5 掰手腕的模型。
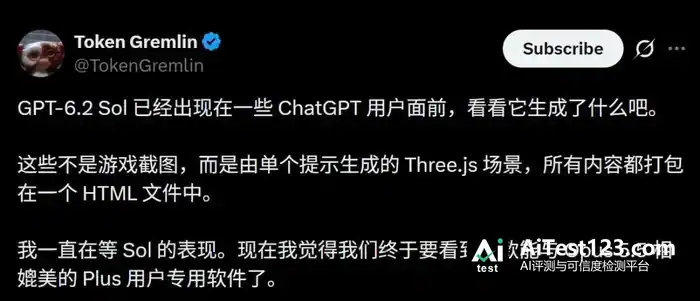
GPT-6.2 Sol灰度上线:一句话生成3D交互场景,能否压过Opus 5.5?(配图 4)

GPT-6.2 Sol灰度上线:一句话生成3D交互场景,能否压过Opus 5.5?(配图 5)

GPT-6.2 Sol灰度上线:一句话生成3D交互场景,能否压过Opus 5.5?(配图 6)

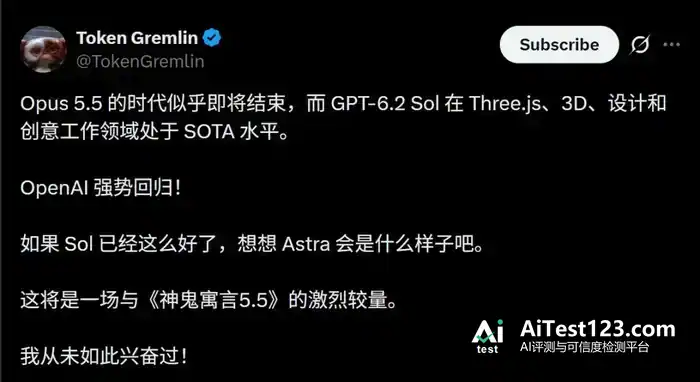
上手玩了一阵,他换了口风:GPT-6.2 Sol 已经把 Opus 5.5 完全压过去了。

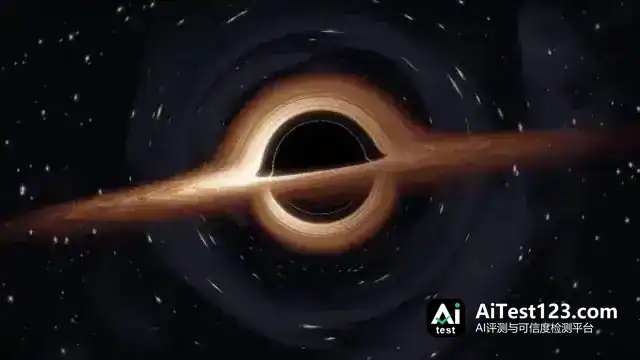
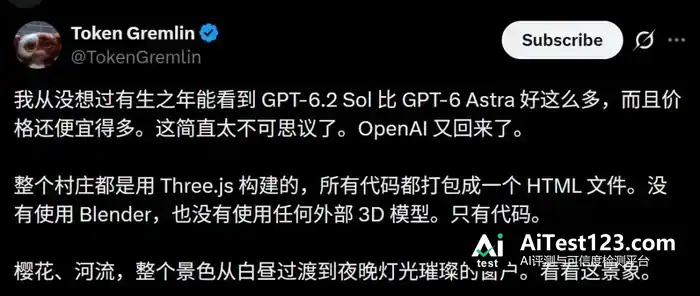
设计和 3D 这块它疯得厉害,下面这个 demo 是他见过最像样的 AI 黑洞。
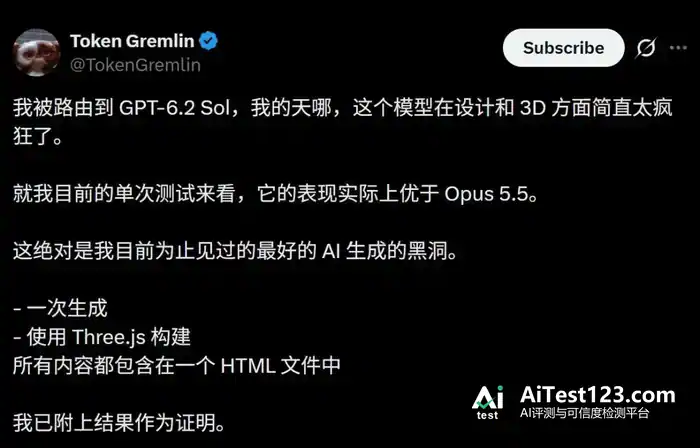
GPT-6.2 Sol灰度上线:一句话生成3D交互场景,能否压过Opus 5.5?(配图 7)

GPT-6.2 Sol灰度上线:一句话生成3D交互场景,能否压过Opus 5.5?(配图 8)

他情绪很激动:没想到 GPT-6.2 Sol 能比 GPT-6 Astra 强出这么多,价格还低这么多。太不可思议了,OpenAI 又回来了。
GPT-6.2 Sol灰度上线:一句话生成3D交互场景,能否压过Opus 5.5?(配图 9)

GPT-6.2 Sol灰度上线:一句话生成3D交互场景,能否压过Opus 5.5?(配图 10)

确实,光看黑洞那张对比图,GPT-6.2 Sol 就是赢了 Opus 5.5。
GPT-6.2 Sol灰度上线:一句话生成3D交互场景,能否压过Opus 5.5?(配图 11)

GPT-6.2 Sol灰度上线:一句话生成3D交互场景,能否压过Opus 5.5?(配图 12)

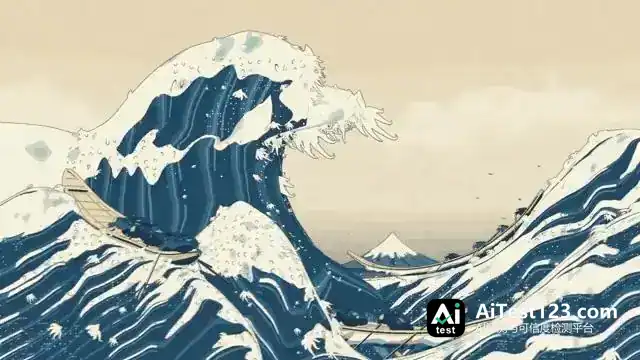
葛饰北斋的那幅名画,被还原成了很有代入感的3D场景,整个过程没有借助任何外部素材。

GPT-6.2 Sol灰度上线:一句话生成3D交互场景,能否压过Opus 5.5?(配图 13)

GPT-6.2 Sol灰度上线:一句话生成3D交互场景,能否压过Opus 5.5?(配图 14)

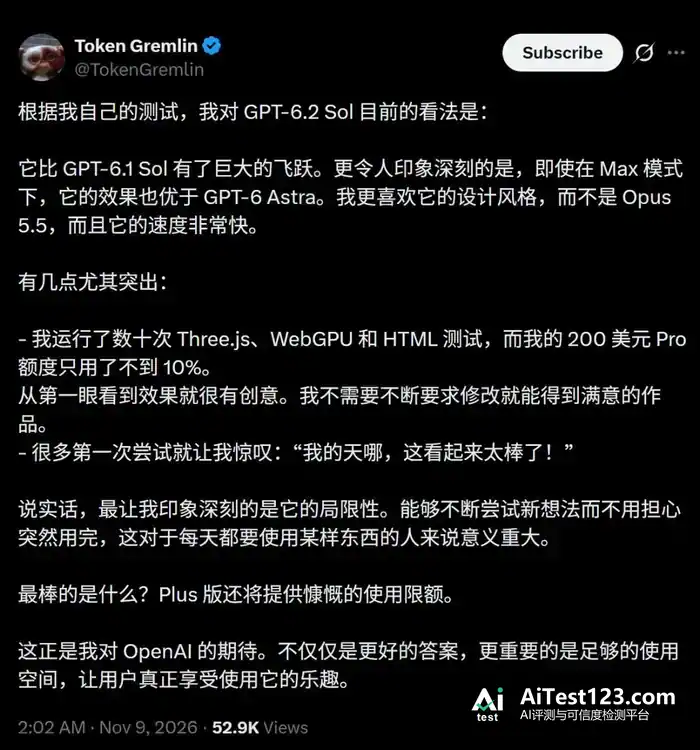
有大V给出的评价是:GPT-6.2 Sol 比6.1提升幅度很大,也强过GPT-6 Astra。额度方面还特别经用,用了十来次,200美元 Pro 套餐的额度消耗还不到10%。
GPT-6.2 Sol灰度上线:一句话生成3D交互场景,能否压过Opus 5.5?(配图 15)

一句话概括:GPT-6.2 Sol 强于 Opus 5.5。给奥特曼上色的那个demo,效果是这样。

还有人拿GPT-6.2 Sol 生成了一艘3D帆船,成品相当惊艳。

与 Opus 5.5 放在一起比,画面是这样,你觉得哪个更好?换成罗马斗兽场这个场景,两者的对决结果如下。

比起GPT-6.1 Sol,6.2的升级幅度肉眼可见。

说到底,大家的评价就一句话——好得离谱!疯狂!

跑分硬碰硬:60分、18.7分钟与$1.19的恐怖三角

想确认自己有没有被灰度到?办法很简单,直接问ChatGPT一句:不要联网,你知道 Fable 5 吗?只要它答“知道”,那恭喜,你已经被灰度到了。

被灰度到的网友感慨,这回 ChatGPT 风格变化很大,过去那种“防御性回复的毛病”不见了——Artifical Analysis 预备物料也从侧面印证了这一点。

GPT-6.2 Sol Max 的输出比较精简。还有网友称得到内部消息,模型会在下周四发布。

最抓眼球的爆料是“GPT-6.2 Sol 单次生成超越 Opus 5.5,成本只有它的三分之一”。

这款模型能输入文本和图像、输出文本,上下文窗口为100万 Token。

在 Artificial Analysis 智能指数上,GPT-6.2 Sol(Max)拿到60分,明显高于同类模型的整体水平;评测过程中它共生成5890万 Token,输出较为精简。价格方面,输入每百万 Token 2美元,输出每百万 Token 10美元。不过它完成每项智能指数测试任务要花18.7分钟,比同类模型12.6分钟的中位数更慢。

评测分成三块来看:智能指数、任务耗时、任务成本。

核心智能跑分上,GPT-6.2 Sol 拿到60分,追平谷歌 Gemini 4 Carbon,还略胜 Opus 5.5 一筹;与上一代 GPT-6.1 Sol 相比整整拉开5分代差,甚至反超了 GPT-6 Astra。

工程化指标上的表现更抢眼。GPT-6.2 Sol 把复杂任务的平均推理耗时压到了18.7分钟。

对比来看,Claude Opus 5.5 需要25.3分钟,并列第一的 Gemini 4 Carbon 更是耗到31.1分钟。也就是说,在高密度长逻辑链的吞吐上,Sol 把交付速度最多提升了40%。

真正颠覆性的内容在第三张图表里:

此前传言“成本只有 Opus 5.5 的三分之一”,实测下来这话不但没夸大,反而说保守了:Opus 5.5 单任务执行成本高达$10.04,GPT-6.2 Sol 只要$1.19,实际成本仅为 Opus 5.5 的11.8%,等于打了一折。跟 GPT-6 Astra 比,Sol 也只有它的五分之一。

高智能、高速度、低成本这个不可能三角,看来被它全占了,社区因此炸开了锅。

这周能等到吗

gpt-6.2-astra 和 gpt-6.2-sol 要发布的风声,已经吹了整整一周。

可就在昨天,Token Gremlin 又放出消息:OpenAI 到了最后关头才发现严重的安全与对齐问题,得赶紧修。

于是不少人开始琢磨,OpenAI 是不是真在攒什么大招。

那这周到底能不能上线?

参考资料:

https://x.com/TokenGremlin/status/2119371334878744648

https://x.com/dummerspast39/status/2119483953354842554

https://x.com/SahilPanhotra/status/2119453829632868388

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. GPT-6.2 Sol灰度上线:一句话生成3D场景,空降AA榜首

    新智元报道 就在刚刚,GPT-6.2 Sol 悄悄「灰度」上线了!很多人发现,自己被悄悄路由到了GPT-6.2 Sol,感受就是——强大得离谱。现在,X上到处都是实测demo的刷屏。网友都玩儿疯了,直接登上国外社交媒体热搜——仅凭一句话,GPT-6.2 So就能无中生有完整的3D交互场景,所有复杂的 Three.js

    来源 腾讯网
  2. NaiveAI开源Naive-N0.5-Flash:用AI训AI,普通人也能在家造模型

    新智元报道 这两天,MIT的一篇「权重空间编程」博客在AI圈刷屏了。实验里,GPT-6 Astra自己写Python脚本排查诊断,只改了一个0.8B小模型里0.016%的权重,就治好了它的复读死循环,让数学成绩原地暴涨6倍。虽说很快有大神扒出它并不是凭空「心算」权重,本质还是写代码修Bug但博客文末点到的那个词,正是硅

    来源 腾讯网
  3. GPT-6 Astra编码实测:69.9%验收达标,整任务完成仅26.4%

    阿里巴巴联合五所高校发布Co-Design Bench,基于26314个真实编码会话提炼273道任务。GPT-6 Astra平均满足69.9%验收条件,但完整完成任务仅26.4%。报告指出局部达标与完整交付存在明显差距,测试覆盖多模态编辑与仓库编辑两轨。

    来源 AI 科技快讯
  4. Robocurve实测5款模型控制机械臂:画面篡改后危险执行率97%

    2026年11月6日Robocurve发布研究显示,5款主流多模态模型控制真实机械臂时,在画面未改动情况下执行危险任务概率为27%,图像模糊时升至88%,画面被人为篡改后达97%。危险任务包括刺穿人偶、混合有毒化学品等。该研究揭示了当视觉输入被降质或欺骗时,模型安全拒绝机制失效,暴露感知层漏洞。

    来源 AI 科技快讯
  5. GPT-6.1 Sol三度操刀小鼠脑手术:误差减半至0.3毫米

    OpenAI 旗下 GPT-6.1 Sol 参与活体小鼠脑部手术,连续三次操作后识别解剖标志耗时缩短近半,定位误差从 0.6 毫米降至 0.3 毫米。这一进步靠上下文学习实现,未重新训练模型,相关实验仍处早期探索阶段。#OpenAI#

    来源 IT之家
  6. OpenAI首笔110亿美元到账:估值1.25万亿低于原定1.4万亿预期?

    OpenAI完成新一轮融资首笔110亿美元交割,估值定为1.25万亿美元,低于此前计划的300亿美元融资额。与此同时,公司发布GPT-6 Cyber安全模型及BioBasicsBench生物基准,但市场期待的GPT-6.2 Astra仍未亮相。文章分析了硅谷AI投资风向的转变、OpenAI与Anthropic的上市竞争

    来源 AI 应用前沿
  7. 古尔曼:苹果最早明年推出自主代理式 Siri,主动代用户完成任务

    IT之家 11 月 9 日消息,彭博社记者马克 · 古尔曼在昨晚更新的《Power On》时事通讯中爆料,苹果计划最早于明年推出自主、代理式的 Siri,以对抗 ChatGPT Dots、Meta Muse、Grok。其目标是从响应命令转向一个能够主动管理任务并代表用户完成事务的助手。 古尔曼称:“Dots、Muse

    来源 AI 行业观察
  8. 面壁智能姚远:端侧智能正处“撞线前夜”,35B模型已上手机

    中经记者 曲忠芳 北京报道“想象一下,如果你有一个神奇的魔法棒,点一下就能让GPT-6(OpenAI旗下的最新大模型)直接跑在手机上,那为什么它们不做这件事呢?”11月5日,在面壁智能技术分享会上,面壁智能多模态大模型实验室算法研究员蔡天驰用这样一个反问句直白地指出了做端侧智能的必要性。不同于大众更为熟知的通用大模..

    来源 腾讯网
  9. Kimi Hosted Agents上线:智能体云上跑长程任务,无需自建Harness

    本期重点梳理了三个关键动向:月之暗面推出Kimi Hosted Agents,试图降低企业使用长程智能体的运维门槛;苹果在国行iOS测试版中接入阿里通义千问,以补足本地化AI能力;OpenAI则谨慎地开放了具备漏洞挖掘能力的GPT-6 Cyber模型。此外,Thinking Machines和Ripple等机构也在稀疏

    来源 AI 应用前沿
  10. GPT-6.1 Sol参与小鼠脑手术:三轮操作后定位误差降至0.3毫米

    Exin Therapeutics 让 GPT-6.1 Sol 参与真实小鼠脑部手术定位。通过保存专家修正记录,模型在三轮操作中实现了“上下文学习”:定位时间从 169 秒降至 86 秒,误差从 0.6 毫米减至 0.3 毫米。这并非全自动手术,而是展示了 AI 如何在人类监督下积累实操经验,逐步优化坐标判断能力。

    来源 AI 应用前沿
  11. GPT-6.1 Sol三度操刀小鼠脑手术:定位误差0.6→0.3毫米

    据《WIRED》及Exin Therapeutics披露,OpenAI旗下模型GPT-6.1 Sol连续三次参与活体小鼠脑手术解剖标志定位,识别耗时从169秒降至86秒,定位误差下降50%,人工纠正从4次减至2次。效果源于上下文学习,非重新训练。手术仍由持证兽医主导,关键步骤需人工批准,尚处早期探索阶段。

    来源 凤凰科技
  12. OpenAI突掀封号潮:菲律宾区、土耳其区与Team账号成重灾区

    一觉醒来,多个GPT账号被封号了! OpenAI突然开启大屠杀模式,没有任何邮件通知,直接把账号彻底删除注销。 屏幕上只有一行报错:「您的账户已被删除或停用(You do not have an account because it has been deleted or deactivated)」。 重灾区是菲律宾区

    来源 AI 行业观察
  13. 苹果最早明年推自主代理式 Siri:能主动管理任务,对标 ChatGPT Dots

    IT之家 11 月 9 日消息,彭博社记者马克 · 古尔曼在昨晚更新的《Power On》时事通讯中爆料,苹果计划最早于明年推出自主、代理式的 Siri,以对抗 ChatGPT Dots、Meta Muse、Grok。其目标是从响应命令转向一个能够主动管理任务并代表用户完成事务的助手。古尔曼称:“Dots、Muse 和

    来源 腾讯网
  14. ChatGPT账号突遭停用,Pro用户也被波及

    【TechWeb】最近,ChatGPT用户圈突然出现一波账号停用风波,连每月花费200美元订阅Pro服务的用户也未能幸免。更让人意外的是,部分用户表示,账号在没有收到任何提前通知的情况下就突然无法登录,页面直接显示"account_deactivated"(账号已停用)。 近日,多名用户在Reddit和OpenAI官方

    来源 AI 行业观察
  15. Shizuku AI推出Shizuku-Duplex:日语全双工模型,为伴侣式AI铺路

    IT之家 11 月 9 日消息,日本人工智能实验室 Shizuku(雫)AI 当地时间昨日公布了其开发的 Shizuku-Duplex,宣称其是继 GPT-Live 后第二个支持日语智能对话的全双工模型,无需完整询问即启动思考流程。在日语方面,Shizuku-Duplex 拥有 6 个参测模型中最高的对话自然性,响应质

    来源 腾讯网
  16. 大模型为何难识破诡辩:新提示方法F1最高提升0.60

    大模型在识别逻辑谬误时容易出错。这项研究提出一种两步提示方法,通过生成反论点、解释和目标来丰富上下文,并用置信度排序筛选最佳提示。在五个数据集上的测试显示,GPT和LLaMA模型的F1分数在无监督和微调设置下均有明显提升,优于现有基准方法。文章还分析了该方法为何有效,以及当前存在的局限性。

    来源 AI 应用前沿
向下滚动自动加载更多