GPT-6.1 Sol参与小鼠脑手术:三轮操作后定位误差降至0.3毫米
Exin Therapeutics 让 GPT-6.1 Sol 参与真实小鼠脑部手术定位。通过保存专家修正记录,模型在三轮操作中实现了“上下文学习”:定位时间从 169 秒降至 86 秒,误差从 0.6 毫米减至 0.3 毫米。这并非全自动手术,而是展示了 AI 如何在人类监督下积累实操经验,逐步优化坐标判断能力。
进针之前最难的那一步
做过小鼠脑部手术的人清楚,推药那一下反倒不算最棘手,真正考验手上功夫的是进针前的定位。
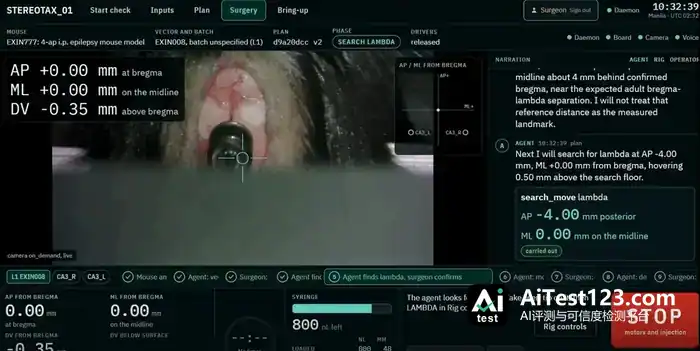
你得在一颗指甲盖大小的头骨上,辨认出几个肉眼几乎分不清的解剖标志点。它们无非是几条细缝合线交会的地方,可后面所有坐标都要以它们为基准。位置只要偏出零点几毫米,针就可能扎进错误的脑区,整批实验数据随之报废。
新手想找对这些点,只能一遍遍练,有时还得靠资深研究员站在旁边指点。如今,AI 也切进了这道环节。
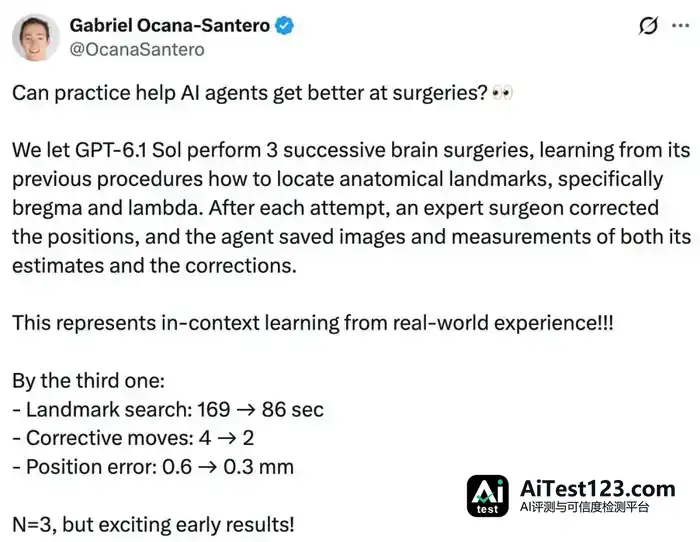
生物科技初创公司 Exin Therapeutics 的联合创始人兼 CEO Gabriel Ocana-Santero 近日公布了一组实验数据:团队把大语言模型  GPT-6.1 Sol 放进真实的小鼠脑部手术定位任务里,连续做了三轮。
三轮下来的变化有些出人意料。第三次操作时,模型找解剖标志的耗时从 169 秒压到 86 秒,专家出手纠正的次数由 4 次减为 2 次,定位误差则从 0.6 毫米收窄到 0.3 毫米。
Bregma 与 Lambda 是什么
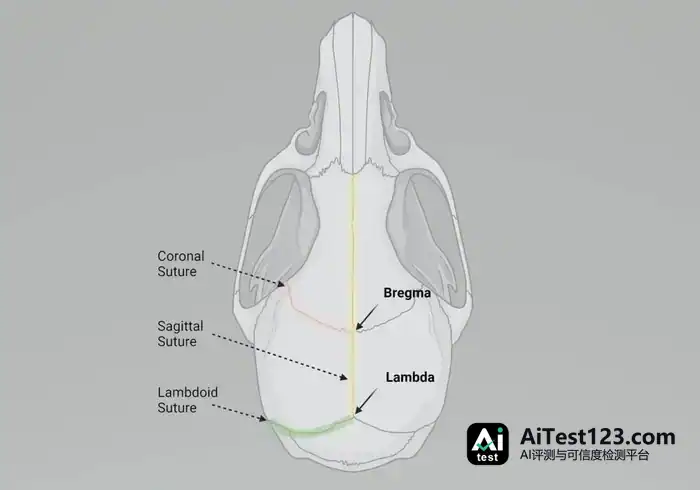
要看懂这组数据的意义,先得认识神经科学实验里的两位常客:Bregma(前囟点)和 Lambda(人字缝点)。
它们并不在脑内,也不是什么神经核团,而是小鼠头骨表面两个关键的参照点。矢状缝与冠状缝交会处是 Bregma,矢状缝与人字缝交会处则是 Lambda。
立体定位手术中,研究人员一般拿 Bregma 当坐标原点,再借 Lambda 的位置校正头骨的水平与倾斜角度。这两个点定下来,才能依照脑图谱算出目标脑区在前后、左右、深度三个方向上的坐标。
听着像道简单的几何题,真做起来却变数不少。每只小鼠的解剖结构都有差异,头骨缝合线清不清楚也各不相同。头部固定的角度、水平校准上的一点点偏差,最后都会把坐标误差放大。
在这次实验里,GPT-6.1 Sol 扮演的是“识别者”:看着摄像头拍下的实验图像,判断 Bregma 和 Lambda 落在哪里,并给出坐标建议。之后由一名专业外科医生复核,位置不对就动手修正。
靠的不是“训练”,是“记住”
整个实验最关键的机制,是模型怎么处理每一轮操作后的反馈。
传统 AI 模型训练往往要先攒大量数据,再用反向传播算法调整底层参数,费时费力,通常还得离线跑。Exin 团队换了个路子,用的方法叫“基于真实世界经验的上下文学习”(In-context Learning)。
说白了,模型每完成一次任务并不会把记忆清空。上一轮的原始图像、它自己量出的数据,还有专家修正后的最终结果,都被留了下来。轮到下一轮时,模型就翻这些历史记录,把自己先前的判断和专家的修正摆在一起比对,据此调整眼下的策略。
Ocana-Santero 特别说明,这和模型更新底层权重或自我进化不是一回事。至于这些经验数据具体怎么编码、怎么喂给模型,团队目前没有公开。但从结果看,这套机制让 AI 走出了类似人类学徒的学习曲线:先上手试,被纠正,再带着教训做下一次。
三项指标的变化很直白:搜索时间减半,纠正次数减半,误差同样减半。样本只有三次,离证明 AI 能稳定做手术还差得远。不过它至少摆出一种可能——在单次会话里,AI 可以靠不断累积的上下文信息把当下表现调得更好。
从“执行者”走向“决策者”
让 AI 碰真实的小鼠脑部手术,对 Exin Therapeutics 来说并不是头一回。
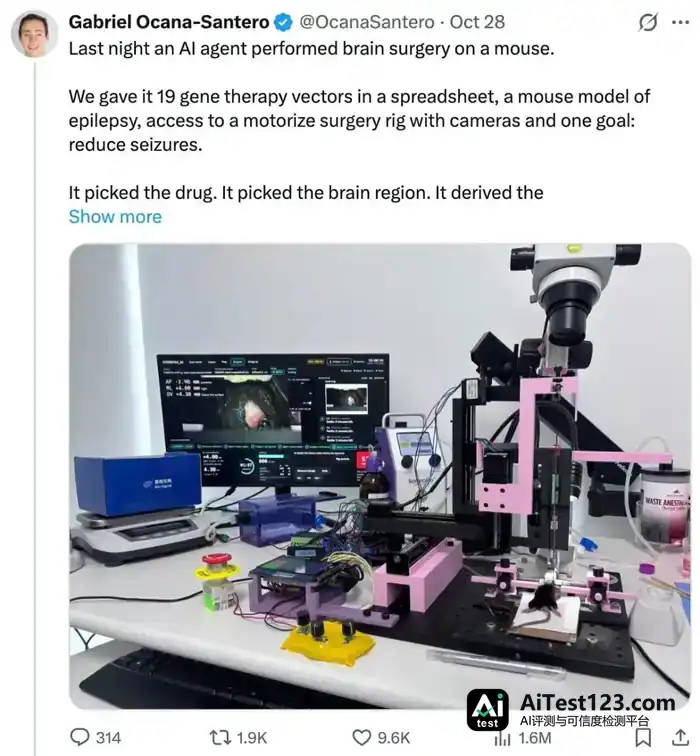
更早的 10 月 28 日,Ocana-Santero 就公开过一项难度更高的实验。那一次,团队交给 AI 智能体的东西包括 19 种基因治疗载体、一只癫痫模型小鼠,还有一套带摄像头的电动立体定位手术设备。任务目标是让 AI 自己去寻找能减少癫痫发作的治疗方案。
这当中,AI 既要操纵机械臂完成注射,也得参与前段决策:读文献,从候选清单里挑出合适的基因治疗载体,定下注射的目标脑区,再把具体坐标算出来。
整个过程并不是没人看着。切开头皮、开颅、缝合这些高风险步骤由一名持证兽医外科医生完成,关键操作也全程在他的监督之下。团队另外设计了几道安全机制:无法绕开的操作限制、关键步骤须经人类审批,以及一个物理紧急停止按钮。
有一次测试中设备坐标出了异常,AI 察觉到位偏,直接拒绝让针头继续移动。故障最后是研究人员手工改代码修好的。这个细节说明,眼下的 AI 更多还是辅助决策和执行的工具,离完全取代人类医生尚有距离。
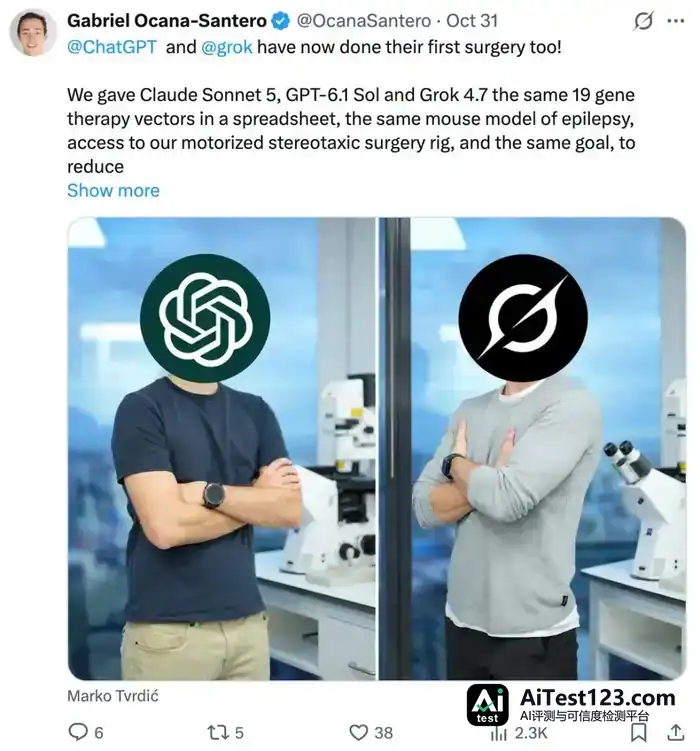
10 月 31 日,团队公布了另一组对比实验的结果。实验目标和候选载体完全相同,交给 Claude Sonnet 5、GPT-6.1 Sol 和 Grok 4.7 这三个模型,方案却各不相同:Claude 挑的是内嗅皮层,GPT 选的是海马体,Grok 给出的答案是躯体感觉皮层。
同一个科学问题,落到不同模型手里,会因各自训练数据和推理逻辑的差异,走出完全不一样的实验路径。至于哪条路更管用,还得等后续的生物学实验来回答。
争议与求证
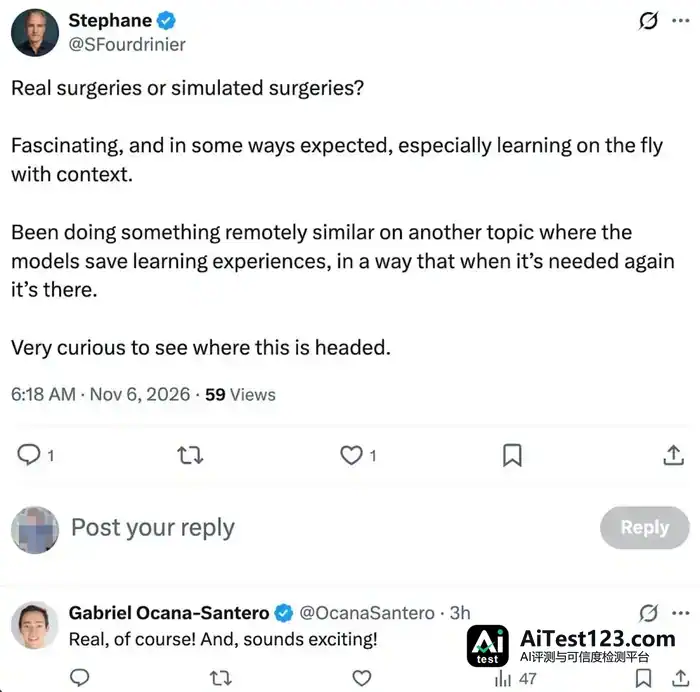
实验在社交媒体上也引来一些追问,不少人想弄清楚:这到底是真实的手术环境,还是高精度的模拟演示?
X 平台用户 Stephane 为此找到 Ocana-Santero 求证,对方明确答复这是真实手术。Stephane 接着评价说,这种在执行过程中即时积累经验并调用的机制非常有意思。他还透露,自己在其他领域也在试类似的做法,让模型把任务经验存下来,碰到相似问题时直接调取使用。
科研界看重这项技术的地方在于它能拉低实验门槛。准确找到 Bregma 和 Lambda 是神经科学实验的基本功,却也是新手最头疼的一步。AI 若能稳定地把这一步辅助做好,实验效率会提高,因人为操作误差带来的数据噪音也能减少。
当然,局限同样明显。样本量太小,缺少长期稳定性的数据支撑,而且整个流程完全依赖高质量的人类反馈。专家的修正本身就带偏差的话,模型学到的可能也是错的路径。
从让 AI 选治疗方案,到让 AI 攒定位经验,Exin 的尝试正把 AI 塞进更完整的生物医学实验流程里。它已经不只是查文献的帮手,更像一个能观察、能判断、能动手,还会从出错中学习的实验伙伴。
往远处看,未来的实验室里或许会出现这样的场面:研究人员只管把实验目标定下来,规划路径、校准设备、执行注射都由 AI 负责,每次操作后的偏差它自己记下来,用来优化下一次的表现。人类科学家则从繁琐的操作里抽身,把更多精力放在实验设计和结果分析上。
这条路还很长,第一步总算已经迈出去了。