

ICLR 2027评审被指荒诞:AI审稿人要求作者解释标准差
ICLR 2027首轮评审意见公开后,学术圈炸开了锅。有审稿人要求作者解释基础统计概念,有人直接把AI提示词贴进评语,还有人坦承自己不懂却硬评。这些荒诞案例背后,是AI介入学术评价带来的混乱:模型能挑出无数毛病,却分不清哪些致命、哪些无关紧要。面对投稿激增和审稿人力不足,会议方收紧了互惠审稿规则,并强制披露AI使用情况
有审稿人问出“什么是标准差”
这几天,机器学习顶会 ICLR 2027 的首轮评审意见在 OpenReview 上陆续公开。对多数研究者而言,这本是一年里最让人绷紧神经的节点之一——实验跑了好几个月,论文熬过几个通宵,终于要交给同行去审视。
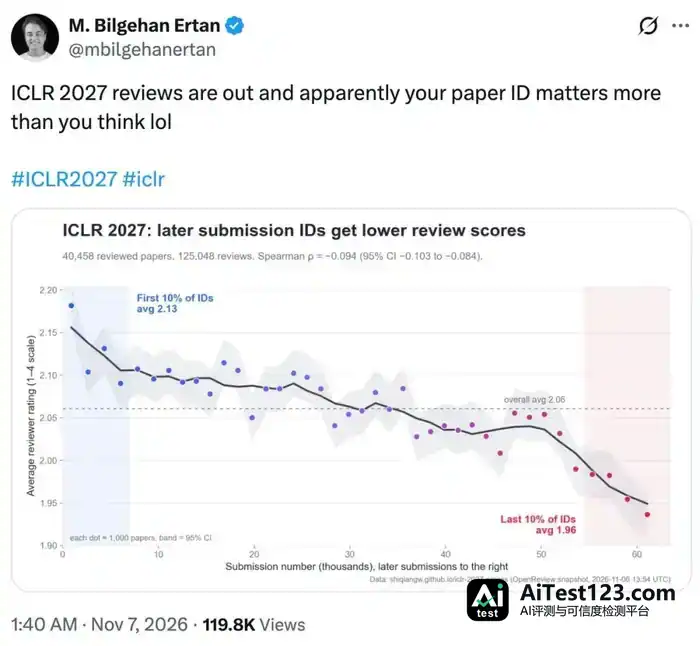
不过今年,这份紧张很快被另一种荒诞感顶替了。
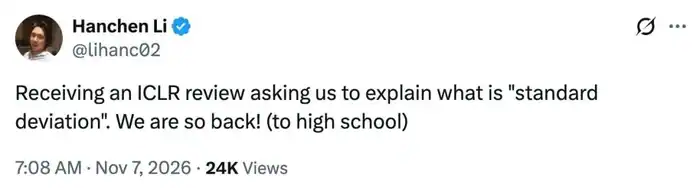
加州大学伯克利分校的研究者 Hanchen Li 在社交平台上吐槽,自己收到的一份评审意见里,审稿人要求他们解释什么是“standard deviation”(标准差)。Li 打趣说,感觉一瞬间被拉回了高中数学课堂。完整上下文外界看不到——也许审稿人只是想确认某个统计量的定义方式——但截图还是很快在圈内传开了。向一个投稿顶级会议的研究团队追问基础统计概念,这件事本身就够有戏剧性。

更离谱的还在后头。
研究者 Ravid Shwartz Ziv 晒出了自己收到的三份意见。前两份几乎是复制出来的,全是标准套话:“论文写得不错,解决了一个重要问题,但建议增加更多基线对比。”到第三位审稿人,画风就完全变了,开头直接写着:“Certainly! Here is a review of the paper”(当然!以下是这篇论文的评审意见)。
这句 AI 助手式的开场白,连标点都没动一下,就被原样粘进了正式评审系统。也就是说,至少有一位审稿人不光靠 AI 生成内容,连最基本的清理都懒得做。这些带着明显机器痕迹的文字,就这么成了决定论文生死的依据。
“我不懂这个领域”,但至少诚实
除了 AI 生成的低质评语,评审分配机制的问题也一并暴露了出来。
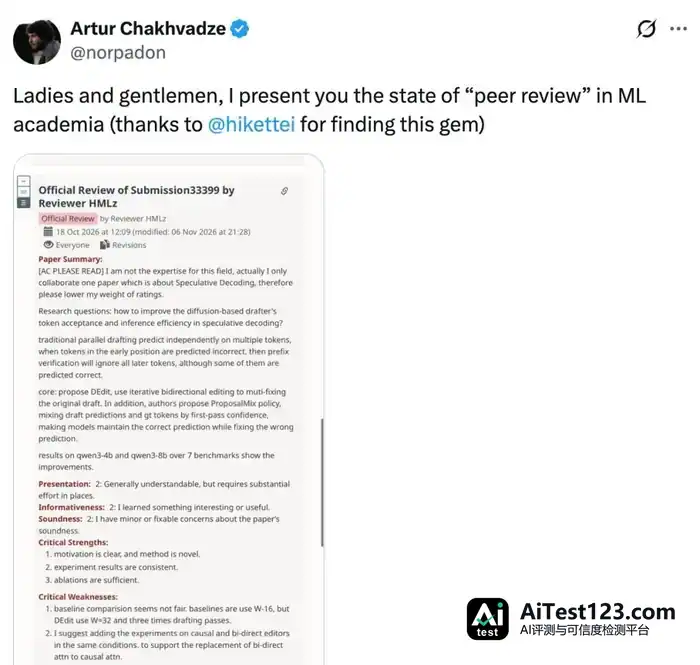
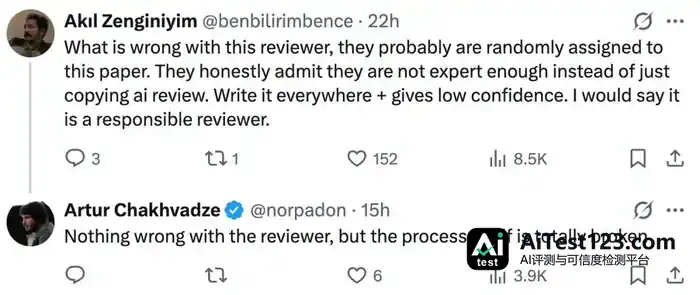
研究者 Artur Chakhvadze 分享了一份特别的意见。审稿人在文中承认,自己缺乏评估这篇论文所需的专业背景,给不出高质量的评价。Chakhvadze 反倒觉得有点欣慰:至少这位审稿人没有硬装专家乱指点。他吐槽说,自己见过太多审稿人,领域基础都没搞明白,却自信满满地打高分或低分,还附上一堆外行指导内行的意见。
这条帖子引出了两种声音。一派认为,承认不懂比假装懂行负责得多;另一派则把矛头指向会议的组织流程:专业背景对不上,系统为什么还把论文分给他?Chakhvadze 后来补充说,问题可能不在审稿人个人,而在整个评审分配和管理流程存在漏洞。
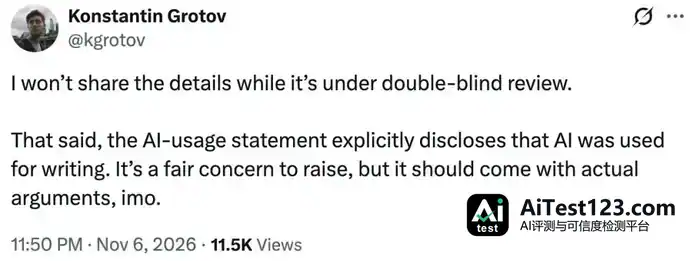
与此同时,AI 辅助写作的争议也在发酵。研究者 Konstantin Grotov 收到一条负面评价,主要针对他“使用 AI 写作”。他的论文已按规定披露了 AI 辅助情况,审稿人依然拿这个说事。Grotov 反驳说,如果审稿人认为 AI 的使用影响了论文质量或可信度,就该拿出具体的技术论据,而不是仅凭“用了 AI”就否定整项工作。
AI 擅长挑刺,但不懂轻重
这些荒诞案例背后,是一个更深的技术困境:大语言模型(LLM)似乎缺少判断学术价值核心所需的那种“分寸感”。
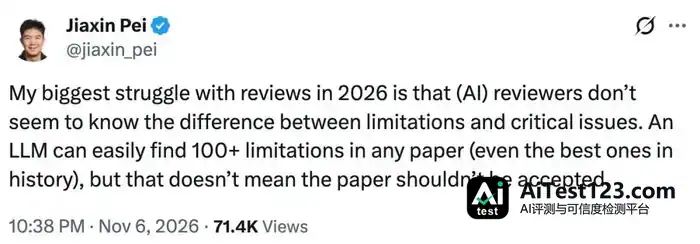
德克萨斯大学奥斯汀分校的 Jiaxin Pei 提到,自己在去年的审稿经历中发现,AI 审稿人常常分不清论文的“局限性”和“致命缺陷”。大模型能轻松列出一篇论文的几十甚至上百个不足:数据集不够大、某些边缘场景没覆盖、理论假设过于理想化……这些问题确实存在,可对一篇科研论文来说,它们未必够得上拒稿。
做学术研究,本身就是在资源有限的前提下摸索未知,实验做不大、方法要依赖某些假设,这些都很常见。论文能不能立住,说到底看这些局限有没有伤到核心结论。要是关键实验的设计存在漏洞,或者理论推导里有修不好的逻辑错误,那就是硬伤;反过来,只少了些不关键的对照实验,一般写进“未来工作”或“局限性讨论”也就交代过去了。
但 AI 很难做出这种权衡。它习惯把所有潜在问题都摆出来,还往往给它们差不多的权重。评审意见因此变得冗长琐碎,作者被要求补一堆无关紧要的实验,真正核心的贡献反而淹没在噪音里。
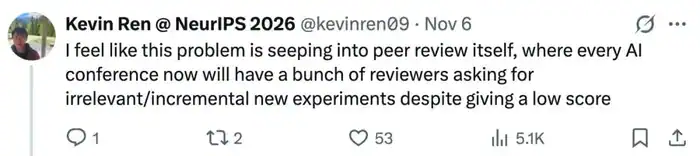
Pei 的看法引起了很多研究者的共鸣。大家发现,越来越多的审稿意见呈现出一种模式:打分偏低,同时要求作者做大量边际效益极低的增补实验。一个问题如果修不修都不改变论文的核心结论,那它就不该成为拒稿理由。这种判断力,恰恰是眼下 AI 最缺的,也是人类审稿人最值钱的地方。
投稿激增下的制度修补
ICLR 2027 冒出的这些乱象并非偶然,它是学术界在 AI 时代承受结构性压力的一个缩影。
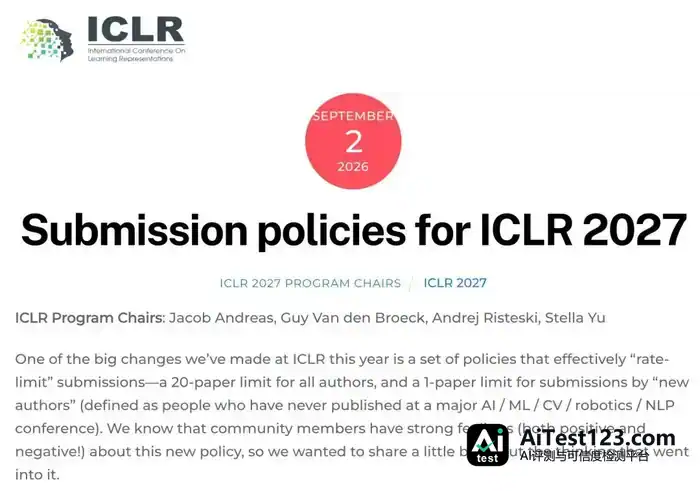
近几年,机器学习领域的投稿量呈指数级增长,新进入者远超资深研究者的数量。生成式 AI 又降低了论文生产的门槛,稿件质量参差不齐。具备专业能力的审稿人却没有同步增加,甚至因为工作量过大而出现倦怠。为应对这场危机,ICLR 2027 项目主席团队在 9 月发布官方文章,承认同行评审系统面临新压力,并推出了一系列改革措施。
第一项是收紧“互惠审稿”。按照新规,名字出现在 3 篇及以上投稿里的作者,审稿量不得少于 6 篇。此外,每篇投稿都要有至少一位符合规定资格的作者注册为审稿人,并答应评审至少 3 篇论文;只有全部作者都不具备相应资格,才可以免掉这一条。这么做,是想借行政手段把审稿人池子强行撑大,好让人手紧张的局面缓一缓。
再就是对 AI 使用的规范。ICLR 没有一刀切禁止审稿人用大模型,而是采取“有限度、负责任、全披露”的策略。审稿人可以用 AI 辅助撰写评语,但必须满足以下前提:
- 强制披露:必须在系统中声明使用了 AI。
- 使用大模型生成或修改评审意见的审稿人,得把两样东西交上来:一是自己最初独立写的那份评估草稿,二是跟大模型的全部交互记录,多轮对话的输入内容也算在内。
- 要是 AI 产出的评审里有虚假信息、幻觉或者失实陈述,又或者整体质量不过关,这名审稿人就会被认定没有履行互惠审稿义务。处罚随之而来:其作为作者参与的全部投稿直接拒掉,或者限制其未来参加该会议的投稿资格。
这套规则想做的,是在用 AI 提效和维护学术严谨之间找个平衡点。把交互记录留下来,会议方图的是责任能追溯到人,免得审稿人把活儿全甩给 AI;同时,后续做质量审查时也有据可依。
结语:人与机器的边界
眼下公开的还只是 ICLR 2027 的首轮评审意见。作者和审稿人的公开讨论会一直持续到 11月18日,最终录用结果预计 12月16日公布。这段时间里,作者仍可以就错误的评审提出质疑,审稿人也能照着反馈改评分。
这件事给整个学术社区提了个醒。AI 已经同时渗进研究的生产端和评价端,传统的同行评审机制显得捉襟见肘。光有更强的检测工具不够,还得重新想想学术评价到底是为了什么:评审是要把可能的毛病全挑出来,还是要认出真正有价值的创新?
那位要求解释“标准差”的审稿人,背后可能是一个疲惫的研究者想借 AI 分担压力,结果缺少监督闹了笑话;也可能是评审分配系统随机出的错。不管哪种原因,它都提醒人们:自动化浪潮里,人的判断力、责任感以及对专业边界的敬畏,仍是学术共同体最核心的基石。这些底线守不住,评审流程再高效,产出的也可能只是一堆毫无意义的文字垃圾。














