

GPT-6.2 Astra将至:具身智能公司传裁算法岗,自研模型还值得做吗
GPT-6 Astra发布才两个月,GPT-6.2 Astra眼瞅着就要来了。 然而具身智能行业还没从上一轮打击中缓过神来。 一切都是那么猝不及防。 还记得GPT-6 Astra刚出来时,一批具身从业者被打懵了。特别是在一线搞预训练的工程师,更是人人自危。 近期,业内又传出消息,一些具身智能公司开始裁撤算法岗。 过去需
 GPT-6 Astra才发布两个月,GPT-6.2 Astra已经近在眼前。
具身智能行业却还没从上一次冲击里缓过来。
事情来得太突然。
GPT-6 Astra刚亮相那阵,一批做具身的人直接被打蒙,尤其是一线做预训练的工程师,个个心里发慌。
最近业内又传出风声:有具身智能公司已经开始对算法岗动刀。
以前要靠海量数据、算力和算法工程师一点点磨出来的能力,GPT-6 Astra在部分测试里不用针对具体任务做额外后训练就能拿出来。
这还怎么卷?
一位在机器人公司做模型开发的工程师对量子位说:
比起具身智能迟迟等不到新的范式级突破,以Astra为代表的通用大模型正顺着coding这条路,垂直砸向具身行业——这才是真正的冲击。
压力并不全从硅谷来。
对国内具身公司来说,比起OpenAI等海外大模型公司的进展,本土大模型玩家下一步要做什么,更让他们敏感。
Kimi、DeepSeek、智谱……这些名字,正变成具身行业绕不开的变量。
最近热度很高的RoboDojo评测里,尝试把通用大模型(比如GPT-6 Astra)接进自家机器人系统的团队越来越多,泛化很强,能力惊人。
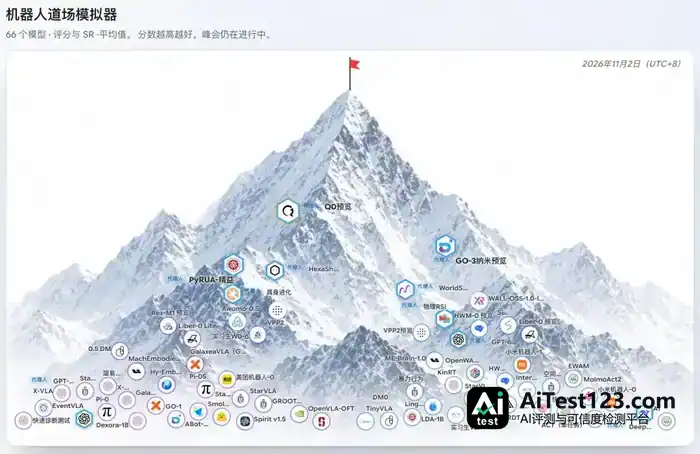
RoboTwin/RoboDojo评测基准第一作者陈天行透露,一些原本死磕原生具身基础模型的团队,现在也开始交结合Robot-Use-Agent(RUA)等技术的方案,靠通用大模型把机器人任务跑完。
效果很直接:原来只有20分、30分的模型,接上Astra相关方案后,评测成绩能提到50分、60分。
榜单分数是上去了,可具身公司脑子里只剩一个念头:
自研模型还有必要吗……(cry)
陈天行是香港大学MMLab具身智能方向的博士生,RoboDojo针对GPT-6 Astra的评测及评估报告(下称“报告”)他也参与了撰写。
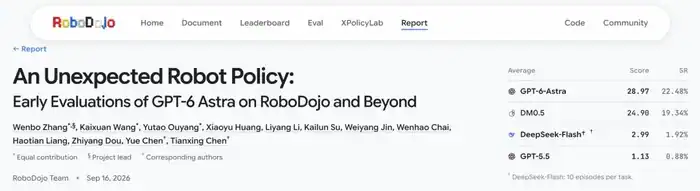
△RoboDojo团队对GPT-6 Astra的早期评估报告
陈天行告诉量子位,9月中旬有一天,伙伴们陆续把测试结果送过来,他愣了好几秒:
它对3D重建、对数学等各个领域的冲击,都是空前的。
吓人,真挺吓人的。
都被GPT-6打懵了
“具身自研模型还在80分上不断加0.1、加0.2,GPT-6 Astra已经一次性从80分跳到了90分。”
陈天行在复盘这轮评测时,打的就是这么个比方。
更让人难受的地方在于,有些测试里Astra压根没做针对具体任务的额外后训练,也没给任务示范,光靠语言指令就把不少机器人操作任务做完了。
让他最没想到的,是Astra一口气拿出了三项能力——过去具身模型都得重点啃的硬骨头。
头一项叫ICL,也就是上下文学习(In-Context Learning)。
说白一点,就是给机器人少量上下文信息,它就能很快学会一个新任务。
举个例子,人拿手机拍一段自己干活的视频,再写几句文字说明,机器人看完就知道人是怎么操作的,然后试着让机械臂照着做一遍。
今年7月,ICL在具身圈里还是相当热的一个研究方向。大家常走的路子是:先展示人类操作,再让机器人模仿,靠这个学会新技能,也就是所谓的单次情境学习。
不过社区发现,给Astra喂图像或文字示范,成功率能比不给示范更高。
在线适应这块更出人意料。研究人员有意把摄像头画面和动作坐标系改掉,Astra照样能根据实际执行的结果,试上几轮就调整策略,把任务顺利完成。
换句话说,它不只是读得懂上下文,还能一边干一边改。
陈天行觉得,原因在于通用模型本身上下文理解就很强。平时聊天,它记得住前面的对话;给它一段视频,它也能搞清画面内容和文字之间是什么关系。
这些本事搬到机器人操作上,原本要单独立项研究的ICL问题,忽然就有了现成的答案。
第二项是OOD(Out-of-Distribution,分布外泛化)加上Correction,也就是纠错能力。
真实环境里,机器人很容易撞上训练数据之外的情况。
比如机械臂正要抓杯子,杯子被人碰了一下,位置挪了。
太依赖训练数据的模型,可能还按老轨迹走,结果抓了个空。
Astra则会看着变化后的视觉信息重新调整动作,再试着把东西抓起来。
听着只是个小动作,可它背后是机器人能不能适应真实世界的大问题。
说到底,现实世界里没人负责把每个杯子都摆回训练时那个位置。
第三项是Open-Vocabulary Manipulation,开放词汇操作。
这项能力牵涉语言和动作怎么对齐。
比如用户换个说法提操作要求,机器人照样听得懂、做得到。
以前语言理解和动作执行之间常常是断开的,具身模型得针对具体任务做后训练,对齐效果才好。
可Astra在这块表现更强。部分测试中,即便没有针对具体任务做额外后训练、也没给示范,它仅凭语言指令就完成了不少机器人操作任务。
陈天行认为,这三项技术命题此前在具身领域分量都不轻,过去任何一项都足以单独撑起一个创业故事。Astra一次把三道题全做了,对原有具身模型的研发路线冲击近乎爆裂。
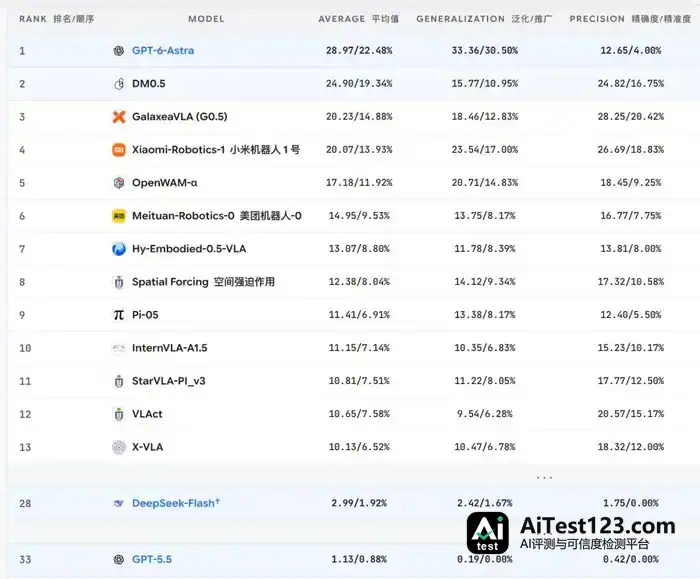
需要说明的是,上述结果来自RoboDojo-Sim基准测试中的零样本测试,并不意味着Astra已经能在真实机器人上稳定完成这些任务。RoboDojo团队在报告里提示,Astra的真机测试曾因安全问题中止。仿真榜单上的高分,和真实世界里的生产力还不能直接画等号。但它已经足够让具身公司回头重新审视过去的研发投入。
一个原本并非为机器人操作而生的通用大模型,凭什么能快速逼近具身公司多年积累的能力?这事说起来有点无心插柳。
通用大模型进入机器人领域时,并非从零起步,它带着大规模预训练攒下的语言、视觉、推理和Coding等一整套能力。这些能力本来各有各的用途,放到机器人身上,没想到也能直接派上用场。
具身公司这边则是另一番景象:不少团队从零开始训练机器人大脑,手里的数据主要来自机器人操作本身。模型要理解环境、听懂指令、学会动作,很多能力只能从有限的数据里一点点磨出来。
一边是带着一身通用本事来做机器人,一边还在为每一项能力单独投入数据、算力和人力。这场较量,起跑线本身就不一样。
自研模型还有必要吗?
GPT-6 Astra确实强,但还没强到让具身公司直接缴械投降的地步。至少在真实物理世界里,还有不少硬骨头要啃。
破壳机器人创始人许华哲把具身智能的能力拆成语义、空间和物理泛化三个层次。在他看来,Astra在前两项上表现突出,可一旦涉及复杂物理接触、受力变化、物体形变和高精度操作,仍然面临挑战。
举个例子,让机器人知道杯子在哪、该伸手去拿,和让它稳稳抓住杯子,完全是两码事。杯子是软是硬?抓取时该用多大力?物体被挤压、碰撞之后会怎么变?这些问题,光靠看懂画面、理解指令还不够。

△报告截图
RoboDojo团队在评测中也发现,Astra并非所有任务都占优。几何对齐、语言指令理解是它的强项,但到了连续接触和多步骤物理操作,现有VLA仍有不少机会。
自变量创始人王潜的看法是,通用大模型想进具身这行,机器人数据、真实世界评测、硬件、仿真、部署这些基础设施问题,一个都绕不开。
就算手里握着一个更强的语言模型,这些坎也不会自己就平了。
那问题就来了:Astra眼下干不成的事,过些日子会不会忽然就干成了?
眼下业内对Astra抱怨比较集中的一个点,还有推理速度偏慢。
陈天行同样留意到,GPT-6 Astra的云端API推理延迟不低,放到机器人的实时闭环控制上,这就是实打实的障碍。
道理不难懂:机器人每动一下都得等大模型琢磨半天,真实场景里的要求恐怕就很难满足。
不过陈天行觉得,这算不上根本性的壁垒。眼下LLM端侧部署的路子已经不少,模型量化、蒸馏、端侧推理引擎这些技术都在。只要大模型厂商把机器人当成重要的商业场景,用现成的技术栈就能把延迟压下来。
这个问题背后,藏着一个特别容易混淆的概念:「模型推理频率」和「机器人控制频率」,压根不是一码事。
一位不愿具名的具身模型工程师对量子位说:
推理慢,控制照样可以快,搭进去的只是反应速度。碰上比较吃节拍的那类流水线任务,这反倒不要紧。
拿快递分拣来说,机器人得连续、稳定地抓取和投放。高层模型管的是理解任务、规划动作,底层控制系统则用更高的频率去执行控制指令。
只要任务能提前规划,或者对反应延迟有一定容忍度,大模型就未必每个底层控制周期都得掺和。
当然,真遇上高速动态变化、复杂接触这类任务,反应速度还是关键。
但起码,推理慢不等于机器人控制就快不起来。
通用大模型今天露出来的各种短板,没法直接当成具身公司往后吃饭的护城河。
这话对具身公司来说,听着多少有点扎心。
可事实就摆在那儿。今年OpenAI已经开始大批招机器人相关的岗位。
要是将来通用模型吃进更多机器人操作数据,原本属于专用具身模型的地盘,还可能被接着挤掉。
具身公司还有戏吗?自研模型还有没有必要做?
陈天行的判断是,具身公司的机会不在谁家模型更聪明,而在谁能把「经济效益」做得更好。
这笔帐其实好算。
一条高度标准化的工业流水线上,机器人天天重复同样的动作,客户最在意的是成功率、节拍、稳定性和成本。
花几毛钱调一个模型就能把活稳稳干完,何必非掏几块钱去调GPT-6 Astra?
就算需要一点智能和泛化能力,一个专门优化过的小模型,也可能比直接调Astra更划算。
当然,要是换成家庭服务机器人,局面就另说了。
今天整理餐桌,明天找东西,后天又冒出一件从没碰过的新活儿。
这种开放环境里,任务变得越杂,对理解、规划、泛化的要求就越高。通用性更强的模型,反倒可能占优。
11月6日,陈天行在个人博客上画了两条轴线,讲清这层差别。
横轴一头是「场景需求」,另一头是「模型能力」;竖轴往上走偏通用,往下走偏效率。

△陈天行博客
陈天行说:「开放任务可以更多借助通用模型,稳定任务可以采用规则或轻量策略,中间的场景则给场景优化模型留下了空间。」
依我看,把两条轴线摆到一块儿,说白了就是一句话:
规则或轻量策略能搞定的,不必搬大模型;小模型能干的活,也没必要回回请Astra出马。
反过来讲,任务要是变得太频繁,专用模型就得不停采数据、反复重训,这时候直接调通用模型或许更划算。
到底选哪条路,最后还是得把账算全。
单次任务成功率几成?耗时多少?失败以后要搭进多少人工?采集数据、训练模型、长期部署又各要花多少钱?
这些硬邦邦的数字,才决定一套机器人系统有没有商业价值。
所以说,自研本身不是不重要,问题是具身公司的「自研方向」得重新排个先后。
语言理解、任务规划这类通用模型已经拿手的能力,能借就借;物理交互、特定本体控制、真实场景适配、部署效率这些事,还是离不开大量专门投入。
至于还要不要从头再训一个更大的具身基础模型,得看它在实际任务里能不能拿出足够明显、足够持久的优势。
有行业朋友跟量子位吐槽,眼下不少具身团队还带着浓浓的学者心态,一心想做一个通用智能模型,恨不得把所有任务都塞进自家模型里。
可形势已经不一样了。GPT-6.2 Astra都快来了。
企业研究方向一旦和目标产业对不上,模型训得再漂亮,商业上也未必转得起来。
One more thing
过去60天里,不少具身从业者私下聊起来,心里还是没底。
只是到了公开场合,该维护的利益和立场,大家照样据理力争。
能确定的是,GPT-6 Astra确实把具身行业原来的节奏打乱了……
马太效应、宇树上市后的行业重估、RSI成为新风口……这些因素叠在一块儿,凑成了眼下的行业情绪——
「投资人开始不投具身了」,这话在圈子里传开了。
说法也许有夸大,但具身智能机器人创业告别Demo、告别烧投资的时代,确实已经来了。
百机大战的淘汰赛,已经开打。














