Qwen 4疑似偷跑游戏开发榜:Flash版胜Opus 5.5,成本降85%
Qwen 4疑似内测曝光
3D建模有多耗Token,跑过的人都清楚。这个来历不明的模型,连Token消耗都压了下来。
最让人意外的是,它一共只用了69k Tokens。
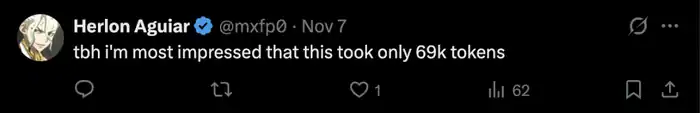
Loktar本人说,测试给的Token额度有限,他只让模型生成了一次,效果已经相当可以。
思考模式他也只开到High,更高的XHigh或Max都没用上。
一次生成,没做任何调优。
Loktar此刻的心情大概就是这样:
现在还说不准它就是Qwen 4。如果真是,那可就太棒了。
第三方榜单上,也冒出了疑似Qwen 4的测评成绩。
往前面一看, Opus 5.5居然也得让位?
Qwen 4疑似拿下游戏开发榜第一,成本只有Opus的六分之一?
这份榜单专门考AI做游戏的本事,名字叫GameFeel Bench。
它和常见的代码评测不一样:不只看模型能不能把程序写出来,游戏手感、视觉效果、创意设计这些也都在考察范围内。
最新v1.4榜单上,两个疑似Qwen 4早期版本已经悄悄进了前四。
冲得最靠前的是内部代号hawk的Qwen-4-Flash-Early。
成绩从高到低:
Qwen-4-Flash-Early:49.9分
Claude Opus 5.5(XHigh):47.2分
Claude Sonnet 5.5(Max):45分
Qwen-4-27B-Early:44.6分

结果就是,Flash版本把Opus 5.5挤到了第二。
27B版本同样不弱,44.6分排在第四,离Sonnet 5.5只差0.4分。
跟A家最新一代模型正面比也不落下风,Qwen 4这次表现确实可以。
成本方面更抢眼:
榜单测试者公布的数据显示,Qwen-4-Flash-Early跑完一次任务,花费约0.40美元(约合人民币2.67元);Opus 5.5 则要2.60美元(约合人民币17.36元)。两者一比,前者只占后者约15%,差距达到6.5倍。
要是正式版也能维持这个水平,那些天天掐着Token算账的开发者,恐怕真要动心。
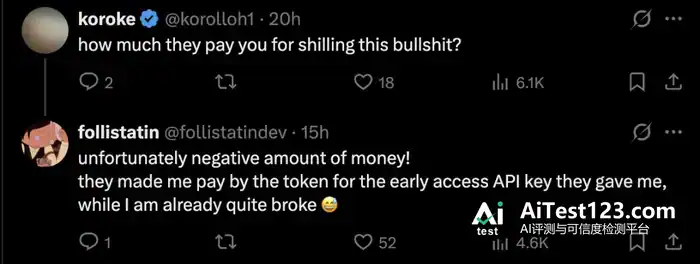
顺带一提,从榜单维护者follistatin和网友的交流看,他跟前面那位Loktar差不多,也提前拿到了神秘模型的测试资格。API Key是发了,可Token还得自己花钱买(笑)。
Qwen 4 正在小跑进场。这波预热,Qwen 4 把大家的胃口吊得够久。
之前有消息说新模型会在11月初登场,结果上周等了一轮,正式发布始终没出现。倒是Qwen官方先甩出一张预热海报:一句「The becoming begins」,再配上《庄子》里那句「北冥有鱼,其名为……」,悬念拉得很满。(其名为鲲→Qwen,谐音梗扣钱doge)
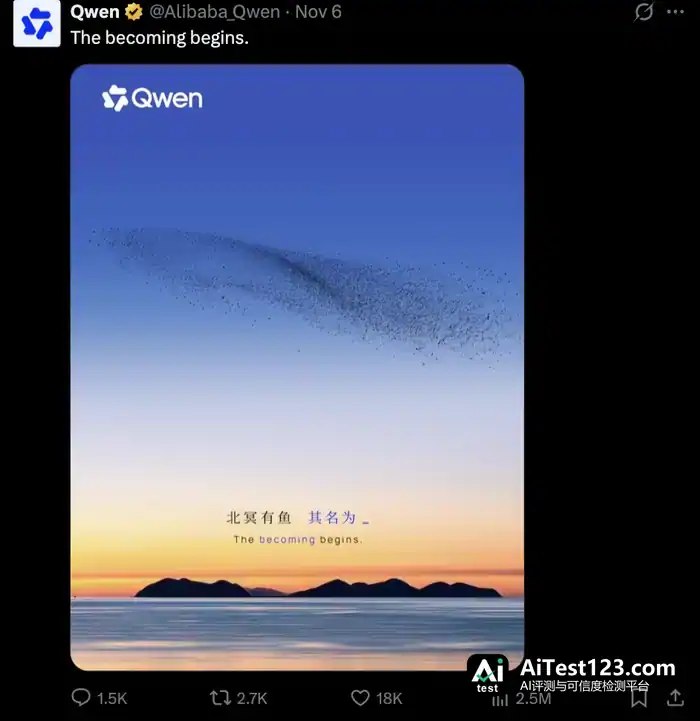
从已经曝光的信息看,Qwen 4 的版本阵容也在变得清楚:Max、Plus、Flash和27B等不同型号,分别指向旗舰性能、低成本推理等方向。
型号之外,新架构也露了一角。此前阿里借Qwen3.8-Flash-Next,提前亮出了部分面向下一代模型的技术设计,包括混合稀疏注意力、Gated Residual、N-gram Embedding,以及Muon优化器等。
这些名字听着绕,说到底就是让模型保住能力的同时,把训练和推理的钱再压一压。按官方早前披露的数据,Qwen3.8-Flash-Next总参数量125B,每次推理只激活6B参数,训练成本约为Qwen3.7-Plus的九分之一。
这样一来,Qwen 4 正式亮相时,这套技术路线还能再挤出多少提升,就更让人想知道了。
还有个细节:10月底,Qwen Code的代码更新里已经冒出qwen4、qwen4-max等模型标识,还牵涉百万Token上下文的适配。
再加上这两天陆续出现的神秘模型测试,这些迹象都指向同一件事:
种种信号凑到一起,Qwen 4离亮相真的不远了。
还有一件事。
这周恐怕也会相当热闹,不光是Qwen 4。
OpenAI那边,GPT-6.2 Astra被网友在Codex的用量统计里发现,看起来内部测试已经启动。
Anthropic同样没歇着。
Fable 5.5据传正处在灰度测试阶段,Mythos 5.5这个名字甚至一度出现在官网页面的代码中。
谷歌那边也有消息,传闻中的Gemini 4 Carbon,据说最快11月9日就会开放有限访问。
另外,还有那位又崩了的D老师……
这样的场面,终究还是来了。
只盼这回各家能真拿出点新东西。
说到底,「即将发布」这四个字,网友都快看出PTSD了。
(拿来吧你!!)

参考链接:
[1]https://x.com/loktar00/status/2118782505369428117
[2]https://x.com/search?q=Qwen%204&src=typed_query