李飞飞World Labs推Frameboy:云端实时生成第一人称世界
Frameboy。
AI 圈今天有一群人在玩游戏。

李飞飞创办的 World Labs 拿出了它的第一款「应用」Frameboy。画面由 AI 实时生成,第一人称视角,生成式 AI 就此变成一种能直接走进去看的体验。
Frameboy 是 Atlas 世界模型的一个优化演示版本,靠云端 GPU 流式传输,帧率最高 15 fps。实测模型响应时间约 70ms,已经和云游戏差不太多。
体验链接:https://frameboy.worldlabs.ai/
目前能探索的是精选场景:真实世界的各处风景、赛博朋克空间,还有斯坦福大学校园。这些环境的搭建有两种路子——有的从一张图片起步,让 Atlas 脑补出其他视角,一点点长成可探索的空间;有的则输入同一地点的多张照片,由模型补出照片之间以及照片之外的新视角。
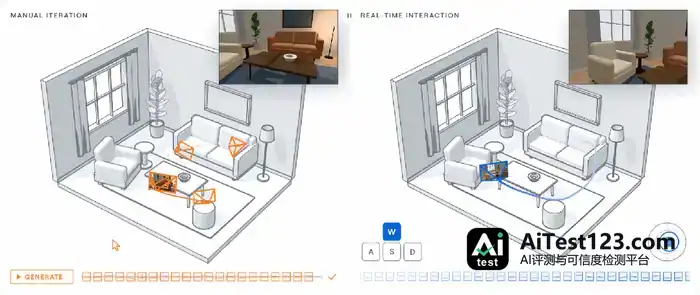
World Labs 还把 Frameboy 作为流媒体覆盖渲染模式,直接塞进了 beta 版网络应用 Viewfinder。用户拿自己的输入内容逐帧搭场景,随后在实时中探索、扩展这个虚拟世界。
操作起来有点像扛着摄像机:从不同视角导航,生成 3D 一致的世界视图。每一帧都由 Atlas 产出,带颜色和深度信息。准备好之后,用户能调出 Frameboy 叠加层,边探索边实时播放生成的帧。
Atlas:一张照片如何推演出三维世界
Frameboy 这场实时演示到底意味着什么,得先看它背后的 Atlas 是什么。
World Labs 由李飞飞创立,今年 9 月 1 日正式发布 Atlas。这是一个从头预训练的通用世界模型,文字、图像、视频和三维空间信息都能处理。视频模型主要忙着生成连续画面,Atlas 啃的是更麻烦的问题:摄像机挪到另一个位置,眼前的世界该长什么样?
发布时 World Labs 给了一个很直观的例子。
研究人员先给 Atlas 一张花园照片,让它生成从空中俯瞰这片区域的画面。原始照片只拍到花园的一部分,模型重现了已有景物,周围房屋和环境只能自己猜。
接着加进第二张照片,内容是花园旁边的小屋。这回 Atlas 生成的画面里花园和小屋都在,更远处的建筑仍靠模型补全。等第三张照片进来,展示附近的主屋,整个场景才重建得比较接近真实环境。

这个过程点出了 Atlas 的一个特点:有限的图像能用来重建已观察到的空间,训练中学到的世界知识则用来推测镜头之外可能有什么。
World Labs 把核心机制叫作「空间上下文」(Spatial Context)。
说白了,Atlas 不只认图片里有哪些物体,它还把每张图片和摄像机在三维空间中的位置、朝向绑在一起。用户指定新的观察位置,模型就依据已有空间信息,生成该位置应看到的画面。
这也是它和普通视频生成模型的一大差别。后者一般靠「向左移动镜头」「绕着人物旋转」这类文字描述来控制运镜;Atlas 直接接收精确的摄像机位置和角度,观察世界的视角由用户明确指定。
技术架构上,Atlas 用的是多模态自回归扩散 Transformer,把语言模型和扩散生成模型的思路合到一起:文字、图像、摄像机位姿和深度信息先组织成统一的空间上下文,再一步步生成新的画面及空间数据。
最初的演示里,用户已经能预先设计摄像机路径,让 Atlas 生成最长一分钟、最高 1440p 分辨率的视频,并尽量在不同镜头之间维持场景一致性。
生成视频并不是 Atlas 能力的终点。
图像与深度信息它能同时产出,还能输出点云、3D Gaussian Splatting(三维高斯泼溅)等三维表示。也就是说,模型给出的不只是某个角度的画面,还有可供三维渲染、空间重建等工作流程使用的数据。
研究人员的做法之一:用三到五部普通手机和运动相机,从不同角度拍同一场景。Atlas 据此重建空间,用户能在动作发生的同一时刻切换观察角度,做出类似电影《黑客帝国》里「子弹时间」的效果,传统的大规模多机位拍摄系统可以不必部署。
机器人仿真则是另一个方向。手机视频记录真实环境,Atlas 重建空间,再生成机器人沿不同路线移动时,机载摄像头可能看到的画面和深度数据。用少量真实记录搭建机器人模拟环境,由此多了一种新办法。
Frameboy 出来之后,基于世界模型的创作方式变了:边移动边观察,边看边决定下一步。电影勘景、空间概念设计、游戏关卡构思,这几个方向都有潜力。
参考内容:https://www.worldlabs.ai/blog/atlas-realtime