MiniMax与Seedream同台实测:写实拉不开差距,文字成胜负手
sina qqZone renren ydCloud 0
11月9日与10日,字节Seed和 MiniMax接连放出各自的新一代图像模型,分别是Seedream 5.5和MiniMax H3-Image。前者把重点放在百轮编辑不崩坏、原生透明素材以及图层拆分上;后者则强调10秒出16MP大图、开放权重,价格也更低。
我们拿同一套提示词和素材,对两款模型做了四项同台对比,随后又单独验证了它们各自独有的能力。考的就是同一套题目下,两家模型的核心本事能兑现多少。
对比做完,有四条结论。
一、写实能力已经不再是图像模型的分水岭。两家生成的人像和街景都能以假乱真,差别只剩审美取向:MiniMax偏“街头抓拍”,Seedream偏“电影剧照”。用户选模型时,已经不必再纠结“谁更真”。
二、文字才是这一轮真正的胜负手。十种语言共20行文字,Seedream写对19行,MiniMax只写对12行。对做多语言海报、出海物料的团队来说,这个差距足以左右选择。
三、多图理解上,两款模型“听话”的方式不一样。两家各做对5项:MiniMax更忠于参考图,Seedream更忠于文字指令。想照着素材复刻,前者合适;想按需求改造,后者更顺手。
四、堆像素不如做交付。MiniMax的16MP在近处经得起放大,远处人群照样会糊;Seedream的图层拆分一次就能拆对,背景还会自动补全,更贴近设计师的真实需求。
综合来看,图片里的文字以中英文为主、又想要高分辨率和低成本,选MiniMax;图片需要多语言,还要反复改图、分图层编辑,Seedream更稳妥。
一个拼尺寸,一个拼可控
两款新模型发布时,核心卖点几乎没有重叠,路线差异一眼就能看出来。
MiniMax H3-Image押注的是“更大、更快、更便宜”。
它由MiniMax的H3模型衍生而来,支持文生图、图像参考和图像编辑。官方称,它能在10秒内生成一张4096×4096、约16MP的图像,速度可达市面主流水平的5倍,价格只有同档位产品的50%到70%。MiniMax H3-Image还宣称拥有“开源模型中最强的指令遵循能力”,最多支持16张参考图,并开放了权重。
Seedream 5.5押注的则是“改得稳、能进生产线”。
Seedream 5.5 这次主要动了三处:多轮编辑过程中,没被改到的区域能做到像素级不变,官方演示连续编辑了100轮;原生支持 RGBA 透明素材,最多可拆成100层输出;写实质感和文字渲染方面,官方给出的严重文字崩坏率是0.4%。
同一套考题下,真实感难分高下,文字见真章
两家都具备的能力,我们挑了写实、文字和多图理解三个方向,一共设了四个案例;只有一家具备的能力单独验证,MiniMax测大分辨率图片生成,Seedream测图层拆分。
所有对比案例用同一条提示词,每条只生成一次,固定取第一张。所以结论反映的是单次表现,存在一定随机性。
测试用的参考图由第三方模型GPT Image 2.6生成,避免任何一款模型“见过”素材。另外,MiniMax默认输出约1680万像素,Seedream在230万到420万像素之间,理论上这对MiniMax在写实和文字两项测试中更有利。
1.早餐摊人像:两张都能乱真,一个像抓拍,一个像剧照
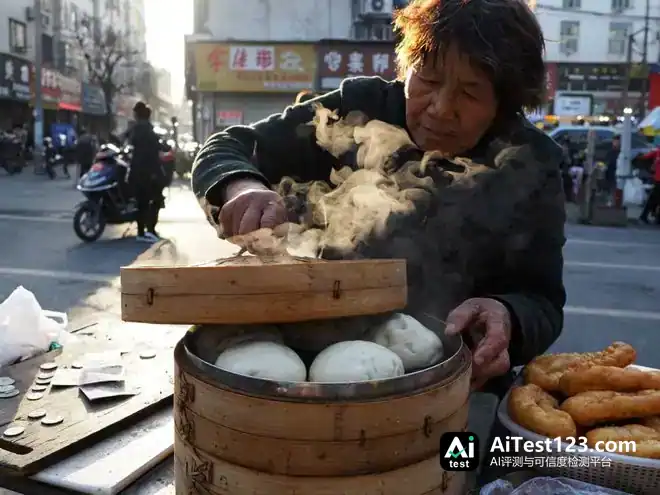
提示词要的是一张“手机随手拍”的逆光早餐摊:五十多岁的阿姨掀开蒸笼,热气被阳光照亮。两张图的人物和主体都没有明显AI痕迹,区别主要在风格和细节执行上。
Seedream给出的画面是标准的电影感,浅景深、金色轮廓光,蒸汽在逆光里层次分明,人物年龄也贴合描述。问题是它没有执行“手机随手拍”的要求,更像一张精心构图的摄影作品。
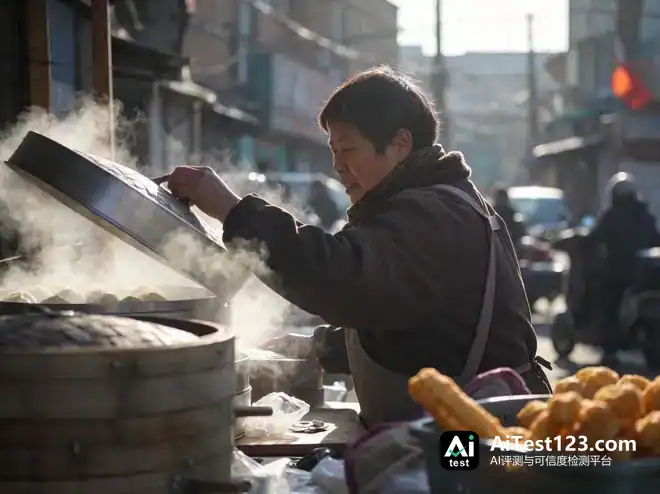
MiniMax 出来的画面更像真实街拍,广角、构图都很随意,阿姨脸上的斑点、皱纹,连手背的褶皱都看得清清楚楚。毛病有两个:人看上去明显不止五十多岁,比要求老了不少;背景招牌上的汉字成了一串认不出来的笔画。
2.雨夜大排档:Seedream的光影更讲道理
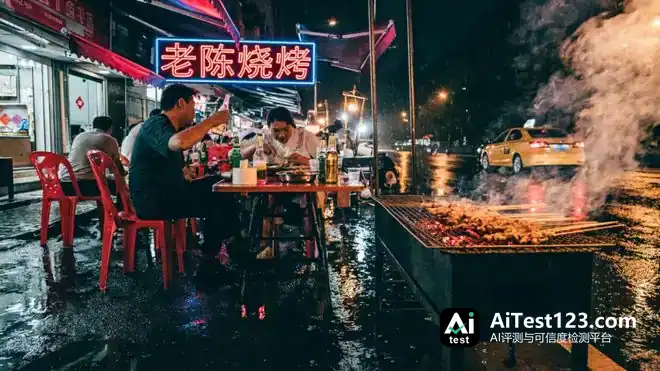
这一题考的是多光源、多材质的物理一致性。两家都把“老陈烧烤”四个字写对了。
Seedream把提示词里的物理细节落得更实:炉火把烤炉冒出的烟映成橙色,出租车尾灯也在湿漉漉的地面上拖出反光。
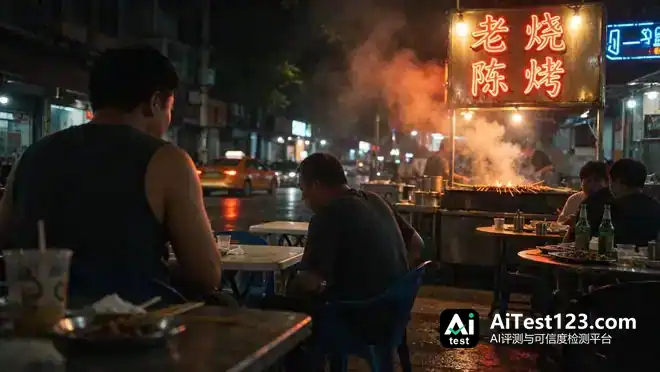
MiniMax那边的画面更抓眼,霓虹招牌和湿地倒影都很出挑。可它把“刚下过雨”画成了“正在下雨”,烟也没被火光染上颜色;整体饱和度和锐度都偏高,一眼能看出后期调色的痕迹。
3.十种语言欢迎墙:Seedream对19行,MiniMax对12行
测试方法是让两家各生成一面机场欢迎墙:10块灯箱依次排开,分别用简体中文、繁体中文、英文、日文、韩文、法文、德文、俄文、阿拉伯文和泰文,每块灯箱上写一行“欢迎来到上海”的大字、一行“行李提取请左转”的小字,合计20行,再逐字比对。
Seedream写对了19行。唯一出错的地方是泰文大字里一个辅音,阿拉伯文的连写与书写方向、法文和德文的变音符号都没有问题。
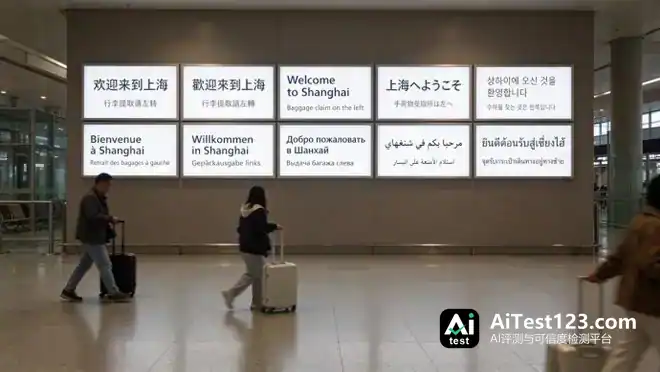
MiniMax写对了12行。中文简体繁体、英文、法文、德文全对,错处集中在剩下五种文字上:日文「ようこそ」被写成「ようここ」,韩文小字「왼쪽」被写成「왠족」;俄文小字把「слева(左边)」写成了「слава(荣耀)」,意思整个变了;阿拉伯文两行都有字母错误,泰文小字基本成了乱码。
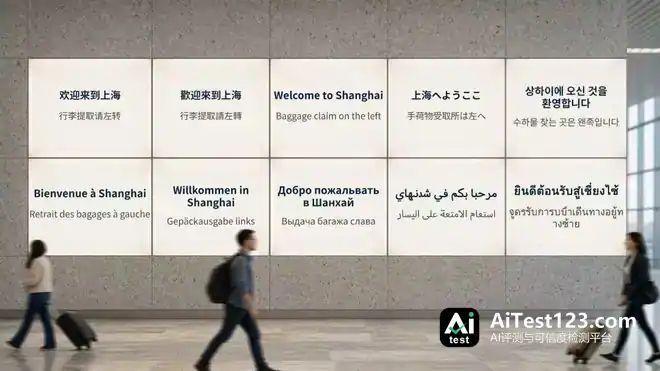
这张图MiniMax的分辨率是Seedream的四倍,像素不够这个理由显然站不住脚,问题更可能出在模型对长尾文字的掌握还不够扎实。Seedream发布时强调过文字能力的提升,这次测试正好对上了。
4.六图合一:两家各做对5项,丢分的地方正好相反
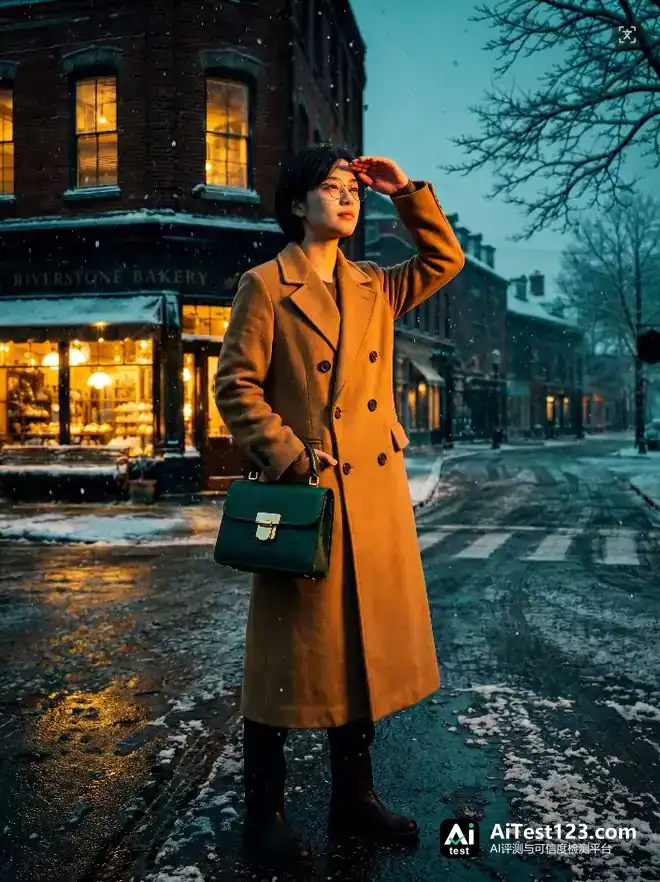
我们请GPT准备了6张参考图,要求模型让图1的女生穿上图2的大衣、肩背图3的包、站在图4的雪天街口、摆出图5的姿势,色调参照图6,但不能出现图6里的路灯和长椅。两款模型出的图都没串,人物、大衣、场景、色调都对,差别在细节怎么取舍。
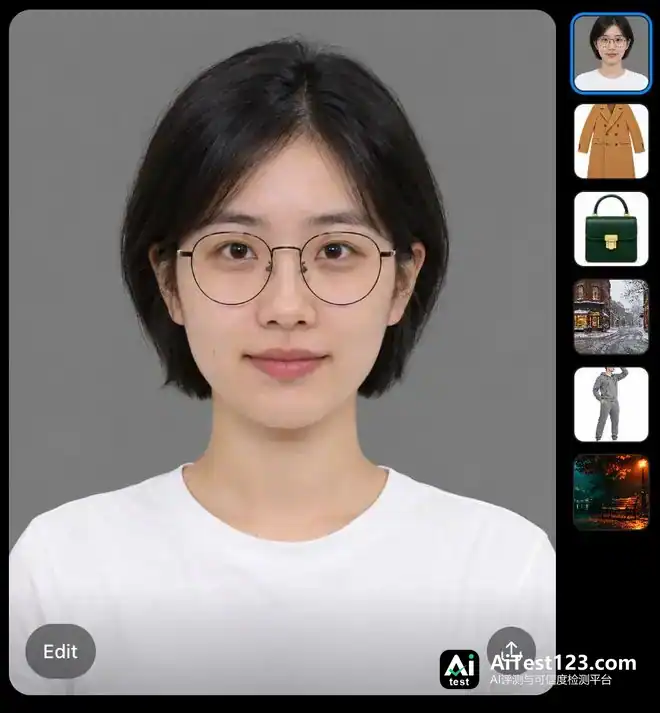
Seedream更听文字指令:那只包原本只有手提把,它给补了一条肩带,让人物背在肩上;代价是姿势只还原了一半,另一只手握着肩带,没插进口袋。色调也更收敛,看着更像真实照片。
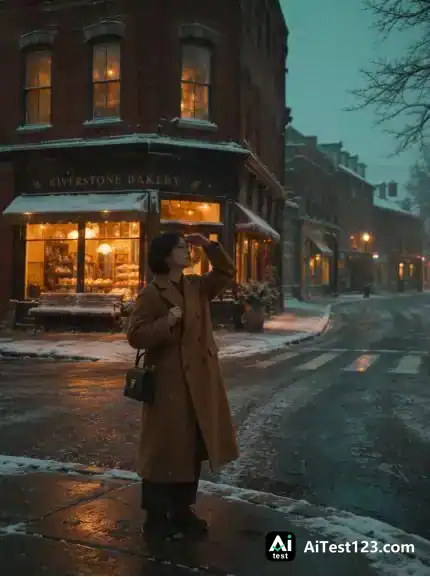
MiniMax更贴参考图本身,姿势还原得最完整,一手搭额、一手垂在口袋边,但包是拎在手里的,没背到肩上。整体色调上,它把青橙对比推得很重。
5.MiniMax的1680万像素:近处细节真实,远处照样糊
我们让MiniMax生成一张春运候车大厅的大场景,里面藏了6个小彩蛋,成图分辨率5472×3072。6个彩蛋全都出现了:举着“妈我到了”纸牌的小男孩、靠柱子睡觉的保安、显示“G1234北京南14:05正点”的电子屏,全都准确,只有泡面桶上的“红烧牛肉面”少了个“肉”字。
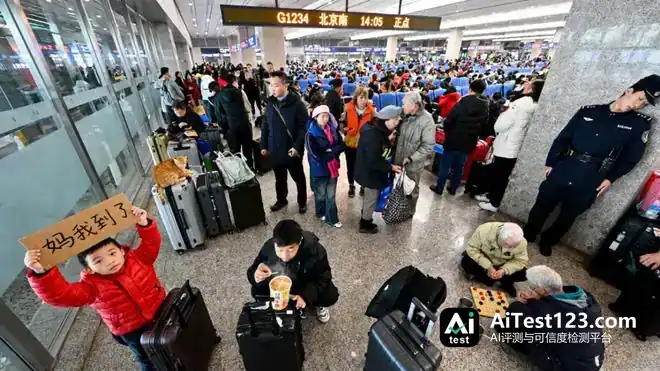
放大到100%看,前景的羽绒服褶皱、保安制服上的徽章、泡面的热气都经得起细看;但远处人群开始有融化感,人脸细节明显不够。分辨率是提上去了,画面细节的分布却不均匀。
6.Seedream的图层拆分:六层一次拆对,背景还能自动补全
我们拿一张GPT生成的《追风的女孩》电影海报交给Seedream,要求拆成人物、风筝、片名、小字、阳光光晕和背景六个透明图层,它一次就拆对了。人物层保住了飘动的发丝和手里的风筝线轴,风筝层带着细长的风筝线,片名的毛笔笔触和小字也都完整。
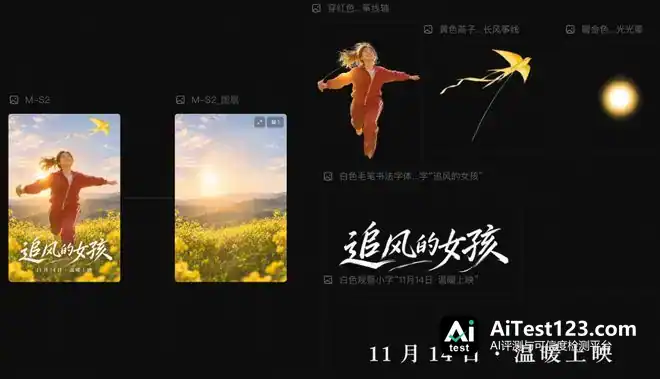
最实用的是背景层:女孩原来待的位置被自动补成连片的油菜花田和天空,在画布预览里看不出抠除的痕迹。对设计师来说,拿到手的不再只是一张图,而是一份能接着编排的源文件。
几轮测下来,结论很清楚:生图这块,写实已经不是护城河,交付能力才是。
图像模型在写实上早已过了门槛,“画得像”一旦成了标配,就很难再撑起竞争壁垒。
真正能拉开差距的,是一张图能不能直接拿去用。海报字写错了,再好看也交不了差;对出海品牌来说,阿拉伯文、泰文这类长尾文字偏偏是刚需。图层拆分也一样,输出从“成品图”变成了“可编辑的素材”。
两家的路线也就更清楚了。
MiniMax走基础设施路线,靠分辨率、速度、价格和开放权重去扩大使用面,开放权重也让社区有机会自己补上多语言文字这类短板。
Seedream走生产工具路线,多轮编辑、透明素材、图层拆分指向的是同一件事:嵌进电商、广告和设计团队的日常流程。
图像创作模型下一阶段的较量,大概率不在谁画得更像,而在谁能写得对、改得准、拆得开,把一次生成变成一份能交付的工作成果。