ArtArk登顶SuperCLUE:95.14分居首,图文一致性满分
国产文生图模型首度登顶全球第一!ArtArk 斩获 SuperCLUE 榜首:图文一致性唯一斩获满分
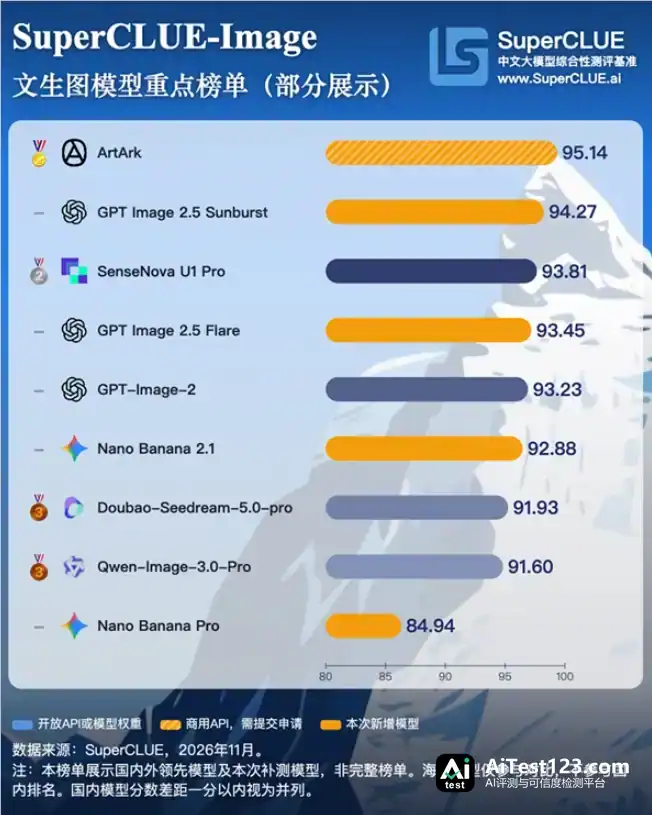
图像生成这条赛道又热闹起来了。11月10日, SuperCLUE 公布了2026年11月的文生图基准更新榜单。这回评测既拉来了海内外一批主流产品,也头一次把国内新模型 ArtArk 和 GPT 系列、Nano Banana 系列等补充测评对象放了进来。结果国产模型 ArtArk 跑出95.14分的综合成绩,拿下总榜第一,把 GPT Image2.5Sunburst 甩在了后面。
核心指标惊艳行业:图文一致性成为全场唯一满分得主
竞争这么激烈,ArtArk 能夺冠靠的不是某一项微弱领先,综合理解与还原能力都很能打。尤其在行业盯着看的“图文一致性”测试里,它拿到了所有参测模型中唯一一个满分。
图文一致性考的是什么?说到底是模型对用户文字指令的理解到底到不到位,能不能把复杂的文字描述精准变成画面。特定的人物、道具,还是复杂的空间场景和相互关系,模型不光要把画面做漂亮,还得照指令把所有细节还原出来。ArtArk 拿满分,说明它在复杂语义理解和画面对齐上已经站到了顶尖水准。
头部梯队竞争进入白热化:国产与海外产品差距微乎其微
看整张榜单的分布,全球顶尖文生图模型之间的技术差距已经被压到了极小的程度。
海外阵营里,GPT Image2.5Sunburst 以94.27分排在总榜第二,是海外参测产品中的最高分;同系列的 GPT Image2.5Flare 拿到93.45分,紧随其后。国产梯队这边,SenseNova U1Pro 以93.81分排在国内第二,Doubao-Seedream-5.0-pro 和 Qwen-Image-3.0-Pro 并列国内第三。前五名最高分和最低分之间只差1.91分,国内外头部产品咬得很紧。
各路模型各有所长:功能细分与技术迭代持续加速
总分虽然接近,但各款主流模型在具体能力上的优势明显不一样。
细节和汉字这块:汉字生成和现实复现两个项目,全场最高分都归了 GPT Image2.5Sunburst;Flare 则在整体图像质量和图文一致性(93.94分)上表现突出。
创作与布局方面:GPT-Image-2 在创意与推理项目上很强,得分96.81分,复杂信息布局也拿到94.04分;国内的 SenseNova U1Pro 最擅长复杂信息布局,以95.80分在所有参测模型中排第一。
系列迭代也在提速:Nano Banana 系列进步明显,Nano Banana2.1 是该系列最高分版本(92.88分),图文一致性和复杂信息布局能力比前代分别提升了9.09分和6.87分。
这轮测试说明,如今评判文生图模型早就不是只看“画面漂亮”。能不能准确理解人的指令、处理复杂画面布局、精准生成特定文字,已经成了衡量AI图像生成实力的核心硬指标。ArtArk 登顶也向业界证明,国产文生图模型已经有和海外头部产品正面掰手腕的实力。