阿里Qoduck揭晓为千问4,MiniMax曾匿名放出太空兔
阿里千问4来了,大模型都快卷疯了 阿里养了四天的鸭子,终于承认是自己家的了。 11月7日,阿里旗下AI编程产品Qoder突然上线了一款匿名模型,名叫Qoduck。 不公布模型厂商,不公布参数规模,连跑分成绩都藏着。开发者只能通过实际使用,猜测它究竟是哪家的模型。 由于Qoduck在编程速度、长程Agent任务等方面表现
千问4现身,大模型这轮竞争已经绷得很紧。
阿里那只挂了四天"匿名"牌子的鸭子,如今被官方认领了。
11月7日,阿里AI编程产品 Qoder毫无预告地上线了一个匿名模型,取名Qoduck。
参数规模没写,模型出自哪家没说,跑分数据也一并省去。开发者只能上手实测,再回头猜它是谁家的东西。
结果Qoduck在编程速度、长程Agent任务上表现亮眼,网上的猜测帖很快冒了出来。被提得最多的,是阿里还没发布的千问4。
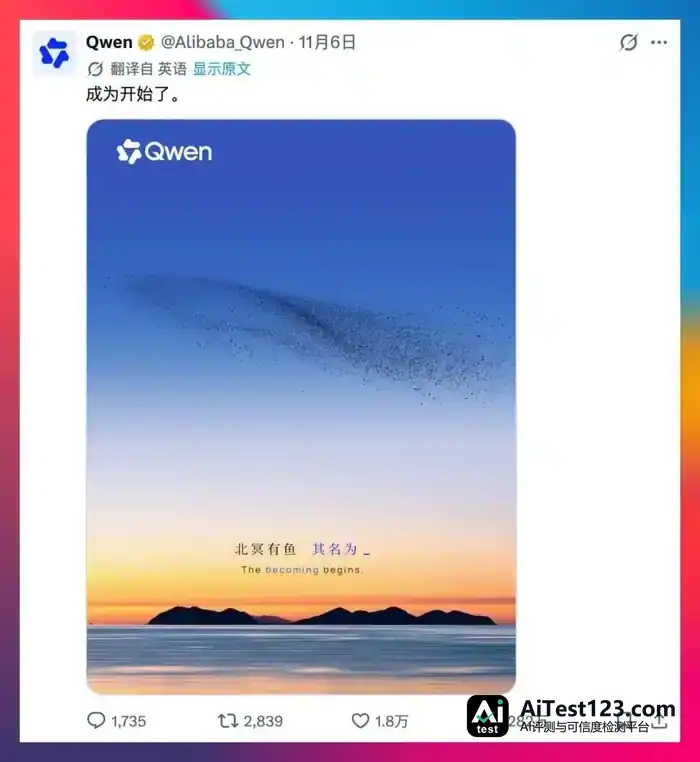
时间点也巧:Qoduck上线前一天,千问官方刚放出新模型的预热信号。
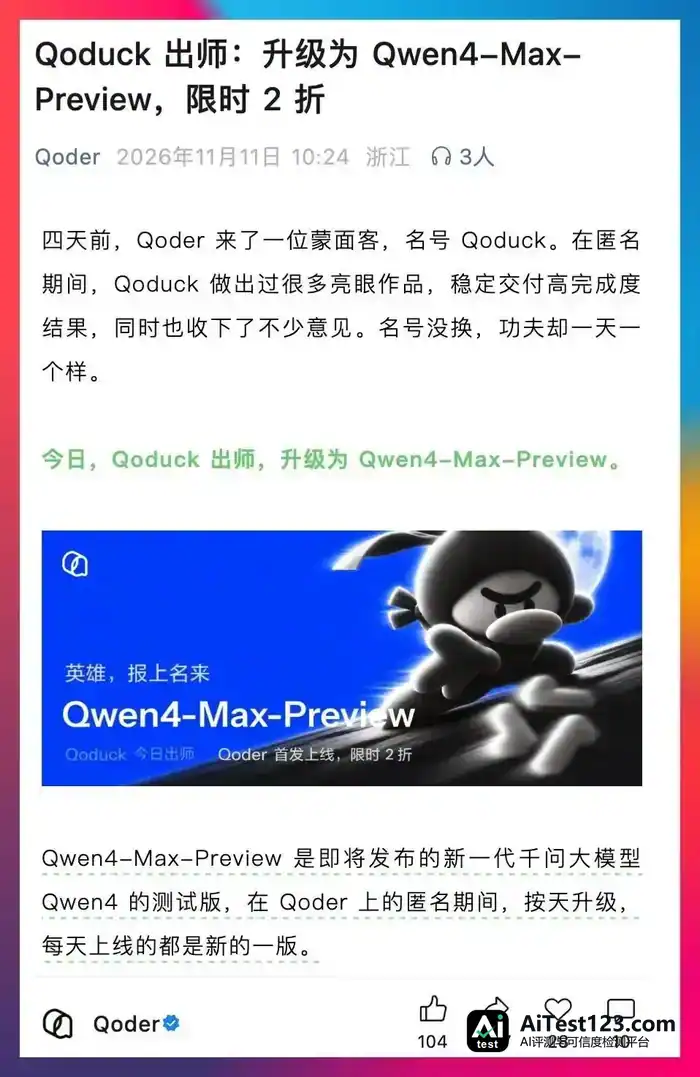
答案在今天落地。Qoder宣布,Qoduck就是Qwen4-Max-Preview,归入新一代千问4模型家族。
之前怪哥的猜测没错,阿里确实悄悄上线了一只代号为鸭子的大模型。
官方说法是,Qoduck匿名测试的四天里一直在改,每天放出的都是新版本。今天公开的Qwen4-Max-Preview,则是再升级一版的测试版本。
能力上,新模型加强了知识理解、编程和Agent执行,并特别提到对CAD、Blender、Figma、Revit、UE5等专业软件的操作。
Qoder同时给出限时2折优惠,模型Credits计费系数从0.5倍降到0.1倍。
01 阿里养了只鸭子,MiniMax放了只兔子
阿里这只鸭子,前头其实还有一位同路人。
10月19日,国内另一家大模型公司 MiniMax正式发布M3.1 Flash,顺带揭开了一个秘密。
此前在海外开发者社区颇为活跃的匿名模型Space Bunny(太空兔),正是MiniMax M3.1 Flash的早期版本。
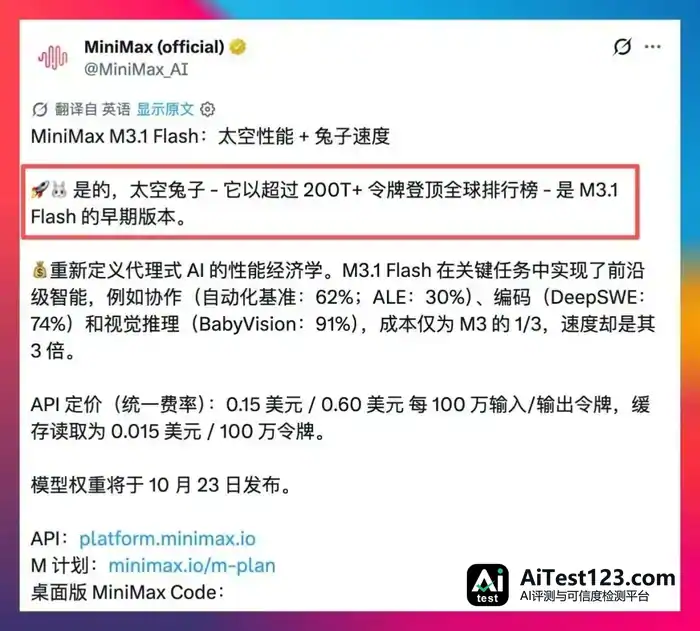
MiniMax官方披露,这只兔子匿名运行期间累计处理了超过200万亿Token。
200万亿Token是个什么量级?
假设每次模型调用平均吃掉1万Token,那也相当于200亿次调用。当然,这只是一次方便理解规模的换算,不等于实际请求次数。
MiniMax还宣布,新模型推理速度提升近3倍,Agent任务成本降低70%。
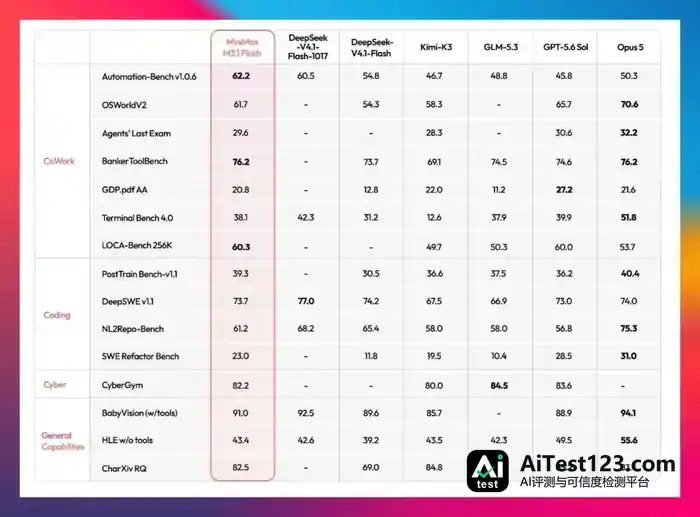
阿里养了一只鸭子,MiniMax提前放出一只兔子。
照这个路子走下去,国产大模型厂商凑出一个AI动物园只是时间问题。
玩笑归玩笑,这种匿名发布的做法有值得学的地方——注意力确实被抓住了。
以往发模型,厂商的流程是先亮参数、晒跑分,再摆Demo演示,最后才开放体验。
阿里和MiniMax把顺序倒了过来。
做法反过来:模型先上线,开发者用的时候并不知道背后是谁。等社区里讨论攒起来、测试结果也出来了,官方才现身认领。
这么一来,厂商能提早发现问题,拿到真实任务的数据,网友的猜测本身又带来一波传播。
大模型升级的消息如今多到让人麻木。怎么把眼球吸过来,成了各家市场团队反复琢磨的事。
02 一个月内八家大厂更新,第一名快不够分了
先看最近一个月各家都发了什么。
10月13日,Google开放Gemini 4 Argon,主打复杂推理、编程与企业知识工作。
10月17日,DeepSeek把V4.1 Flash做了升级,编程和Agent任务能力得到提升。
10月19日,MiniMax推出M3.1 Flash。
10月24日,Kimi发布K3.1 Pro,参数规模3万亿级,上下文100万Token,同时上线的Highspeed版本速度提升约2至3倍。
10月26日,OpenAI推出GPT-6.1 Terra,面向电脑操作、视觉推理等场景,已进入Codex和ChatGPT Work。
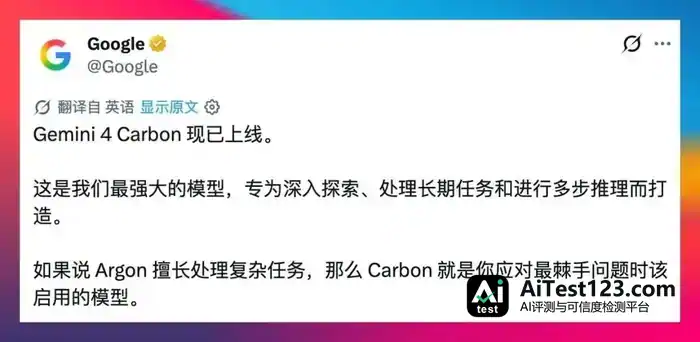
10月28日,Google公布更强的Gemini 4 Carbon,11月10日又向开发者、企业和用户进一步开放。
11月4日,腾讯发布混元4(Hy4),视觉理解和Computer Use电脑操作能力都是首次引入。
11月9日,Anthropic发布Claude Fable 5.2和Mythos 5.2,编程、推理、视觉理解均有提升,输出速度最高提高30%。

11月11日,阿里千问4预览版正式亮相。
这还没算上各家近期推出的小版本、专项模型和产品更新。
大模型厂商的发版节奏,已经比手机厂商还快。
并且大家都爱说自己拿了某个评测的第一。
Google的Gemini 4 Carbon曾在Artificial Analysis Intelligence Index登顶;Claude Fable 5.2在Anthropic公布的多项编程和科研测试中领先;Kimi K3.1 Pro在部分编程评测中超过GPT-6 Astra;腾讯混元4则强调了在开源模型中的竞争力。
这些成绩来自不同的评测项目、测试配置、推理预算和维度。说到底,第一就完事了。
可问题也来了。
Claude第一、Gemini第一、Kimi第一、腾讯第一、阿里第一,用户该信哪一个?
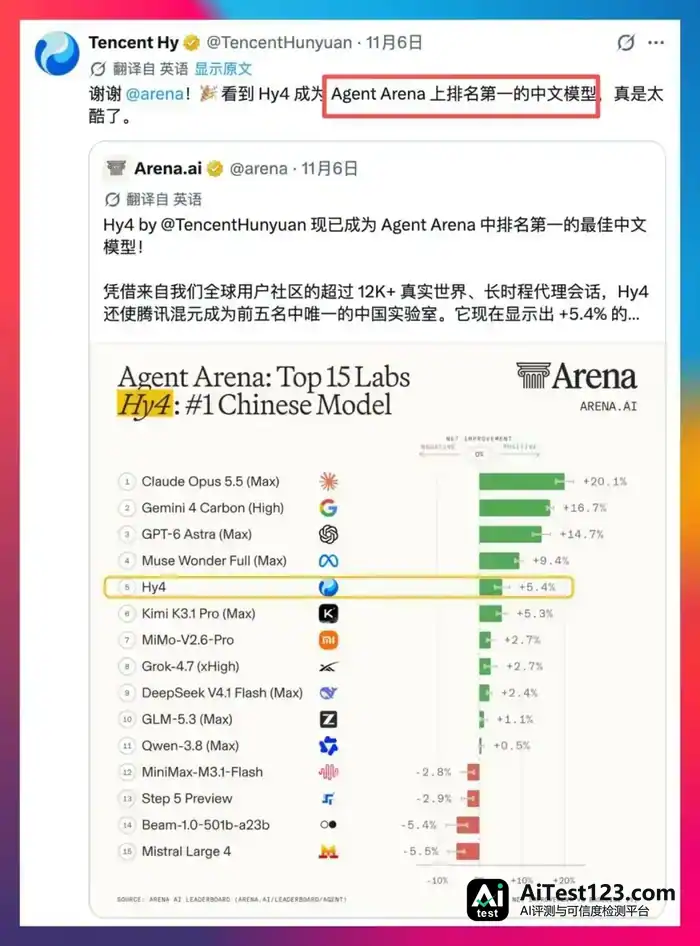
漂亮成绩单,每家公司都拿得出几张。
真用起来却是另一回事:有的模型代码写得不错,却爱把原来的文件改坏;有的推理强,执行速度慢得让人着急;有的演示复杂任务很惊艳,换个任务就翻车。
AI产品的演示视频,我看过太多了。
建个网站五分钟,做套PPT十分钟,连操作复杂软件都能一句话搞定。
真上手试的时候,多半还得自己查一遍、改一遍、返工一遍。
厂商台上摆出来的都是成功案例;落到用户手里,碰上的可能是五花八门的怪毛病。
这两年大模型的本事涨得很明显,这点我一点不怀疑。
可每回升级都打着重大突破的旗号,用户的胃口也就跟着被吊高。真用起来,提升的幅度未必有宣传材料吹的那么邪乎。
从模型变强到体验变好,中间卡着一堆产品层面的问题。
03 腾讯和阿里,连攻克的软件都撞上了
还有一处巧得不能再巧。
11月4日腾讯发混元4,特意把Computer Use能力拎出来讲,还专门拿Blender、CAD这类专业软件做了训练。
11月11日,阿里千问4的宣传重点也是CAD、Blender、Figma、Revit这些软件的操作本事。
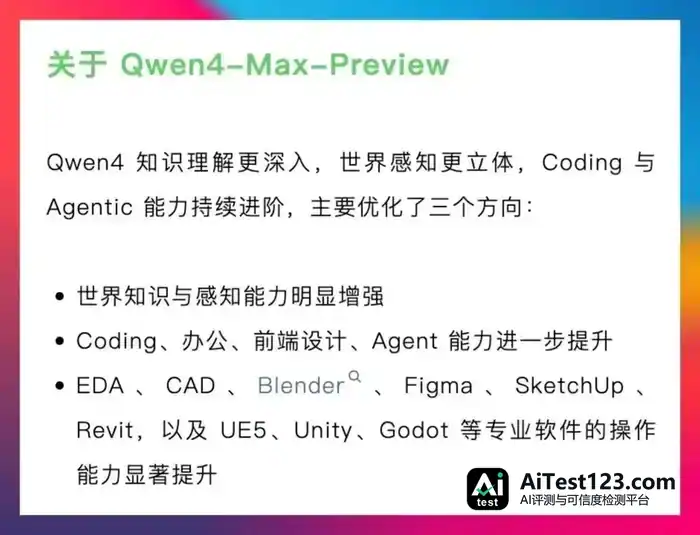
这一回,腾讯和阿里连主攻的软件都撞到一块儿去了。
Kimi K3.1 Pro也在往3D创作和长程Agent上使劲。
海外那边情况差不多。
OpenAI的GPT-6.1 Terra把电脑操作当优化重点,Gemini 4 Carbon盯的是复杂软件工程和长程Agent,Claude Fable 5.2则亮出了复杂编程、…件设计之类的能力。
几家顶尖模型厂商,眼下在啃的是同一批高度相似的任务。
换成厂商的视角,这事很好懂。
让AI写段文案,早就不算难事了。让AI把一整套复杂活儿独立干完,那市场可大得多。
问题是所有人都往一个方向挤,竞争就会变得特别狠。
假如千问4的编程能力压过Claude,开发者就会扔下Claude Code,立马转去Qoder吗?
恐怕没这么简单。
开发者早习惯了某款工具的操作方式,项目配置、工作流、团队协作流程,全是围着它搭起来的。
模型跑分高出几个百分点,未必够让用户换工具。
更头疼的是,AI编程工具已经开始支持多模型接入了。
用户在同一个工作台里就能切不同模型。底层模型之间的差距越缩越小,价格、响应速度、额度、稳定性,都会掺进最终的选择里。
对模型厂商来说,这实在算不上好消息。
花大钱训出来的新模型,用户可能就因为别家更便宜,随手把它从默认列表里撤了。
产品入口,是模型厂商得应付的另一道坎。
Claude、ChatGPT、Google的Antigravity,腾讯的WorkBuddy和CodeBuddy,还有阿里的Qoder、千问办公。
只要这些产品扎进用户的日常工作流,任务就会源源不断地产生,模型被反复调用,反馈也跟着攒下来。
大模型这仗,早就不只是比排行榜上的名次了,用户每天打开的那个工作台,也成了争夺对象。
阿里此番让千问4率先落地Qoder,这一点想必也在考量之中。
04 能力往上走,价格却往下掉
价格是另一个让人唏嘘的地方。
千问4预览版在Qoder限时2折,腾讯混元4推出限时优惠,MiniMax M3.1 Flash把Agent任务成本降低70%,阿里云的订阅套餐也官宣降价了。
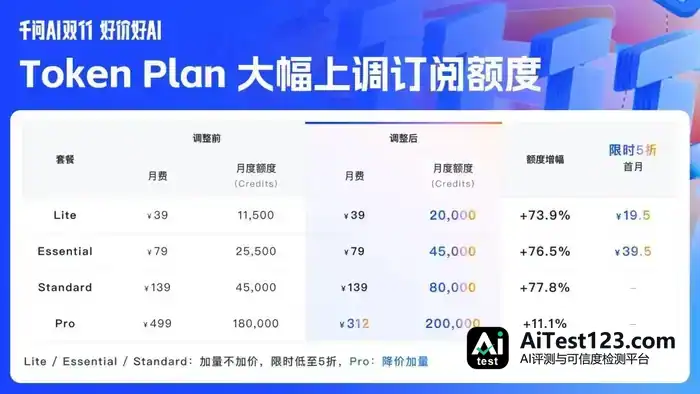
DeepSeek升级V4.1 Flash,API价格没动,模型能力和执行效率倒是继续往上提。
降本这件事,海外厂商同样在干。
Claude Fable 5.2比前代跑得更快,价格也往下调了。OpenAI推出GPT-6.1 Terra,给高频电脑操作任务开出了更低的API价。
各家的计费方式不一样,折扣没法直接拿来比,可降价已经成了抢开发者的常规动作。
站在用户这边,这当然是好事。
轮到模型厂商,压力恐怕就大了。
训新模型要钱、要算力、要人。能力刚有突破,对手转眼就跟上,价格还得接着压。
Agent产品尤其如此,一项复杂任务,模型可能要被调用几十次、上百次。
用户最后盯的,无非是花多少钱、等多久、活儿有没有干完。
一款便宜模型能搞定90%的任务,另一款贵的能搞定95%,那5%的差距,用户愿不愿意掏几倍的价钱?
任务不同,答案也不同。
大企业可能格外看重稳定性、安全和准确率,普通开发者或个人用户,反倒更愿意挑性价比高的那款。
到头来,同一家厂商既得训最强的旗舰模型,也得拿出速度更快、成本更低的版本。
MiniMax的Flash、OpenAI的Terra、Kimi的Highspeed,反映的都是能力、速度、成本之间的不同取舍。
照我看,往后不少大模型会越来越接近云计算的资源形态。开发者用API调用、按量付费,任务需要什么就随时切换。
这个市场照样能做得很大。但模型公司的议价空间,会持续被产品入口、开源模型和低价竞争三头挤压。
05 千问4来了,阿里能赢回多少用户?
再回看阿里这次发的千问4。正式版还没上线,具体性能也要等更多独立评测来验证。不过阿里已经借Qoder把新模型放进了真实的开发环境。
匿名测试能攒下实际任务的数据,限时低价能拉用户来试,正式版还能照着反馈接着调。
对手当然也不会停。腾讯混元4刚发,Claude和Gemini几乎同步升级,DeepSeek、Kimi、MiniMax也都亮出了各自的新模型。
这一轮模型大战,最大的变数恐怕是:模型越来越强,可单次升级给厂商带来的竞争优势未必撑得久。
一家公司今天发了最强的编程模型,明天对手可能就把榜单刷了。某款模型在一个测试里拿了第一,换个测试项目,领先的又换人了。
厂商能一轮轮发新版本,用户却没理由跟着每场发布会换工具。
从产品这边看,我更在意千问4接下来能给Qoder带来多少实际用量,以及阿里能不能把这套模型能力铺到千问办公、钉钉等更多工作场景里去。
Claude、GPT、Gemini也躲不开类似的考验。这些公司手里已经握着世界一流的模型,可用户每天到底打开谁家的产品,变数仍然很多。
过去两年,大家抢的都是“最强大模型”这个名号。往后,厂商恐怕还得去争一个更实在的位置:用户工作台里的默认模型。
这个位置,可能比排行榜第一名还值钱。