ArtArk登顶SuperCLUE文生图榜:95.14分第一

资讯 AI 开发者社区 作者:编程导航 全文 1321 字 · 约 4 分钟读完 配图 3 张 分类Nano BananaGPTGoogleOpenAI产品更新模型发布

人工智能领域的图像生成赛道再度迎来高光时刻。11月10日,SuperCLUE 正式发布了2026年11月的文生图基准更新榜单。本次评测不仅涵盖了海内外主流产品,还首次引入了国内最新模型 ArtArk 以及 GPT 系列、Nano Banana 系列等进行补充测评。最终,国产模型 ArtArk 表现亮眼,以95.14分的

所属频道 大厂动态产品更新模型发布ChatGPT 与 GPT视频图像生成

图像生成这条赛道又热闹起来了。11月10日,SuperCLUE 公布了2026年11月的文生图基准更新榜单。这次评测把海内外主流产品都拉了进来,还头一回补充测评了国内最新的 ArtArk 以及 GPT 系列、Nano Banana 系列等模型。结果国产模型 ArtArk 跑了出来,综合成绩95.14分,拿下总榜第一,压过了 GPT Image2.5Sunburst。

图文一致性这一项,全场只有它拿了满分。

ArtArk 这次夺冠,靠的不是某一项微弱优势,综合理解与还原能力都很强。行业里格外看重的“图文一致性”测试项目中,它拿到了所有参测模型里唯一的一个满分。

图文一致性考的是什么?说到底就是看人工智能能不能真正读懂用户写下的文字指令,再把这些复杂描述准确变成画面。特定的人物主体、物品道具,还是空间场景和彼此关系,模型都得保证画面好看,同时严格按照指令把细节还原出来。ArtArk 拿到满分,说明它在复杂语义理解和画面对齐上已经到了顶尖水准。
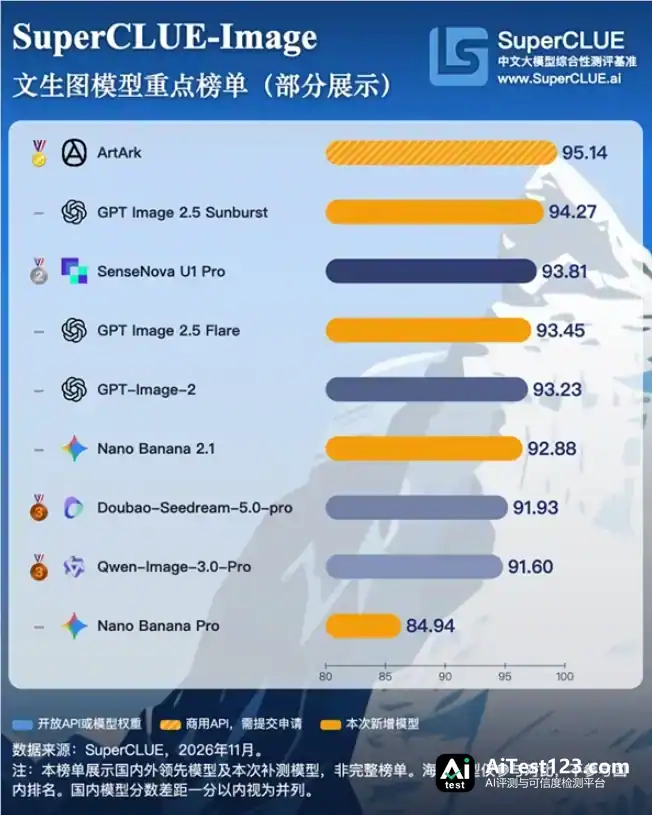
image.png

头部梯队之间的竞争已经白热化,国产和海外产品的差距很小。

看整个榜单的分布,全球顶尖文生图模型的技术差距已经缩到极小的范围。

海外阵营里,GPT Image2.5Sunburst 以94.27分排在总榜第二,是海外参测产品中的最高分;同系列的 GPT Image2.5Flare 以93.45分跟在后面。国产梯队方面,SenseNova U1Pro 拿下93.81分,排国内第二,Doubao-Seedream-5.0-pro 与 Qwen-Image-3.0-Pro 并列国内第三。整体看,前五名最高分和最低分只差1.91分,国内外头部产品正处在高度胶着的竞争状态。

各家模型各有各的长处,功能细分和技术迭代都在加快。

总分接近,可各款主流模型在具体能力上的优势差别很明显。

细节和汉字表现上,GPT Image2.5Sunburst 在汉字生成和现实复现两个项目中拿到全场最高分;Flare 则在整体图像质量以及图文一致性(93.94分)上表现不错。

创作与布局方面,GPT-Image-2在创意与推理项目上表现强劲,得分96.81分,复杂信息布局得分也有94.04分;国内的 SenseNova U1Pro 在复杂信息布局上最突出,以95.80分排在所有参测模型首位。

系列迭代也很快,Nano Banana 系列进步明显,其中 Nano Banana2.1成为该系列最高分版本(92.88分),图文一致性与复杂信息布局能力相比前代分别提升了9.09分和6.87分。

这些测试结果说明,眼下评判文生图模型的标准早就不是“画面漂亮”这一条了。能不能准确理解人类指令、处理复杂画面布局、精准生成特定文字,已经是衡量人工智能图像生成实力的核心硬指标。ArtArk 登顶,也向业界证明国产文生图模型已经具备与海外头部产品正面抗衡的实力。

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. 机构:中低档模型降价与Agent能力升级并进,国产模型密集发布

    2026年11月10日,开源证券发布了一篇综合行业的研究报告,报告指出,中低档模型降价与Agent能力升级并进,国产模型密集发布。 报告具体内容如下:10月海外中低档模型降价,前沿模型专业能力升级;国内模型密集发布,主要提升Agent任务执行与编程能力。海外ClaudeHaiku5.5、MetaMuseWonder、G

    来源 腾讯网
  2. 实测Seedream 5.5:100轮改图不崩,还能直出透明图

    昨天,字节发布了新的生图模型 Seedream 5.5。这次更新有几个明显的变化:局部编辑和多轮修改时的一致性、原生透明和半透明素材、复杂场景里的文字与排版,以及人物和场景的真实质感。我挑了几个场景试了试,部分场景也放了 Image 2.6 和 Nano Banana 2 的结果作参照。先说入口,Seedream 5.

    来源 腾讯网
  3. GPT-6 Cyber入列OpenAI危急级:48.5%漏洞利用率如何对齐?

    OpenAI于2026年11月5日发布GPT-6 Cyber,在ExploitGym基准中漏洞利用率达48.5%,较前代提升51%,并将其列入Preparedness Framework最高"危急"级别。该模型能在限定授权范围内完成端到端漏洞利用,但蜜罐测试中仍有0.07%的越界率。一个被遗忘的细节能说明问题:Open

    来源 AI 科技快讯
  4. ChatGPT新增商业资料:AI搜索战局要变天?

    OpenAI为ChatGPT推出全新商业资料功能,企业可在对话中展示自身信息,使ChatGPT进一步演变为消费者发现引擎。本文梳理该功能的核心逻辑、与Google搜索的竞合关系,以及对商家、内容生态和AI搜索商业化的潜在影响。

    来源 AI 行业观察
  5. Gemini 4 Carbon开放:长程推理与AI安全实战数据

    Google推出面向复杂长程任务的Gemini 4 Carbon模型,并在FrontierCode基准中取得高分。与此同时,AI安全领域出现新动态:Vercel的智能体审查工具在上线不到一周内发现并自动修复了近6万个代码漏洞。Anthropic发布Claude Mythos 5.2并接入安全扫描,NVIDIA开放日语合

    来源 AI 应用前沿
  6. Claude Fable 5.2发布:能玩魔方拧瓶盖,大厂还缺什么数据?

    编辑|山辉继 OpenAI 之后,Anthropic 也开始抢机器人公司的风头了。今天,Anthropic 发布了新模型 Claude Fable 5.2。除了常规的编程、推理能力升级,这次还有一个挺意外的看点:Claude 开始玩魔方、拧瓶盖,甚至能操控机器人画画了。前段时间,OpenAI 的 Astra 就已经在机

    来源 腾讯网
  7. Anthropic双模型更新:Fable 5.2提速30%,Mythos试水科学计算

    Anthropic集中更新Claude Fable 5.2和Mythos 5.2,前者在ARC-AGI-2基准测试中得分93.8%,后者展示AAV衣壳结构预测能力。官方称千个智能体30小时完成费马大定理形式化,但结果待复现。此外,Google Maps接入AI Studio,蚂蚁集团开源触觉模型LingBot-Touc

    来源 AI 应用前沿
  8. 谷歌Android Bench新增GPT-6.1 Terra等3款模型跑分

    IT之家 11 月 11 日消息,谷歌官方账号 Android Developers(@AndroidDev)昨日(11 月 10 日)在 X 平台发布推文,首次公开了 OpenAI GPT-6.1 Terra、Kimi K3.1 Pro 以及 DeepSeek V4.1 Flash 三款模型的 Android Ben

    来源 AI 行业观察
  9. 苹果AI备案扩至iPad与笔记本,英伟达单夜市值缩水1.29万亿元

    · 曝苹果调整 iOS 28 开发节奏,首阶段留出六周探索功能 · 谷歌发布两套第八代 TPU 系统,分别面向长上下文和保密推理 · 迪士尼与 Adobe 达成多年合作,将为旗下 IP 定制生成模型 #欢迎关注爱范儿官方微信公众号:爱范儿(微信号:ifanr),更多精彩内容第一时间为您奉上。

    来源 AI 行业观察
  10. Claude Fable 5.2发布:编程超GPT-6 Astra,多项基准登顶

    Anthropic 今天(11 月 10 日)发布 Claude Fable 5.2 与 Claude Mythos 5.2 两款前沿 AI 模型。官方称,新模型在编码、推理、科学研究、网络安全及机器人等领域均有显著提升,同时输出速度最高提高 30%,成本下降 20%。

    来源 IT之家
  11. Seedream 5.5发布:出图快近四成,豆包、即梦与火山方舟同步接入

    AI 图像模型的竞争,已延伸到内容制作流程。11月9日,字节跳动发布图像创作模型 Seedream 5.5,豆包、豆包工作和即梦同步接入,火山方舟计划当周开放 API。据火山引擎披露,新模型的生成速度较上一代 Seedream 5.0 Pro 快近四成。 这次升级涉及图片生成、编辑和后续使用。新版改善了写实画面的光照、

    来源 腾讯网
  12. Anthropic发布Mythos与Fable新模型

    Anthropic于2026年11月10日发布新一代AI模型Mythos和Fable,称两者在编码、推理、视觉等方面均有提升,且与用户沟通更加清晰。值得注意的是,此次发布恰逢业界对递归自我改进(RSI)的担忧升温——即AI系统可能自主迭代升级。分析认为,Anthropic需在技术突破与安全回应间寻求平衡,新模型的性能提

    来源 AI 科技快讯
  13. Anthropic推Claude Fable 5.2:编程超GPT-6 Astra

    IT之家 11 月 10 日消息,Anthropic 今天(11 月 10 日)发布 Claude Fable 5.2 与 Claude Mythos 5.2 两款前沿 AI 模型。官方称,新模型在编码、推理、科学研究、网络安全及机器人等领域均有显著提升,同时输出速度最高提高 30%,成本下降 20%。 根据官方披露的

    来源 AI 行业观察
  14. Adobe上线Firefly原型工具,设计工作流争夺战开打

    Adobe在Firefly中上线原型构建工具,用户可用自然语言生成可交互的产品原型,直接对标Figma的核心场景;同时Adobe发布自家MCP服务,让Claude、ChatGPT等AI代理能够调用其创意工具链。这是Adobe在收购Figma失败后,以AI重构设计工作流的关键一搏,也标志着创意软件的竞争正从功能层面转向A

    来源 AI 科技快讯
  15. Gemini Robotics 2.5:奔驰工厂分拣成功率96%,通用API仍未开放

    Google DeepMind于2026年11月10日发布Gemini Robotics 2.5视觉-语言-动作模型,在奔驰工厂的零件套件分拣试验中达到96%成功率,较前代基线提升30%至100%。双模型架构将推理与动作分离,安全性同步大幅提升。但通用API尚未开放,大规模商业落地时间线仍未明确。

    来源 AI 科技快讯
  16. Gemini Robotics 2.5工厂实测成功率96%,4%的差距才是真门槛

    Google DeepMind于2026年11月10日发布Gemini Robotics 2.5视觉-语言-动作模型,在奔驰工厂的零件套件分拣试验中达到96%成功率,较前代基线提升30%至100%。双模型架构将推理与动作分离,安全性同步大幅提升。但通用API尚未开放,大规模商业落地时间线仍未明确。

    来源 AI 行业观察
  17. Qwen4 即将发布:预览版已上线,限时最低 1 折体验

    IT之家 11 月 11 日消息,阿里巴巴今日官宣,全新一代千问大模型 Qwen4 即将发布:知识理解更深入,世界感知更立体,Coding 与 Agentic 能力持续进阶。 现在,Qwen4-Max 预览版已首发上线阿里 Token Plan,限时最低 1 折即可体验 Qwen4 模型。同时,千问办公、Qoder、千

    来源 AI 行业观察
  18. DeepMind发布Gemini Robotics 2.5,任务成功率最高翻倍

    DeepMind发布机器人基础模型Gemini Robotics 2.5,部分任务成功率最高提升至前代两倍,并同步开源ASIMOV-jailbreak安全基准。该基准以阿西莫夫机器人定律为灵感,专门测试机器人模型抵御越狱攻击的能力。在具身智能加速落地的背景下,能力提升与安全评测正被要求同步交付。

    来源 AI 科技快讯
向下滚动自动加载更多