美团1.6万亿参数大模型开源!累计Token用量破千亿,四项测试位列第一
总参数量1.6万亿,每个Token激活约480亿参数。

智东西(公众号:zhidxcom)
作者 | 孙小雯
编辑 | 程茜
智东西11月10日报道,昨晚,美团LongCat团队开源原生多模态模型LongCat-2.5。据OpenCode公开数据,截至今日上午12时,LongCat-2.5在该平台的累计Token用量约1090亿,独立用户约4700名,已完成约5万次会话。
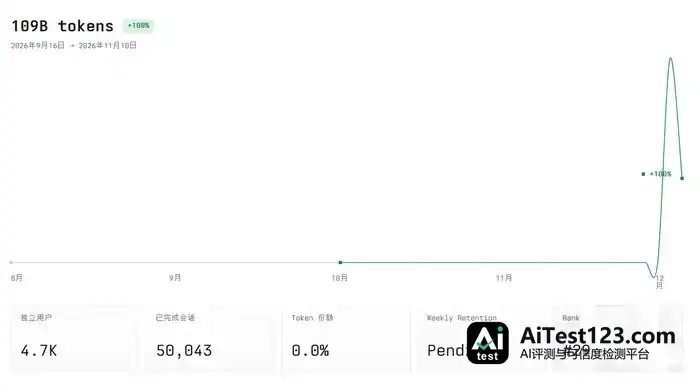
▲LongCat-2.5在OpenCode上的公开数据(图源:OpenCode)
LongCat-2.5采用MIT协议开放这款1.6万亿参数模型,支持商用推理部署与二次训练,无需额外授权。
一位X上的网友赞称,如此大规模的模型采用较为宽松的MIT协议开放,对开发者来说是一大利好消息。
▲一位开发者的评论(图源:X)
在LongCat-2.5开源当天,开源AI编程工具OpenCode即宣布,该模型在平台限时免费两周,支持多模态和百万Token上下文,免费入口每天限100次请求。
在美团公布的完整评测表中,LongCat-2.5与Claude Opus 5、GPT-5.6-Sol、GLM-5.3、Kimi K3、DeepSeek-V4.1-Flash等共9款模型参与比较,覆盖31项测试。
其中,LongCat-2.5在联网检索测试BrowseComp、跨领域智能体测试ALE v1.1、深度研究测试ResearchRubrics和文字生成3D代码测试3DCodeBench四项评测中,分别取得91.9、38.5、81.0和55.4分,在9款模型的已公布成绩中排名第一。
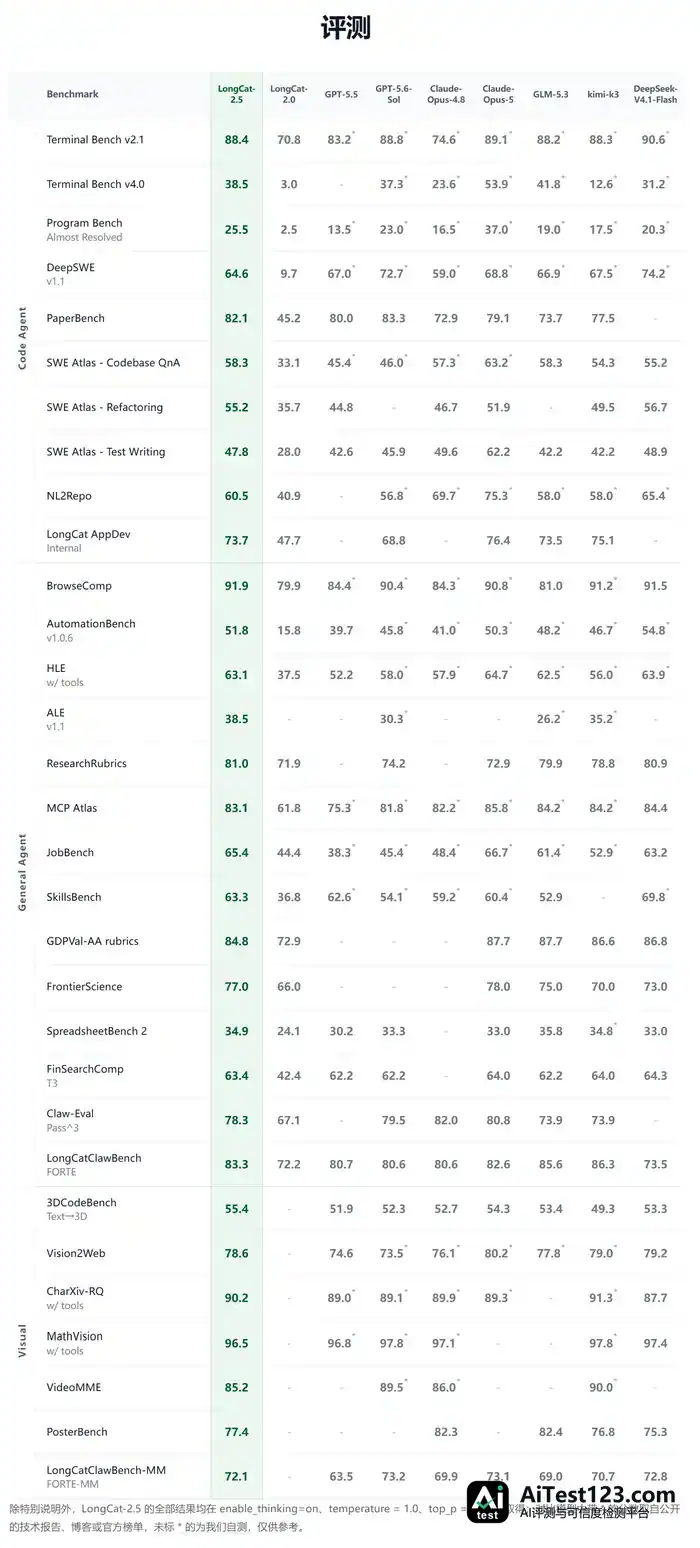
▲LongCat-2.5与其他8款模型的完整评测表(图源:美团)
LongCat-2.5于11月2日正式发布,主要面向复杂代码库开发、完整项目构建、视觉编程和专业办公等长程任务,总参数量1.6万亿,每个Token激活约480亿参数,支持100万Token上下文。
模型发布后,开发者陆续晒出了3D小店、水族馆、游戏和经营分析网站等作品。美团此次开源公告选取了其中一批演示,从演示画面来看,生成的3D场景有较丰富的光照和动态效果,网站也基本实现经营所需的功能。
此次开放的资源包括模型权重和W4A4量化版本,美团还提供了基于SGLang-FluentLLM项目的NPU部署说明,便于开发者在国产算力上部署模型。
▲LongCat-2.5开源主页(图源:Hugging Face)
此前,美国AI研究机构Nous Research也已通过旗下模型服务平台Nous Portal提供一周免费体验。LongCat官方平台也已提供Claude Code、Codex、OpenCode和Hermes等工具的接入说明。
API定价方面,LongCat-2.5目前的限时优惠价为每百万Token输入2元、输出8元,缓存命中输入0.04元,明显低于前述参与评测的四款海外模型。
但和国产模型相比,价格优势就没那么突出。DeepSeek-V4.1-Flash在26项可比测试中,有14项得分高于LongCat-2.5。其更新版Flash-1017的高峰价格与LongCat-2.5相同,空闲时段还能便宜一半。
相比同为1.6万亿总参数的DeepSeek V4-Pro-0813,LongCat-2.5的三项单价则均更低。
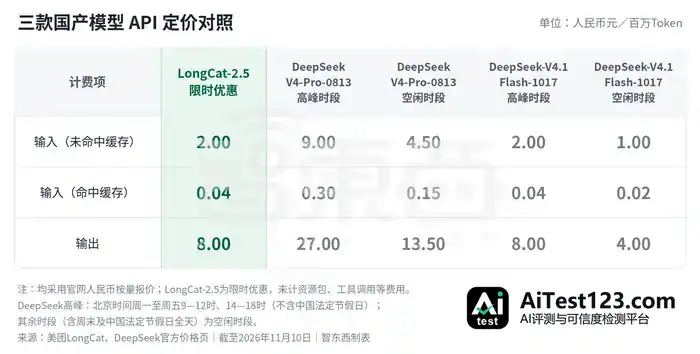
▲LongCat-2.5与DeepSeek两款模型的API价格对比(数据来源:各厂商官方价格页,智东西制表)
开源地址:
https://huggingface.co/meituan-longcat/LongCat-2.5
量化版本:
https://huggingface.co/meituan-longcat/LongCat-2.5-W4A4
一、开发者晒出实测作品,搭建可交互3D场景、经营分析网站
在开发者晒出的案例中,LongCat-2.5已经能够生成较完整的3D场景,并实现视角切换、角色操控等交互功能。也有开发者用它搭建经营分析网站,将交易明细、退款和经营损失等信息整合在同一套工具中。
视觉编程方面,科技博主cxuanAI制作了一座用LongCat-2.5生成的可切换视角的水族馆。画面起初呈现游客在展厅内观看水族箱的视角,玻璃前保留了游客剪影,水中有鲸鲨、蝠鲼和成群小鱼游动。
随着视角进入水下,鱼群在岩石和水草之间聚集、散开,鲸鲨从镜头附近游过。页面右侧还设置了控制面板,演示者可以调整观察视角和光照效果。
▲cxuanAI制作的水族馆页面(视频来源:公众号)
从画面来看,蓝绿色调、顶部透入的光线和远近不同的鱼群共同形成了水下纵深感。视角切换后,岩石、水草和海洋生物仍保持统一的视觉风格,场景整体感较好。
游戏开发方面,开发者AI异类弗兰克展示了一款用LongCat-2.5生成的多场景打斗游戏。画面采用斜俯视角,雨夜村落中,青瓦房屋、暖黄色窗光和红灯笼分布在石板路两侧。角色在街巷中移动,与成群敌人交战,攻击时出现环形特效。随着战斗推进,页面还会弹出“武学参悟”界面,供玩家选择新的武学技能。
▲AI异类弗兰克制作的打斗游戏(视频来源:公众号)
AI异类弗兰克称,模型生成的游戏前端设计和动态交互效果令他较为满意。其中,水墨武侠游戏的互动流畅自然,在增加多场景打斗和武侠技能后,玩法也更丰富。
专业办公方面,开发者路人甲TM展示了一套用LongCat-2.5生成的电商经营分析网站。网站以总览页面呈现经营结余和收入、支出变化,并设置交易明细、退款分析及损失分析等页面。
▲路人甲TM制作的电商经营分析网站(视频来源:美团)
画面中,演示者打开交易记录的分类修改弹窗,并在不同页面间切换,查看退款分布和经营损失构成。网站将总览指标、交易明细和专项分析分层呈现,图表与对应数据放在同一页面,便于使用者查看经营结果及具体收支项目。
不过,也有X用户反馈,LongCat-2.5正式版仍会出现循环推理。一位开发者认为,模型虽能调用已有知识、进行较全面的推理,但有时会反复绕圈,产生冗余内容,影响执行效率。
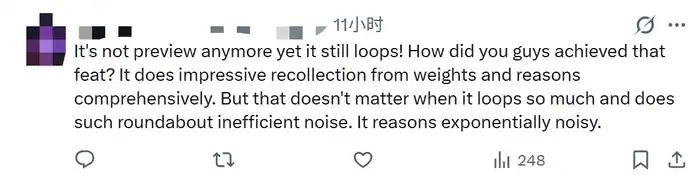
▲一位开发者对LongCat-2.5循环推理问题的反馈(图源:X)
二、多项技术能力升级,国产算力微调吞吐提升86%,推理吞吐提升约43%
LongCat-2.5的相关技术设计涉及视觉表征、大规模智能体强化学习和多专家在线教学等,分别支撑多模态信息处理、长程任务执行和不同领域能力的融合。
首先是视觉编程与3D任务。模型对图像的原生分辨率特征进行残差向量量化,生成多层级离散Token,再与文本Token一起交给主干模型处理。视觉Token对应的嵌入表示与主干模型联合训练,支持视觉理解与代码生成的结合。
训练时,固定的视觉分词器可以提前生成并缓存视觉Token,主干模型直接读取处理后的序列,减少训练过程中的在线视觉计算,并简化长序列的打包、切分与负载分配。
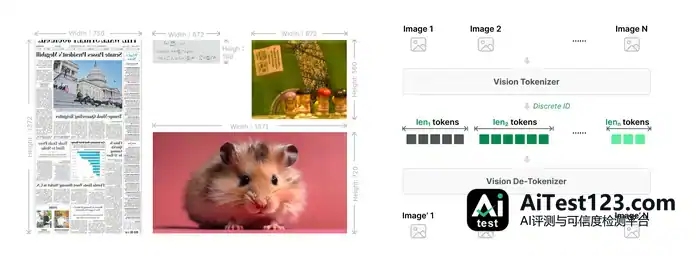
▲不同分辨率的图像被编码为离散Token序列(图源:美团)
其次是代码开发与长程智能体任务。该团队从训练数据、强化学习调度和行为约束等方面扩展训练链路,将真实智能体的失败过程转化为可复现、可验证的训练任务。
在强化学习采样阶段,系统会保存未完成的长任务轨迹,并在后续采样阶段恢复执行;对于跨模型检查点生成的旧轨迹,则通过调整梯度贡献减少样本陈旧带来的偏差。任务环境还会断网、清除Git历史和文件缓存,训练中对重复思考、重复工具调用等行为施加约束。
在终端操作测试Terminal Bench v4.0中,LongCat-2.5取得38.5分,上一代为3.0分。
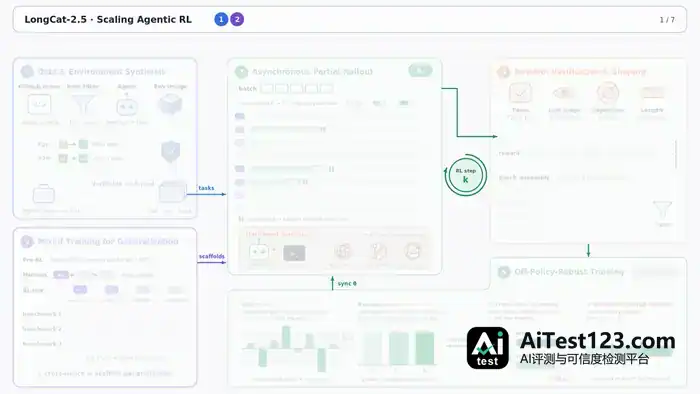
▲LongCat-2.5从多个环节扩展长程任务训练(图源:美团)
第三是专业办公与商业分析。模型沿用多专家在线教学机制,由学生模型在不同领域任务中生成回答,再根据领域专家与学生模型的输出概率分布差异进行训练,将Agent、推理和交互能力融入主线模型。
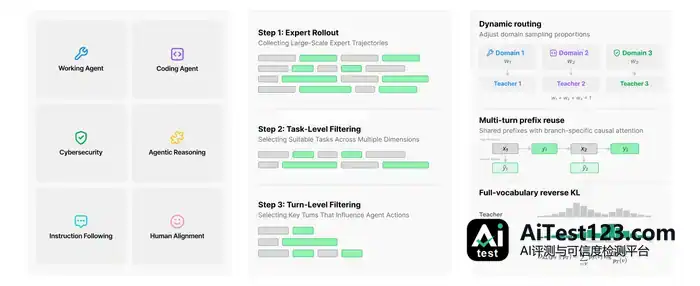
▲多专家在线教学流程(图源:美团)
为控制长回复训练中的分布偏移,该团队将教师回复按固定长度切分,并限制学生采样长度;通过共享输入处理计算与缓存、引入Tree Attention,减少同组样本的重复计算和存储开销。
多专家在线教学与长程强化学习等设计共同服务于材料处理、分析和交付任务。在职业任务测试JobBench中,LongCat-2.5取得65.4分,相较上一代的44.4分,提高21分。
此外,LongCat-2.5还优化了国产算力上的训练与推理效率。针对所用国产AI加速器单卡显存不足80GB的限制,该团队通过多卡分片分担显存压力,将参数聚合、专家间Token交换等通信安排在超节点内的高带宽互联范围,并让通信与计算重叠执行。在长序列监督微调任务中,综合上述优化后的FSDP配置,单卡吞吐量较DDP基线提升86%。
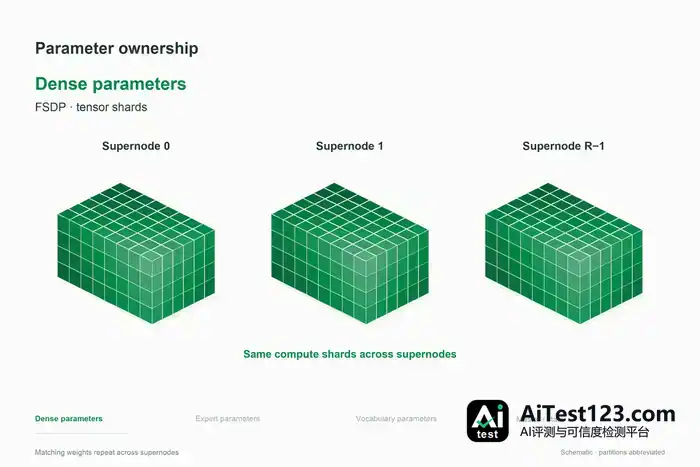
▲LongCat-2.5长上下文训练中的参数与状态分片布局(图源:美团)
推理方面,此次开放的W4A4版本将专家权重和激活值同时量化到4比特。相对W8A8 INT8基线,线上压测中的预填充、解码吞吐量分别提升43.3%和42.77%,为万亿参数模型部署提供效率支持。
 ▲W4A4方案相对W8A8 INT8基线的推理吞吐量变化(图源:美团)
结语:大厂加码编程与办公,价格与部署影响开发者选择
LongCat-2.5在LongCat-2.0的基础上进一步提升,聚焦视觉编程、长程任务执行和专业办公等方面。此次开放权重及量化版本,为希望自行部署、继续训练的开发团队提供了一个新选择。
编程与办公也是本年内其他大厂持续投入的方向。8月12日,阿里开放Qwen3.8旗舰模型权重,重点提升代码开发、专业工作和长程智能体任务能力;11月4日,腾讯发布Hy4,首次引入视觉理解和电脑操作能力,并在WorkBuddy、CodeBuddy等产品上线。
各家模型面向的任务逐渐重合,价格、部署条件和生态适配因而更直接地影响开发者选型。美团此次提供较低单价的API服务、并宣布开放权重,也为开发网站、办公工具及业务智能体的团队提供了一种高性价比的新选项。