

SwarmEvolve:450个agent潜空间协作,1小时任务缩至3-8分钟
作为 harness 工程的下一步,基于大…言模型(LLM)的进化搜索能够通过反复生成、评估和筛选候选数学和计算机程序,对优选方案进行修改与组合,逐轮提升程序表现。 然而,为维持搜索多样性,多个 agent 需要反复探索不同方案,每次都会先生成冗长的文本推理,再输出程序,消耗大量时间,非常慢。那么,能否省去这部分文本生
在 harness 工程继续往前走的过程中,用大语言模型(LLM)做进化搜索是常见做法:不断生成、评估、筛选候选的数学与计算机程序,再对选中的方案动手修改、重新组合,一轮一轮把程序质量抬上去。麻烦在于搜索要保持多样性,多个 agent 就得反复去试不同方案,而每次都得先写出一长段文本推理,再给出程序,时间全耗在这上面。那能不能干脆不生成这部分文本,同时又不丢掉不同思路之间的交流与组合?
布朗大学团队为此拿出了 SwarmEvolve,一个号称超快、低成本的「进化搜索加速」框架。它的做法是把推理搬进潜(latent)空间:每轮跑一个由 450 个 agent 组成的 agent 蜂群(swarm),成员之间靠 KV 缓存交换思路,程序最后由汇总 agent 产出。
在 21 个数学与科学计算问题上,其他 SOTA 框架跑 1 小时才拿到的成绩,SwarmEvolve 达到同样水平所需时间的中位数只有 3-8 分钟;换成 Qwen3 8B 时,它还在 3 个问题上改进了 AlphaEvolve 找到的构造。
论文链接:https://arxiv.org/abs/2611.08483
团队的说法是,让 agent 蜂群在潜空间里通信,为科学问题的程序搜索提供了一条快速、低成本的路子。
研究方法
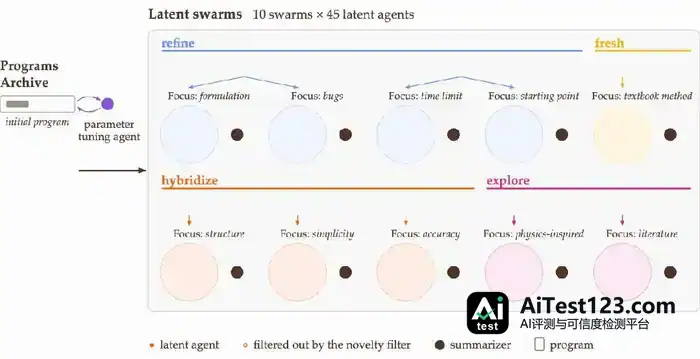
论文对 SwarmEvolve 的定位是利用多 agent 协作做进化搜索的框架。具体来说,潜空间 agent 从不同角度研究问题与父代程序,汇总 agent 则去读它们的 KV 缓存,把各路思路拼成新程序。
这项工作是站在潜空间推理和潜空间通信两项研究之上的。潜空间推理让 LLM 用连续向量思考,不必一步步采样、输出文本 token;潜空间通信则让 agent 交换内部表示,而不是靠文本消息传话。已有的 LatentMAS 不用训练就能把两者接起来,让 agent 把推理形成的 KV 缓存交给汇总 agent 去生成答案。SwarmEvolve 把这个机制搬到了大规模进化搜索里。
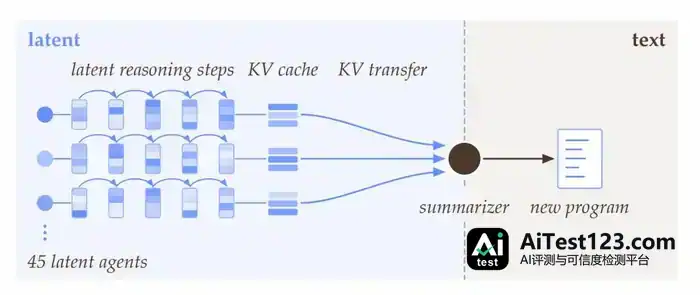
每轮搜索会跑 450 个潜空间 agent,它们分成不同群体,各盯一个方向,比如「实现文献中的某种构造」,或者「采用教科书中的方法」。这些 agent 专长不同、父代程序不同、思考方式也不同,各自做 40 步潜空间推理。
但 agent 一多,系统还是得留住足够不一样的思路。SwarmEvolve 的筛选直接在隐藏状态向量上做:新颖性过滤器按余弦距离,在各群体里留下推理轨迹差异较大的 agent,省掉了先把所有思路转成文本再比对的那一步。
之后,每个群体的汇总 agent 读取被保留成员的 KV 缓存,生成一份新程序。成员从不同父代程序里得到的思路,汇总 agent 能揉到一起,交叉组合就这么在潜空间里完成了。
实验结果
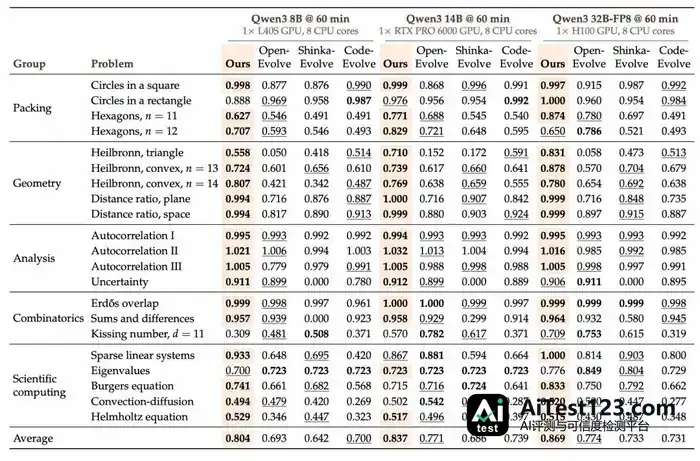
这套设计到底能不能改善搜索,得把程序生成速度和最终得分放在一起看。研究者在数学发现和科学计算领域的 21 个问题上,拿 SwarmEvolve 与 OpenEvolve、ShinkaEvolve、CodeEvolve 做对比,各框架分别用 Qwen3 8B、14B 和 32B-FP8,每次在单张 GPU 上跑 1 小时。
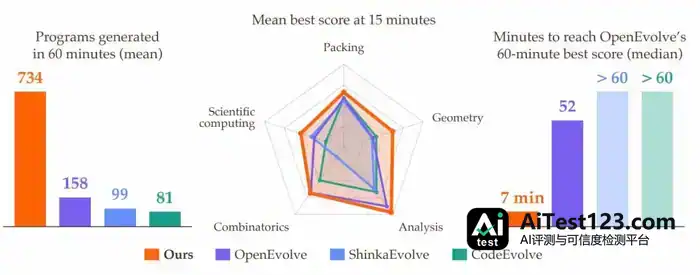
三种模型配置下,平均得分最高的都是 SwarmEvolve。它每小时评估的程序数量是其他 SOTA 框架的 5 至 13 倍;各框架跑 1 小时得到的成绩,它达到同等水平所需时间的中位数在 3 至 8 分钟之间。
另外,它的平均得分也高过了使用 Qwen3 32B-FP8 的 3 个基线框架。
研究团队还单独检验了潜空间推理起到的作用。把潜空间推理换成文本推理后,Qwen3 8B 的得分出现下滑;即便给文本推理分配的 token 预算比潜空间推理更多,结果也一样。他们把这个现象归因于搜索时间的分配:文本越长,每一轮执行越慢,同一时间里能评估的程序数量越少,得分也就跟着走低。
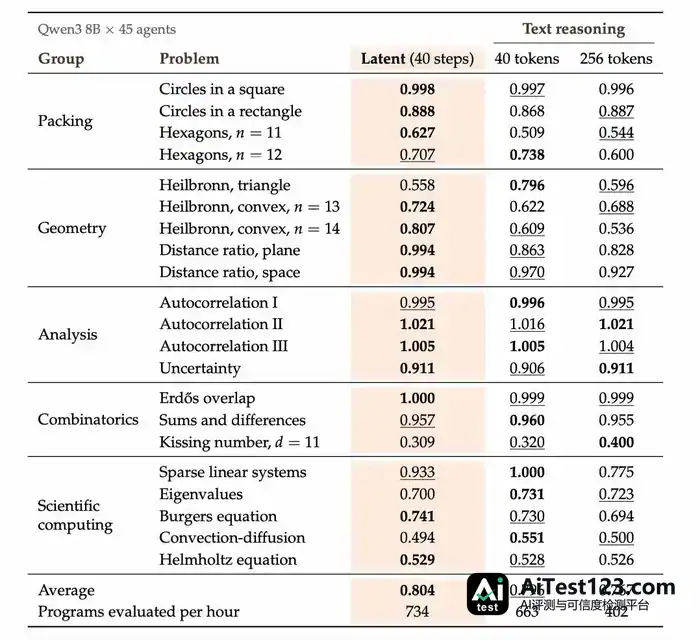
图|潜空间推理与文本推理在 1 小时内取得的最佳得分,对三次运行的结果取平均。agent 数量增加带来的好处,则主要出现在搜索前期——群体越大,能从越多角度去研究父代程序,最初几轮覆盖的设计空间也更广。他们提到,如果单次评估要跑昂贵的科学或工程仿真、只能测少量程序,这种早期优势会格外关键。
但到了搜索后段,不同规模的群体最终得分会拉近。反过来,换成规模更大、能力更强的 LLM,最终得分仍能持续往上走。团队由此认为,搜索新的数学构造、算法和科学计算方法,未必非得靠前沿模型或者庞大的算力预算。只要问题有明确的评估标准,低成本的潜空间 agent 群在单张 GPU 上就能做大规模程序搜索,把更多计算时间花在探索和检验候选方案上。
不足与未来工作
当然,SwarmEvolve 目前还有短板。其一,所有潜空间 agent 和汇总 agent 必须共用同一个 LLM——汇总 agent 只能直接读同一模型产生的 KV 缓存,跨模型协作因此受限。
其二,现有实现离不开标准注意力机制。线性注意力模型、状态空间模型以及混合模型会把历史信息压成固定大小的状态,想在这类模型上做出同样的通信,还得先解决多个 agent 状态怎么合并的问题。
其三,KV 缓存的内存开销会随 agent 数量、潜空间推理步数和模型层数线性上涨,所以他们测试过的最大模型依然要配大显存 GPU。团队提出,几条路子可能缓解这些限制:让模型之间学会转换 KV 缓存、对潜空间消息做压缩,以及把每轮计算分摊到多张 GPU 上。












