

MapFlow开源:大模型换班,Prefill为何能快20%?
在多模型协作的Agent应用中,切换模型往往意味着重复计算上下文。北京大学数据与智能实验室提出的MapFlow技术,通过复用注意力图并配合稀疏压缩与融合内核,实现了跨模型的计算状态共享。实验显示,该技术能在保持生成质量的同时,将Prefill延迟降低15%-20%,显著提升多轮对话场景下的系统吞吐量。
换了模型,之前的计算为何就白费了?
眼下 AI Agent 应用越来越爱用“分工”这套玩法:复杂规划交给能力强的模型,细化和总结则甩给轻量小模型。强弱搭配,效果和成本之间确实能找到一个不错的平衡点。
不过有个性能陷阱常被忽略——模型交接时产生的重复计算。
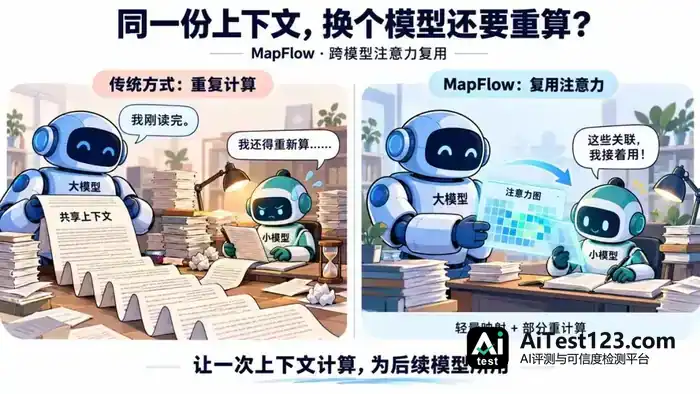
设想这样一幕:大模型刚啃完一份几万字的长文档,背景信息、数据库结构、对话历史都处理完了。随后小模型接手后面的活儿。按说它直接拿大模型已经“读懂”的上下文接着干就行,可现有技术架构下,小模型往往还得把同样的内容从头再算一遍。
这笔开销就出在 Prefill(预填充)阶段。大语言模型在吐出第一个字之前,必须先把输入的所有 token 过一遍,算出对应的键值缓存(KV Cache)。输入越长,这一步越费时,用户等首字出现的时间也越久。
前缀缓存(Prefix Caching)技术已经能解决同一模型内的重复计算——多轮对话里相同的系统提示词和历史消息不必重算。但它跨不过模型之间的鸿沟:KV Cache 与模型参数绑定,两个模型哪怕结构再像,只要层数、注意力头数量或隐藏维度对不上,生成的 KV 状态就没法直接通用。
于是多模型系统在逻辑上分了工,底层计算却各干各的。每切换一次模型,就是一次全新的 Prefill,本想省下的算力,全折在重复读取和处理上下文上了。
不传 KV Cache,改传“注意力关系”
北京大学数据与智能实验室(PKU-DAIR)苗旭鹏助理教授团队提出的 MapFlow,走的是另一条路。
KV Cache 因模型结构差异没法通用,那能不能找一个中间状态,既体现模型对文本的理解,又不那么依赖具体模型参数?
MapFlow 看中的是注意力图(Attention Map)。
所谓注意力图,说的是模型处理某个 token 时,给其他 token 分配了多少“关注”。它本质上是一张记录 token 间依赖关系的地图。这张图有两个关键特性。
其一,它的维度对应 token 的位置,而非模型内部的向量空间。也就是说,只要两个模型用相同的 tokenizer 处理同一段文本,它们的注意力图在位置上就是天然对齐的。
其二,不同模型的内部表示虽然不同,但对文本逻辑结构的捕捉往往相似。好比两个人读同一篇文章,知识背景各异,却都会留意到同样的关键段落和前后呼应。
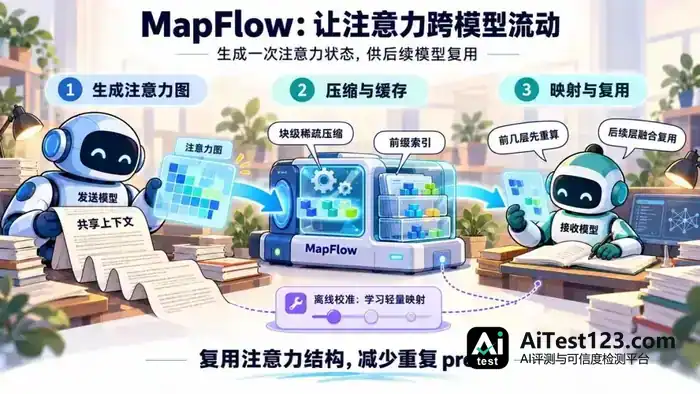
MapFlow 的核心思路是:让接收模型复用发送模型算好的注意力图。接收模型照旧用自己的 Value 表示往下算,但靠着发送模型给的这张“依赖关系地图”,它能跳过部分繁琐的注意力计算,把 Prefill 过程加速。
直接拿来用当然不行。不同模型层深不同,注意力头数量也不一样。MapFlow 为此引入一套轻量级映射机制。
- 层映射:把发送模型某一层的注意力图,对到接收模型合适的层级上。
- 头映射:学习一组线性组合权重,将发送模型的多个注意力头聚合或映射到接收模型的注意力头上。
整个过程不用微调大模型本身。两个模型的原始参数都冻结,只训练极少量的映射权重。论文提到的 Ministral3-8B 到 3B 配置里,新增映射权重还不到接收模型总参数量的 0.001%。这些映射关系离线校准一次就能拿到,之后服务线上源源不断的请求。
存不下、读得慢?三个工程优化手段
理论可行之外,工程上还有拦路虎。注意力图比 KV Cache 通用,数据量却也不小:序列长度为 L 时,完整注意力矩阵是 $L^2$ 级别。若每层、每个头都存稠密矩阵,长上下文带来的存储压力会瞬间爆掉。何况从显存里读取这些大规模数据再做转换,本身也可能把计算省下的时间又吃掉。
为了让 MapFlow 真能落地,研究团队搭了三个相互配合的系统组件。
1. 只存重要的:块稀疏压缩
注意力分布通常并不均匀,模型往往只盯住少数几个关键 token,大部分无关内容直接忽略。MapFlow 顺着这个特点,按累计注意力概率挑出重要区域,把注意力图压成块稀疏格式。
具体做法是把注意力矩阵切成规整的二维块,只留下含高注意力值的那部分。好处有两点:需要存储和传输的数据量因此大幅缩水;块结构规整,GPU 并行处理起来更顺手,稀疏矩阵常见的内存访问不规整问题也一并避开。
压缩还分了阶段。系统先算出块级统计信息,再挑出要保留的块,省掉了“先拼出完整稠密矩阵、再压缩”这笔额外开销。
2. 找得快的:基于前缀哈希的缓存管理
各层、各位置留下的稀疏块数量并不一致。这些缓存碎且散,MapFlow 的应对办法是用带前序上下文信息的前缀哈希索引来管理。接收模型要复用注意力状态时,靠这个哈希索引就能迅速定位到对应的缓存块。
系统还允许把“取回缓存”和前几层的重计算叠在一起跑。换句话说,小模型刚开始算前几层,后台已经在异步加载后面层要用的注意力块,数据搬运的延迟又被盖住了一部分。
3. 算得省的:融合内核执行
按老流程走,得先把接收模型的完整注意力矩阵还原出来,再和 Value 矩阵相乘,中间冒出一堆临时张量,显存读写频繁。
MapFlow 写了个融合内核(Fused Kernel)。它直接读稀疏注意力块,在 GPU 片上内存里做完注意力头之间的线性组合映射,紧接着和接收模型的 Value 相乘、累加,结果直接输出。
“读取-映射-计算”串成一条线,中间数据的显存占用和带宽消耗都降了不少。这套系统目前已集成进主流推理框架 vLLM,融合检索内核用 Triton 编写,PagedAttention、Chunked Prefill 和变长序列打包这些现代推理优化特性都原生支持。
实测效果:延迟降低,吞吐提升
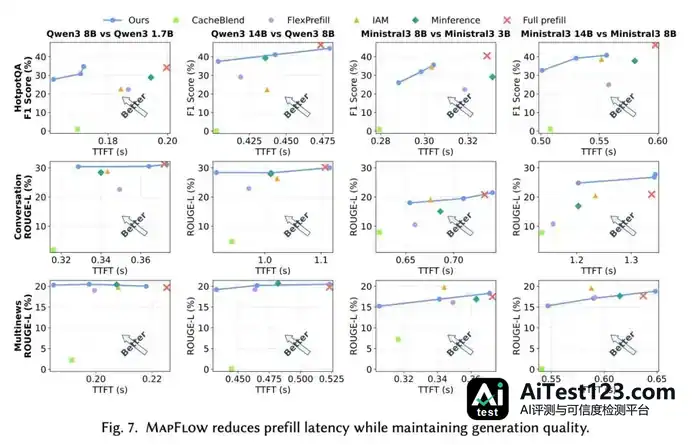
评测在 NVIDIA A800 80GB GPU 环境下进行,对象是 Qwen3 和 Ministral3 两个模型家族。四组不同规模的模型配对都测了,任务涵盖问答、对话和摘要等。
Prefill 延迟显著下降
和完整 Prefill 计算相比,MapFlow 把延迟压低了 15%–20%,生成质量没有因此打折。再跟另一种加速技术 FlexPrefill 比,在生成质量持平或更好的前提下,它还能把 Prefill 延迟再降 7%–12%。
在线吞吐量最高提升 25%
多轮对话路由场景里,团队拿 LMSYS 和 ShareGPT4 的真实对话数据搭了模拟负载。在 P90 首 token 延迟约束相同的情况下,启用 MapFlow 的系统请求吞吐量最高涨了 25%。同样的响应时间要求下,服务器能同时接待更多用户。
多模型工作流端到端加速
典型 Agent 工作流由 14B、8B 和 3B 三个模型串联而成(14B 规划,8B 细化,3B 总结),下游两个小模型共用上游 14B 模型产出的注意力状态。实验显示,每轮工作流省下 0.48–0.73 秒,端到端整体加速比达到 5.4%。百分比看着不算高,可放在复杂的长链路 Agent 应用里,每一秒都是用户体验的实打实改善。
结语
MapFlow 的价值,是给多模型协作添了一层新的计算复用维度。
以往信息只在文本层面传递;如今模型对文本的“理解结构”也能传了。注意力图跨模型复用,再加上稀疏压缩、融合执行这些系统层面的优化,MapFlow 说明不同规模的模型不必各算各的。
论文《Accelerating Cross-Model LLM Inference via Attention Map Reuse》已被数据库顶级会议 SIGMOD 2027 录用,代码在 GitHub 上开源。Agent 应用越做越复杂,这种“一次计算,多次复用”的路子,说不定会变成提升推理效率的常规配置。

















