MIT CSAIL:仅改0.016%权重,数学成绩真能飙升?

资讯 AI 应用前沿 全文 3782 字 · 约 10 分钟读完 配图 4 张 分类大模型

MIT提出Weight-Space Programming,声称微调极少权重即可大幅提升模型能力。无涯智远创始人张牧涵博士通过独立实验复现并对比超网络技术,发现该方法在修复循环有效,但在知识、风格、技能内化上存在局限。文章深入解析了“读模型、改权重”的技术边界,探讨了通用大模型编排与专用超网络写入结合的进化路径。

所属频道 模型发布

只动0.016%的权重,模型就能变聪明?这个说法得打个问号。

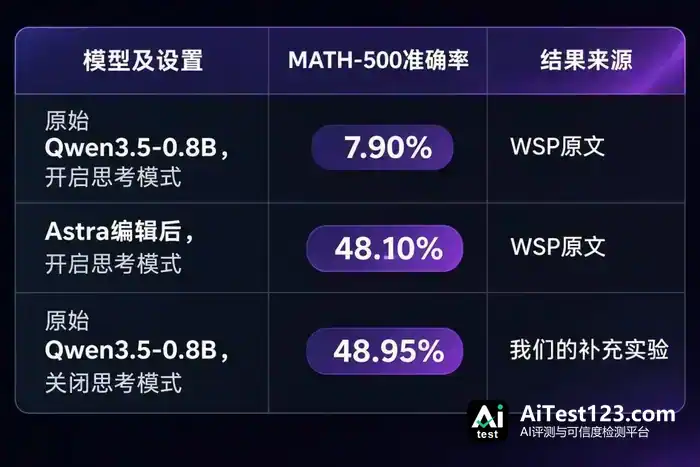
MIT CSAIL 最近发了一篇博客《Sparks of Weight-Space Programming》,在圈内引发不少讨论。最吸引眼球的一组数据是:GPT-6 Astra 没走传统的梯度下降训练路线,只改了 Qwen3.5-0.8B 大约 0.016% 的权重,就把这个模型在 MATH-500 基准上的得分从 7.9% 提到 48.1%。
图片

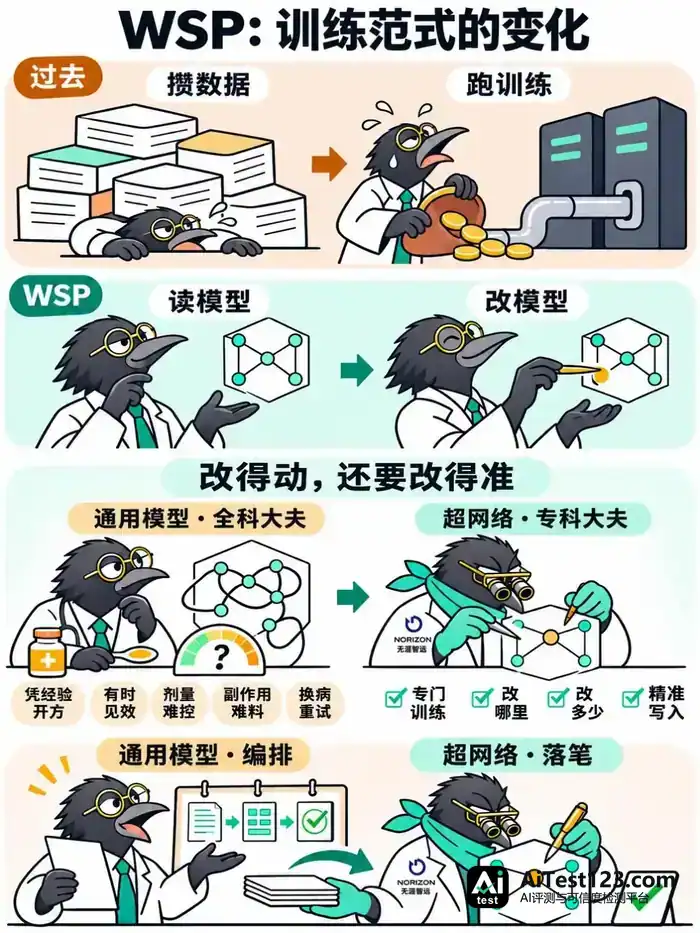
这套做法叫 Weight-Space Programming(WSP,权重空间编程)。思路听起来很诱人:用一个足够强的通用大模型去“阅读”另一个模型,摸清它的内部状态,然后直接上手改它的权重参数。
图片

我长期研究超网络和模型持续学习,看到这个方向,一方面兴奋,一方面也警惕。兴奋的是,它和我们无涯智远(Norizon AI)在探索的路子撞上了——让大模型出厂之后还能像人一样边用边学;警惕的是,这种“现场手术”式的改动,到底是真学会了,还是只是把病灶暂时盖住?
图片

为了把这个问题弄清楚,我们团队依据公开信息补做了一组实验。结果有点出乎意料,也提醒我们:几种不同层面的“模型进化”,得拆开来看。
图片

48.1% 这个数字,藏着一个基线陷阱

先看原博客里一个容易被跳过的细节。Qwen3.5-0.8B 有个已知毛病:一开“思考模式”,就容易陷进重复循环,车轱辘话一遍接一遍,直到 Token 上限耗尽。Astra 的干预,很大程度上是把这种循环修好了,让模型有机会把话说完,分数也就跟着上去了。

作者自己说得很实在:修循环和涨数学能力是两码事。换到很少出现循环的 Gemma 3 270M 上,MATH-500 的成绩只从 6.8% 微涨到 7.0%~7.7%,并没有什么奇迹。

于是我们补了一个特别朴素、却关键的对照实验:权重一点都不改,只把 Qwen3.5-0.8B 的思考模式关掉,会怎样?

同样的 MATH-500 测试集,同样的采样和评分设置,未经任何编辑的 Qwen3.5-0.8B 在关闭思考模式后,准确率到了 48.95%。

这个对照一出来,问题的性质就变了。对一个因为绕圈把 Token 耗光的模型来说,权重编辑确实带来了明显改善;可要是跟“关掉思考”这种几乎零成本的办法比,WSP 并没有多出额外收益。

我倒不觉得这能抹杀 WSP 的价值。反过来看,能定位并干预一种内部行为机制,本身就是 Astra 推理能力的一次展示。它先发现失败大多来自重复思考,再对比正常推进和陷入循环两种上下文,从内部表示里提取出“重复方向”,接着找出哪些神经元在往这个方向写信号,对两层 MLP 做定向修改。整条因果链条完整,也漂亮。

更该记下来的是范式层面的变化:权重不再只是一堆只能靠梯度下降慢慢挪的数字,另一个模型可以像读文本一样把它读出来、理解透,再直接改写。以前想让模型变强,路只有一条:攒数据、跑训练;现在多出第二条:让模型去读另一个模型,然后写它。

但真正的问题是,这条链条能伸多远?碰到更复杂、分布更广的知识和能力,Astra 还能不能找到对应机制,并且事先判断一次修改的收益和副作用?

改参数,能让模型真正“学会”新东西吗?

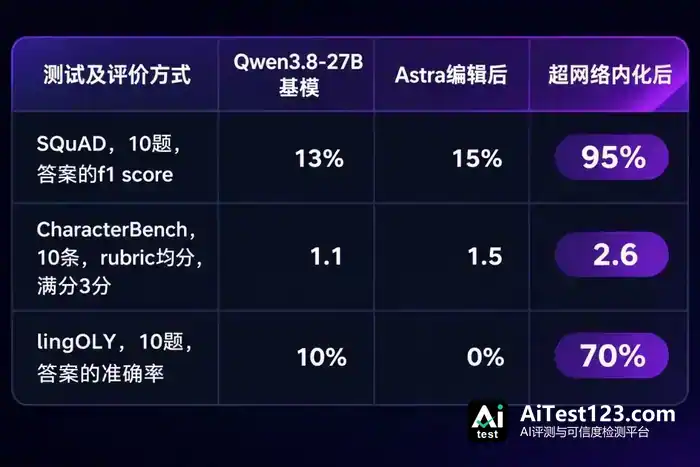
为了验证 WSP 在知识内化、行为适配和技能习得上的真实水平,我们拿 Qwen3.8-27B 当共同起点,比了三种状态:没更新过的原始模型、经 Astra 编辑权重后的模型,以及经过我们超网络内化新知识的模型。

受 Astra 调用额度和执行速度限制,测试规模不大:从 SQuAD(知识问答)、CharacterBench(角色扮演的风格适配)和 lingOLY(陌生语言技能学习)里各抽 10 条样本。关键是回答时把参考材料全撤掉,看模型能不能只靠更新后的参数作答。

知识:信号放大了,概念没换掉

SQuAD 测试里,超网络更新后的模型在没有原始材料的情况下能准确回答问题,另外两组都没做到。

材料里有个样本挺典型:Cestida(带状栉水母)已知仅两个物种,游动时靠身体起伏和栉板列拍打;它跟拼写相近的 Cestoda(绦虫)被未经编辑的模型直接弄混了。

Astra 的诊断很明确:它对比材料文本和绦虫描述在 MLP 层的激活差异,挑出对材料更敏感的那些神经元,把它们的输出分别放大 1.5 倍和 2 倍。权重确实动了,措辞也确实变了,可概念没变——两种强度下,模型还是咬定 Cestid 是不会游泳的绦虫,还是说有四五千个物种。

把一个和材料相关的信号放大,建立不了“Cestida 指带状栉水母”这条新关联。从相关性走到因果,正是知识编辑最难迈的那道坎。

风格:写进了参数,没写进人格

CharacterBench 测试中,超网络更新后,模型的输出明显带出了角色和风格的要求,Astra 这一组则没有。

材料让模型扮演 Evolto——一个傲慢、贪婪、爱用反问显摆优越感的反派。Astra 的招数是:分别算出“给了角色材料”和“没给材料”时某一层的激活差,把它当成一次修改塞进单层权重。写入本身没出岔子,权重张量确实被改了,算术这类中性能力也没受牵连。

问题是模型一张嘴就露馅。自我介绍照旧是“通义千问”;被人质疑本领一般,回应依旧谦和;让它把最珍贵的东西免费分给大家,也答应得挺痛快。同一个向量只写进一层,换到新问题、换到别的生成位置,就唤不起同一个人格了。同一份材料交给超网络内化之后,回答里才冒出傲慢、反问和角色特有的那些措辞。

技能:规则用得出来,才叫学会

lingOLY 考的是技能:给模型一份陌生语言的简短学习材料,让它掌握里面的语法和词汇规则,再做翻译和推理。10 道题,未更新的模型答对 1 题,Astra 编辑后仍是 1 题,超网络内化后答对 7 题。

Astra 这一回还是老路子:在第 43 层 MLP 上写一次修改。结果连它自己出的检验题都没扳过来——材料要求把“some change”译成 grąžos,编辑前后模型都输出 pinigų。只试了这一个候选,Astra 就收手了,权重维持原样。

所谓学会一条规则,是指在没见过的题目、不同的句式、每一个生成位置上都能用对。一次局部的激活偏移,或许能把出题点附近的输出往材料上拉一拉,覆盖范围却没法保证。

三个案例,同一个坎

知识、风格、技能,三类任务栽的地方是同一个:Astra 改权重时用的,其实是一套经典的知识编辑工具——比激活、提方向、缩放神经元、打个秩一补丁。

对付单点故障,这套工具挺顺手,比如压住重复循环。可要把一份新材料变成能稳定调用的知识、人格或规则,精度和更新参数量就都差得远。

跟材料相关的激活,它找得到;让最终行为按材料改变的因果方向,它找不到。权重它能动,改完之后模型会说什么,它控制不精确。工具本身不够强,这是这些失败最直接的原因。

这组实验至少说明一件事:大模型的知识内化、行为适配、技能习得,眼下都还不在 Astra 现场编辑权重的能力范围里。

打个比方,让通用大模型现场给模型“看病”,像请一位什么病都看的全科大夫凭经验开方。有时确实药到病除,比如抑制重复循环;可剂量谈不上精确,副作用也难预判,换一种病症又得从头试。

要把新知识、新风格、新规则稳稳写进参数,得靠针对这件事专门训练过的手段——知道改哪里、改多少,也知道改完模型会怎么说。这更像精准医疗。超网络想扮的,正是专科大夫这个角色。

让 Agent 管编排,让超网络管落笔

两者可以放进同一个工作流里互补:通用大模型当编排者,超网络当它手里那件负责写入的工具。

具体讲,拿到一份新材料,Agent 能判断哪些内容值得内化、文本怎么组织和切分、按什么顺序交给超网络。写完之后再跑一轮评测,看新信息调不调用得出来、原有能力有没有受损,然后据此调整材料组织或写入策略,再来一次。内化文本的组织、调优和性能评测,都能交给它编排——这本来就是通用大模型擅长的。

超网络只管其中最吃精度的那一步:把文本精确对应到参数空间。我们的超网络是端到端训练出来的,在大量样本上学过“什么样的文本对应什么样的参数改动”。Astra 靠的是一次前向的激活差,临时凑一个方向出来。前面三个案例里,缩放神经元、秩一补丁改不准,缺的正是这样一件经过训练的写入工具。

两者一结合,WSP 展示的现场推理能力一点不浪费。Agent 越会编排,精确的写入工具就越有用武之地——这也是我们盼着 WSP 继续往前走的原因。

回到开头那个数字:0.016% 的权重换来 48.1%。WSP 把“读模型、做诊断、改权重”串成了一条完整链路,这一步很了不起。

但改得动权重,不等于学会了新能力。这几组实验里,参数确实变了,材料里的知识、角色和规则却没能变成可以稳定调用的东西。要让它们真正留下来,需要一个经过端到端训练、能把文本精确对应到参数空间的写入工具。

所以我更愿意把 WSP 看成一块重要的拼图:通用大模型负责编排模型的更新,超网络让每一次更新在参数空间里落得准。两者接起来,模型出厂之后边用边学,才算有一条能反复走的路。

权重能被改动的那一刻,只是起点。

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关 AI 工具

AI 导航
腾讯混元大模型 腾讯混元大模型由腾讯全链路自研,在文本和多模态模型性能方面表现卓越,处于业界领先水平。其混元 API 整合了… 大模型与开发平台 · tencent.com 快手可图大模型Kolors 可图大模型(Kolors)是快手大模型团队自研打造的文生图AI大模型,能够根据用户的文字输入生成风格多样、画… AI 绘画生图 · kuaishou.com 盘古大模型 华为盘古ai大模型官网入口,1100亿密集参数,40TB海量数据精细训练而成 简介 盘古NLP大模型是一项基… 大模型与开发平台 · huaweicloud.com BlueLM蓝心大模型 蓝心大模型官网,vivolm,vivo自研的通用大模型 简介 蓝心大模型(BlueLM ),强大的语言理解能… 聊天对话 · vivo.com 云知声山海大模型 云知声山海大模型是一个多功能、跨领域的智能大模型,它通过集成丰富的知识库和先进的自然语言处理技术,为用户提供… 大模型与开发平台 · unisound.com 子曰” 大模型 子曰是网易有道推出的教育领域垂直大模型,包含基于子曰大模型研发的六大创新应用——“LLM翻译”、“虚拟人口语… 聊天对话 · youdao.com 曹植大模型 曹植大语言模型是国内首个垂直行业专用的自主可控的国产GPT大语言模型,由达观数据研发。这个模型可以准确完成多… 聊天对话 · datagrand.com 西湖大模型 西湖大模型官网,智商情商俱佳的多模态大模型 简介 西湖大模型是西湖心辰开发的多模态大模型,西湖大模型既具备通… 聊天对话 · xinchenai.com

相关推荐 按相关度与热度排序

全部资讯 →
  1. 中国移动云与智谱签约:共建Token联合发展中心,GLM接入MoMA平台

    IT之家 11 月 8 日消息,11 月 6 日,中国移动云公司与北京智谱华章科技股份有限公司正式签署合作协议,在 Token 技术创新、模型服务、产品打造、行业方案等领域深化战略合作。 移动云总经理孙少陵,智谱华章 CEO 张鹏现场见证签约。 据介绍,双方将聚焦国产化算力适配与模型调优,共建 Token 联合发展中心

    来源 AI 行业观察
  2. MiniMax闫俊杰谈中美大模型:性能达95%,坚持开源至AGI

    在当前全球人工智能发展的关键节点,MiniMax 创始人闫俊杰近日在与投资机构 Scottish Mortgage 投资经理劳伦斯·伯恩斯的对谈中,深入剖析了中美大模型的发展现状、技术路径以及公司未来的战略规划。 中美大模型发展现状:性能差距与后发赶超的挑战 在谈及中美大模型的差距时,闫俊杰指出,目前中国头部大模型已经

    来源 AI 开发者社区
  3. GPT-6.2 Astra将至:具身智能公司传裁算法岗,自研模型还值得做吗

    GPT-6 Astra发布才两个月,GPT-6.2 Astra眼瞅着就要来了。 然而具身智能行业还没从上一轮打击中缓过神来。 一切都是那么猝不及防。 还记得GPT-6 Astra刚出来时,一批具身从业者被打懵了。特别是在一线搞预训练的工程师,更是人人自危。 近期,业内又传出消息,一些具身智能公司开始裁撤算法岗。 过去需

    来源 AI 行业观察
  4. MiniMax闫俊杰谈追赶AGI:最后5%差距更难,坚持开源到AGI实现

    “最后这5%的差距,可能比完成前面95%要难得多。”在最近发布的一期英国播客《Invest in Progress》中,MiniMax创始人闫俊杰谈到了中国大模型追赶美国同行的难度。与他对谈的是Scottish Mortgage投资经理劳伦斯·伯恩斯(Lawrence Burns)。2025年12月,伯恩斯到中国拜访闫

    来源 腾讯网
  5. 中国开源模型拿走美国企业89%支出,Kimi一家占61%

    门罗风投报告显示,美国企业89%的开源大模型支出流向中国公司。尽管开源价格下降,但用量激增推动其成为主流。DeepSeek和Kimi在调用量与支出上占据主导,反映美国企业对中国开源AI的高度依赖及投入增长。

    来源 36氪
  6. 吉利联合中国气象局推交通气象大模型,超视距预警将上车领克900L

    IT之家 11 月 7 日消息,11 月 5 日,吉利汽车集团与中国气象局地球系统数值预报中心正式签署战略合作框架协议。 双方联合推出行业首个“智象-星睿交通气象大模型”,该模型聚焦结冰、团雾等极端气象场景,可实现车道级气象环境实时监测与提示,为进一步提升复杂天气条件下的行车安全与自动驾驶系统可靠运行提供支撑。 其中针

    来源 AI 行业观察
  7. MiniMax闫俊杰谈中美AI差异:美国砸钱堆算力,中国靠工程效率追赶

    (文/汤普济 编辑/吕栋)全球科技巨头仍在不断加码AI算力投资,中国大模型企业则在探索另一种竞争方式。当先进芯片和计算资源相对受限时,能否通过技术创新和工程优化,让每单位算力创造更多智能,并以更低成本提供模型服务?近日,MiniMax创始人、董事长兼CEO闫俊杰在接受英国投资信托Scottish Mortgage旗下播

    来源 腾讯网
  8. Anthropic收购Mithril Medicine,AI制药并购四类路径浮现

    10月27日,Anthropic公开披露收购Mithril Medicine,这笔交易打破了大模型厂商此前只收购计算生物学工具公司的惯例。 这家被称作“一人药企”的Biotech,仅凭创始人借助Claude调度外部CRO与实验资源,就走完从靶点发现到小鼠药效验证的全链路。两条罕见肌营养不良管线随之归入Anthropic

    来源 AI 行业观察
  9. Anthropic启动IPO路演:估值从两万亿缩至1.5万亿,11月26日前挂牌

    Anthropic将于11月9日当周启动IPO路演,目标赶在感恩节(11月26日)前完成上市。最初部分投资人押注两万亿美元估值,如今机构普遍讨论的区间已压缩至1.5万亿至1.6万亿美元,买方最激进报价低至1.1万亿。与此同时,OpenAI私募轮估值从1.4万亿美元下调至1.25万亿。这场双重估值收窄,是公开市场对AI行

    来源 AI 科技快讯
  10. GPT-6 Astra改写权重救活小模型,普通人也能在家训AI

    这两天,MIT的一篇「权重空间编程」博客在AI圈刷屏了。 实验里,GPT-6 Astra自己写Python脚本排查诊断,只改了一个0.8B小模型里0.016%的权重,就治好了它的复读死循环,让数学成绩原地暴涨6倍。 顶尖大模型已经不满足于自己答题,而是开始下场写脚本、调参数、甚至亲手训练另一个AI了。 何止能,靠着Na

    来源 AI 行业观察
  11. GPT-6 Astra改权重引热议:对照实验显示模型并未真正变聪明

    张牧涵博士,无涯智远(Norizon AI)创始人兼首席科学家,主要研究方向为持续学习、自进化智能体、图机器学习、大模型架构和推理等。曾任 Facebook AI(现 Meta AI)研究科学家,负责面向十亿用户规模的大规模图机器学习系统研发。现任北京大学人工智能研究院助理教授、研究员、博士生导师,首届国家级青年人才项

    来源 腾讯网
  12. 3Chat ai完成千万元Pre-A轮融资:客户对话如何推向成交?

    上海纽酷三言科技有限公司旗下 3Chat ai 已于 2026 年 11 月 完成千万元人民币 Pre-A 轮融资,本轮融资由奇绩创坛与战略投资者联合投资,蓝狮资本担任财务顾问。资金将用于客户运营大模型训练规模化获客和核心岗位团队扩充。 面向长周期客户经营的 Agent Runtime,把客户对话变成可推进、可成交的结

    来源 AI 行业观察
  13. 姚顺雨谈大模型壁垒:产品层比模型层更难被复制

    11月9日,据第一财经报道,腾讯首席AI科学家姚顺雨在2026未来科学大奖的一场对话中表示,大模型真正的竞争壁垒更多存在于产品层,而非模型层。他认为单纯依靠模型性能领先很难形成持久优势,能掌握专有数据、理解用户场景并获得用户信任的AI产品更难被替代。

    来源 凤凰科技
  14. TechInsights展望2027:存储成最大瓶颈,五大趋势重塑半导体

    2026年即将过去,半导体行业在这一年迎来新一轮增长周期。据全球半导体贸易统计组织(WSTS)预计,2026年半导体全年营收有望达到1.65万亿美元,同比暴涨108%。其中,存储芯片将是主要驱动力,将同比暴涨超3倍。回望这一年,AI算力基础设施建设持续提速,HBM供给失衡, DRAM、NAND价格也持续回暖;下游服务器

    来源 腾讯网
  15. 英伟达牵手韩国AI初创圈:先投Point2,还有三家在谈

    英伟达11月9日发布声明称,公司高管与韩国科学技术信息通信部副部长共同会见超20家韩国初创企业,涵盖基础模型、物理AI、AI基础设施以及AI半导体等领域。英伟达宣布投资韩国AI互连技术创企Point2,并计划进一步投资AI实验室Motif Technologies、物理AI创企RLWRLD和企业级AI公司Upstage

    来源 腾讯网
  16. 百图生科联手11家伙伴:AI生物计算落地乳癌、中医药与育种

    活动焦点: · 百图生科主办、港投公司支持的第三届峰会2026年11月6日开幕,汇聚约300名科研、产业及投资界代表,探讨人工智能与生命科学的融合发展 · 百图生科InnoHub分别与大学、科企及投资机构合作,以AI生物计算聚焦乳癌及中医药研究、农业育种、研发与产业配套,包括与香港大学推进「乳腺癌虚拟细胞大模型」项目,

    来源 AI 行业观察
  17. 马斯克携手黄仁勋:StarMind太空算力2027年Q3入轨

    在纽约举行的第33届巴伦投资者大会上,马斯克公布了一份时间表:SpaceX与黄仁勋的NVIDIA联合设计的首批StarMind太空计算设备,计划于2027年第三季度发射入轨,并在2028至2029年进入大规模部署阶段。

    来源 TechWeb
  18. 具身智能数据缺口达两个数量级:百万小时存量难撑亿小时需求

    财联社11月8日讯(记者 付静)近日,国家数据局组织召开行业高质量数据集建设链主工作座谈会,强调行业高质量数据集建设要坚持“以需定供、以用促建、以评提质”原则。其中,摸清人工智能用数需求是重点工作之一。国家数据专家咨询委员会委员张向宏在本周的2026年世界互联网大会乌镇峰会上表示,通用大模型、行业大模型、智...

    来源 腾讯网
  19. ChatGPT封号波及200美元Pro用户,OpenAI未公布受影响人数

    最近,ChatGPT用户圈突然出现一波账号停用风波,连每月花费200美元订阅Pro服务的用户也未能幸免。更让人意外的是,部分用户表示,账号在没有收到任何提前通知的情况下就突然无法登录,页面直接显示

    来源 TechWeb
向下滚动自动加载更多