美团LongCat-2.5开源:1.6万亿参数,长序列SFT单卡吞吐超DDP 86%
美团开源LongCat-2.5,长序列SFT单卡吞吐较DDP提升86%
11月10日,美团把LongCat-2.5开源出来,协议选的是MIT,商用推理部署和二次训练都放开了,不需要再单独申请授权。这个模型瞄准长程智能体任务,走原生多模态路线:总参数1.6万亿,每个token激活约480亿参数,上下文长度支持一百万。在复杂代码库开发、完整项目构建、Visual Coding和专业办公这几类场景里,端到端交付能力比之前有明显提升。权重已经挂上HuggingFace,技术博客和API平台也一并开放。
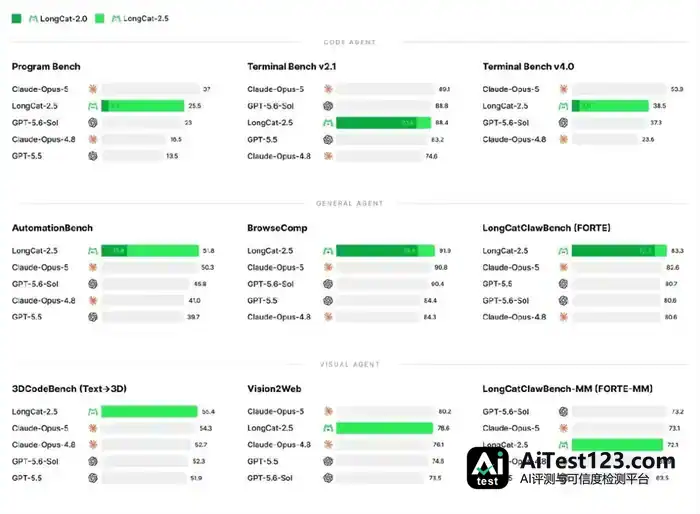
能力往上走,靠的是整条训练链路一起扩。视觉表征层把视觉信号拆成多层级的离散token,和文本一样交给主干统一处理,没有另挂一个视觉模块;对原生分辨率特征做残差向量量化,一级一级补细节,视觉码本与主干联合训练,视觉token还能离线缓存。专业办公这一侧,材料处理和专业判断被重点加强,报告、演示文稿以及办公工具都能端到端交付。

推理用的是W4A4方案,专家权重和激活都量化到4bit,由原生INT4矩阵乘法单元来算,MoE量化精度用FlatQuant优化,下游表现和量化前相当,再配上专用融合算子压成本。训练和监督微调都走长序列,针对国产AI加速器单卡显存不足80GB的情况,用FSDP双重分片和混合词表并行把显存压力拆开。这套配置在长序列SFT中单卡吞吐量比DDP基线高86%,为万亿参数MoE的开源部署打下效率底子。
美团方面称,选MIT协议是想让模型能被自由使用、修改和再分发,后面还会继续开放模型和工程经验。显存和带宽都受限,还要装下万亿参数MoE,这条路延续的是大模型竞争的一个转向:从拼参数规模,转到工程落地和国产算力适配。
本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。