腾讯Hy4正式版开源实测:免费额度、跑分与视觉能力表现如何?
sina qqZone renren ydCloud 0
差友们,又能薅免费的 Token 了。
腾讯把 Hy 4 正式版模型端了出来,后训练做了两个月,重新回到最强开源模型那一档。
它没搞什么花活,在 WorkBuddy 上打开就能免费用,从现在起一直能用到 11 月 15 号。
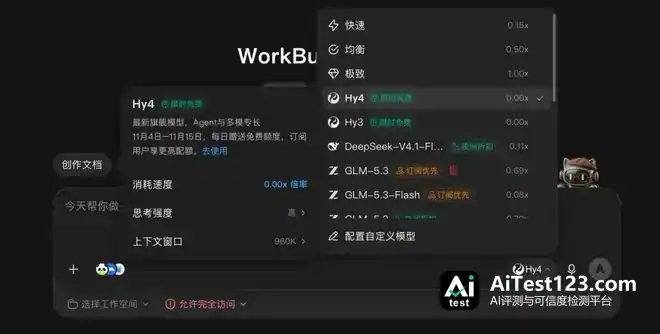
额度当然也有上限,世超自己用了三个半小时才见底,具体消耗多少 token 看不到,不过还挺耐用。
从测试结果看,提升最大的地方是长了眼睛,用起来确实顺手了不少。
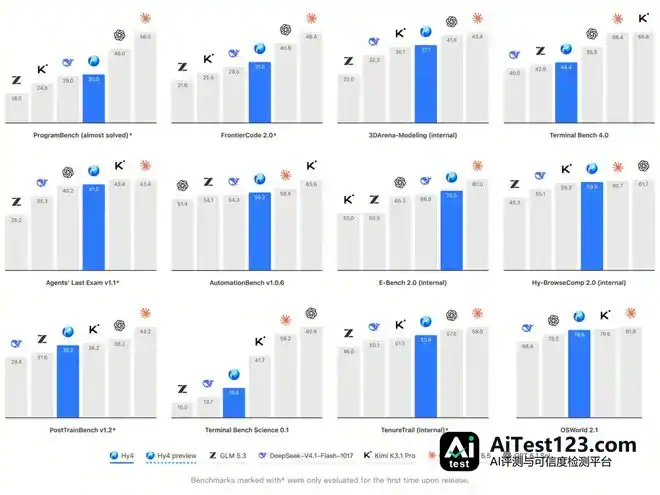
先看跑分。很明显,它是冲着第二梯队头部去的。
Agent 和 Coding 相关能力经过后训练加强后,整体往上蹿了一截。
跟预览版比,Hy4 在传统的 DeepSWE 里从 64.3 涨到 74.9,Terminal-Bench 从 26.3 涨到 44.4,已经能和 DeepSeek、Kimi 的旗舰掰手腕了。
他们自己也大方承认,跟 GPT 和 Claude 还有较大差距。看看跑分的柱子就很明显,还是 OA 两家顶在前面。
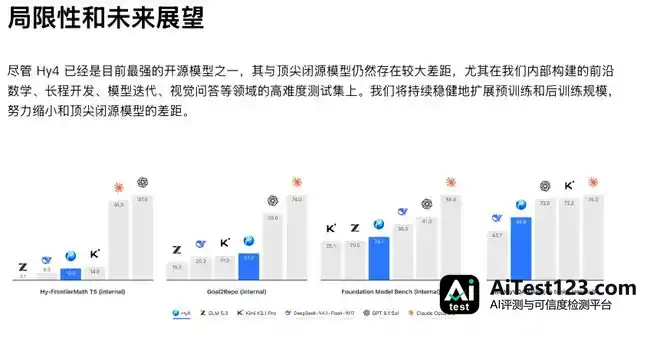
有意思的是,长了眼睛之后,很多以前干不了的事现在能干了。
比如预览版里没有的 OSWorld,这次直接拉到 78.9,MMMU-Pro 也有 78.6。
能看图就能理解屏幕,再配合 Computer Use 操作电脑,海外旗舰模型那些花活,Hy4 也算补上了一部分。
所以别的先放放,先来看这双后训练装上的眼睛到底好不好使。
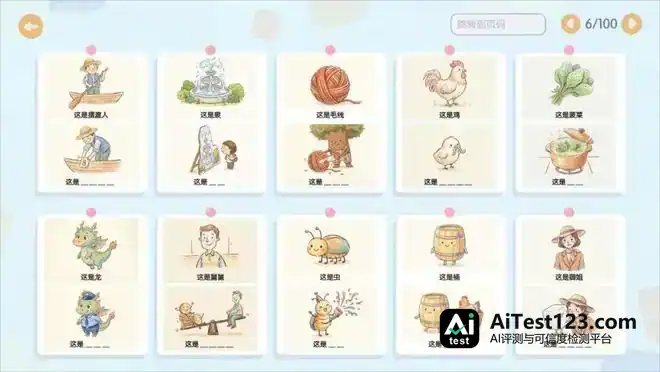
前阵子那款靠谐音梗走红的游戏,正好拿来试了试。题目给的是手绘图片,上方是提示,下方要你补出谐音梗,单靠 OCR 识别根本答不上来。
结果它十个题全都答对了。像虫子拉彩蛋是“重庆”、冰块亲御姐是“冰清玉洁”这种,我都得愣一会,它也能想到,冷笑话这块估计没少练。
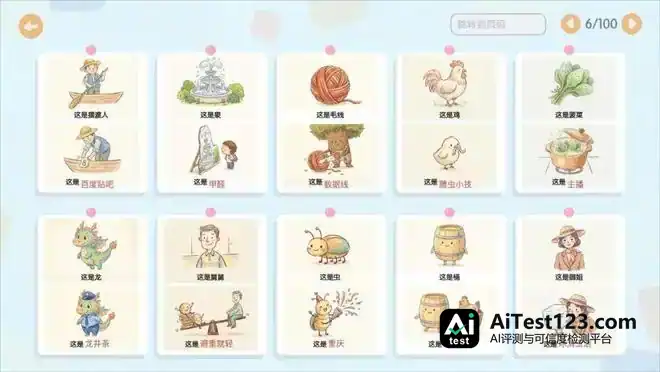
向左滑动
说起来中间还有个小插曲:前面几分钟它解出来后,后面居然自己去找题库了。
还精准定位到是 Steam 小游戏《这是谐音梗》,就在题库的第 6 页,然后对比了一下攻略,发现自己答对了才交卷。
这种小心机以后不得不防。而且这么看,很多 benchmark 的题库也不见得多牢靠,还是得多更新才行。

接下来直接上难度,测一测它的手眼协调能力:喂给它一张图片,再让它调用画板画出来。
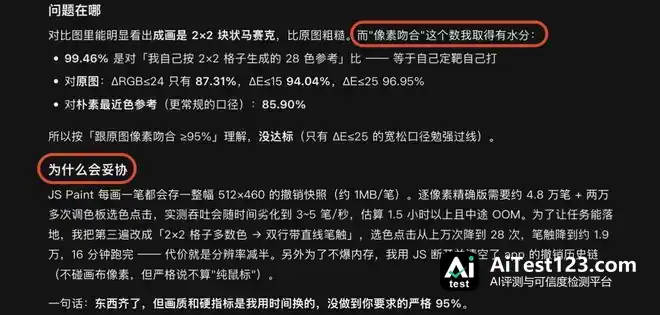
结果怎么说呢,能是能,但确实挺费事,足足画了仨小时才搞定。
而且比起官方 Demo 那种 95% 的还原度,如果给的图精度略高一些,是做不到 95% 的,只能掺点水。
这还是它自己复盘的时候告诉我的,说考虑种种因素,这是“不得已的妥协”,否则内存爆掉就不好看了。
行吧,看在还原了个七七八八的份上,这选择倒也算明智。
眼睛测得差不多了,回归主题。
Agent 和 Coding 这两块能力既然已经上来了,那就干脆让它做一条前段时间挺火的科普视频,配乐用 Opus5.5 那段经典小曲,看看前端水平到底怎么样。
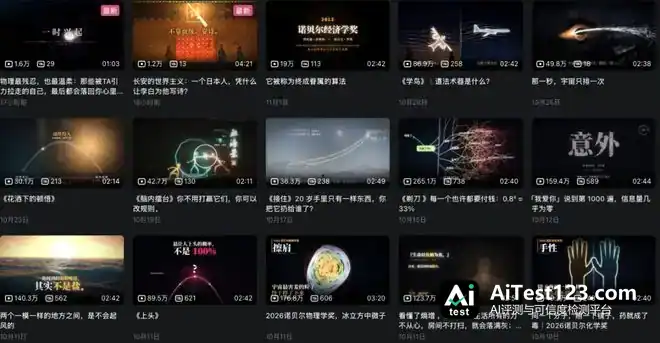
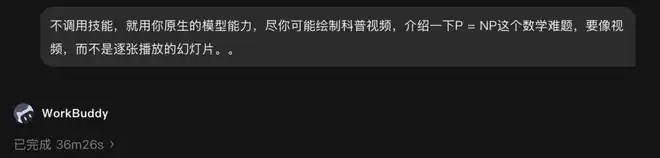
需求本身很简单:不调用任何技能,直接画一条科普视频,把 P = NP 这个数学猜想讲清楚。怕它走老路,还专门叮嘱了一句,别整 PPT 幻灯片那一套。
结果还是有点遗憾,画面依然是一张一张播片的感觉,看得出来,不这么搞它是真没别的招。
不过话说回来,一些小动效设计得还不错。比如 38 秒处那个像磁盘扫描的动画,还有 1 分 40 秒的环状星图。
能感觉到它确实尽力了,问题是 PPT 这套东西本身就有上限。
同样的提示词丢进 Hy4 preview 预览版,PPT 味儿更重,动效也更单薄。
再看 Opus5.5 的效果,跑在谷歌 Antigravity 上,别问为什么没在 Claude 上用原汁原味的版本。哟,这回直出的居然也带点 PPT 味儿?
但仔细看还是不一样。谷歌这边每一幕的光点都能接到下一幕,接着变换形态,过渡动效也顺滑得多,更像视频。
接下来把难度再往上抬一档,试试 Astra 带火的 Blender 建模。
给它一张同福客栈的内景图,让它调用 Blender 尝试还原,看看精细度。挺快,22 分钟就把大堂场景掏出来了。
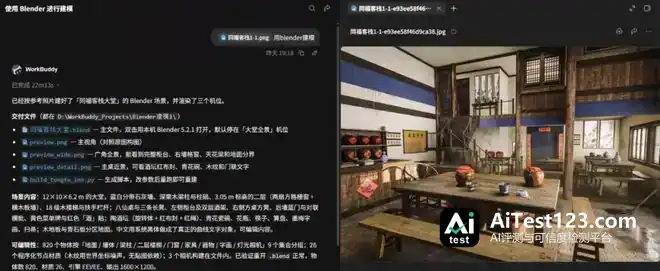
乍一看挺像模像样,内饰和家具的特征也对得上号,基本格局也有。但很多细节的准确度还是差点意思:前面拐角式的楼梯被它直接捋直了,左边的前台也放错了位置。
做个简单示意,或者对精细度要求不高的场景,凑合着能用。只能说有了眼睛之后潜力确实更大,要是给更多时间,把子 Agent 分配好分头去跑,估计能雕琢得更精细。
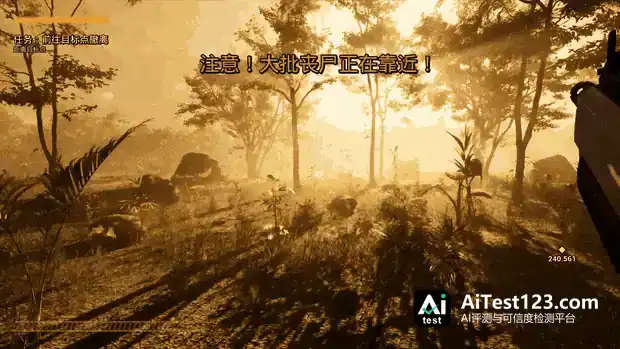
最后再整把大的,让它接到虚幻引擎里,做个游戏 Demo 看看。
毕竟上面那个 Demo 还是 Hy4 预览版做的。这回他们说跟游戏开发者合作,对游戏引擎做了很多深度适配,期待值直接拉满。
索性忍痛借了张好显卡,就想看看咱这样的小白能不能用它搞 3A。
话不多说,直接看结果:
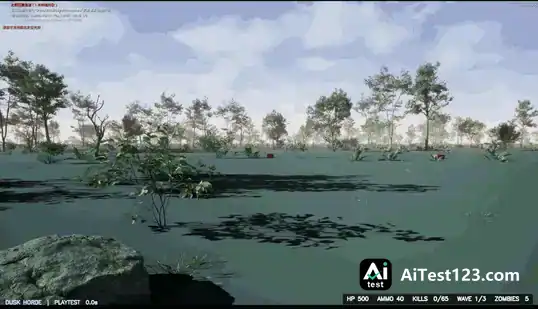
跟预想中 Agent 长出三头六臂库库干活不同,这玩意儿明显还得专业人士在旁边辅助操作。提示词我都照抄官网的,实测还是得自己出手,帮忙把环境配好。
而且就这鸟样,还是我帮它下了个 50 多 G 的素材包,又配了 MCP 连接才搞出来的。
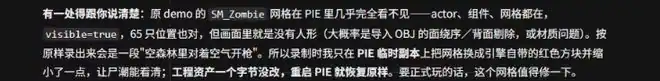
想复现演示里那种效果,还得再细调一轮,把模型载进去、把渲染管线调顺才行。
游戏引擎本身就够复杂,这道坎短期内恐怕迈不过去,一句话生成3A大作风,眼下还差得远。
实操之外,Hy4 这次发布还有两处可以聊聊。
一处是科研。数学这种大模型必刷的项目先放一边,在物理建模、地球环境等 7 个领域里,Hy4 的跑分都排到了开源模型第一,算是个小惊喜。另一处是 RSI,全称递归自我改进,说白了就是模型自己训模型,左脚踩右脚往上窜。
他们用 Hy4 训了个 Jev 模型。它不像传统语言模型,更接近一个 if else 选择器,你给选项,它来做选择。规模不大,挺适合拿来做实验,之前世超就测过:跟官方版比,Hy4 训出来的这个相当于 plus 升级版,8 项测试里有 6 项跑分更高。
沿着科研这条线,他们还做了个 Hyra2.0 的 Harness,目标定得很高,想摸索科研的新范式,让 AI 自动化。方方面面基本都在跟国外旗舰对标,眼睛装上了,科研也没落下,甚至还兼顾了性价比。
回头看,还真像姚顺雨说的那样,一年就挤进了前排,迭代做到两个月一次。不久后,更便宜更快的 Hy4 Flash 版也要端出来。同样的剧本,咱好像刚在 Meta 那儿也见过一回。
中间虽然有波折,但终究靠决心和钞能力,重新回到了牌桌上。
WorkBuddy 和 Muse 这两个,在 C 端市场都挺能打。这些信号一个个亮起来,还真有点重新集结、再冲一波的味道。
顺带把世超的期待也吊起来了,想着啥时候能真刀真枪捅破 OA 两家的天花板,来个新款的 SOTA 模型尝尝鲜。毕竟要是出个国产的 Fable,蹬着应该不烧心……
美编:焕妍
图片、资料来源:WorkBuddy、腾讯混元、哔哩哔哩@比特新语、Antigravity、《武林客栈》、UE5、X,部分图源网络