Edge0开源145B端侧模型:29GB内存跑编程智能体,能力对标云端
Edge0 重磅开源 145B 端侧模型,内存狂省 60% 还能满血写代码
端侧AI部署这次迈出了一大步。开源项目Edge0近日把Edge0-145B和Edge0-120B两个模型正式发布并开源,还配了一套统一的推理框架和部署工具。Edge0-145B被称作全球首个能在个人电脑本地流畅跑起来的1450亿参数开源模型,它把原本只有云端前沿大模型才具备的编程、推理和智能体能力,直接搬到了用户的笔记本上。
硬件极限是怎么被突破的,145B模型为什么能跑在笔记本上?
端侧AI长期卡在一个两难里:模型能力要强,硬件又得跑得动。参数一多,内存和带宽就吃紧;小模型倒是省地方,可复杂点的专业任务就扛不住。把重活推给云端吧,API费用要一直掏,数据隐私受限制,网络还断不得。
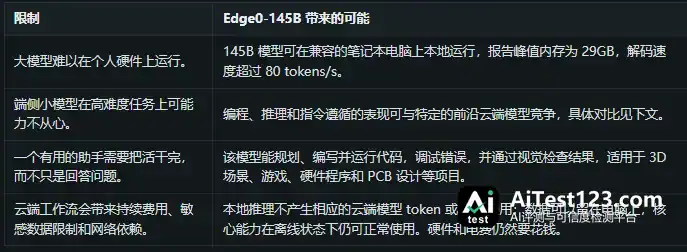
针对这个痛点,Edge0团队在架构、训练、加载、调度四个层面都做了新东西:
稀疏专家架构(MoE):模型让海量稀疏专家共享大矩阵,专家总数不变,需要存储和搬运的权重却少了很多。145B的总参数里,每次推理真正参与计算的只有约10B。
端侧协同训练从零开始:训练早期就把端侧部署的硬约束考虑进去,不像传统云端模型那样事后压缩或剪枝,也就避开了由此带来的性能损失。
三层存储智能流水线:GPU内存、系统内存和固态硬盘(SSD)的访问被串成一条高效流水线。高频的“热专家”常驻GPU内存,约40GB的专家库放在系统内存里按需调入,约48GB的词表数据存在SSD上实时读取,串行等待因此被避开。
CPU与GPU高效协同:已缓存的专家交给GPU算,其余工作由CPU并行处理,再借助投机解码技术,把权重读取的成本分摊到更多输出上。
这些创新落地后,Edge0-145B在兼容的个人电脑上跑出了实测成绩,比如搭载苹果M系列芯片的MacBook Pro,或者配备RTX4090/5090等的Windows平台:峰值内存占用仅29GB,提示词预处理速度超过1,100tokens/s,解码生成速度超过80tokens/s,典型功耗控制在120W左右,支持128K至256K的超长上下文。
编程和推理能力对标云端,复杂的本地工作流也能撑起来
核心能力上,Edge0-145B在多项国际权威基准测试中表现出了很强的竞争力。六项基准测试平均得分72.8;主流云端或大体积基线模型在标准4-bit部署下往往要占70GB至87GB内存,相比之下它的实测内存占用缩减了约40%至60%,能力却处在同一梯队:
编程与智能体:DeepSWE1.1上得分64.6,Terminal-Bench2.1上得分86.52,指令遵循IFBench上得分80.6。
推理与知识:GPQA-Diamond上得分高达90.4,逻辑和知识底子都扎实。
代码生成、工具调用、自我调试、视觉检查这几项能力都不弱,Edge0-145B因此能独立撑起复杂的本地端工作流。官方展示的实际应用场景里,它不只能日常聊天:本地一小时内做完特斯拉Roadster讲解视频的全套制作,在Blender里从零搭出曼哈顿3D城市场景,开发可玩的中世纪RPG游戏,编写控制真实无人机穿过障碍的飞行代码,甚至在KiCad中完成从PCB电路板布局到Unreal Engine装配动画的渲染。整个过程完全在本地离线运行,可观的云端API费用省掉了,核心敏感数据也牢牢握在用户手里。
端侧开源全家桶搭起来了,AI开始往“端侧优先”走
145B模型之外,Edge0过去一年一共发布了四大系列、总计200个不同规模的模型,语音、文本、视觉与记忆都有覆盖,形成完整矩阵:
Edge0系列:145B、120B面向笔记本,35B、8B面向手机,vibe coding与智能体任务都能覆盖。
Audio8系列:专注听与说,从0.1B到3B,多语种语音识别、合成及端到端交互模型都在其中。
Decision0系列:0.6B与3B的多模态快速决策模型,决策延迟被压到40毫秒级别。
Embedding0系列:0.6B多模态嵌入模型,文本、语音、图像和视频的本地长期记忆与RAG检索都支持。
现在,Edge0-145B与Edge0-120B的完整模型权重已在Hugging Face正式开源,统一推理框架与一键部署指南同步登陆GitHub,官方还推出了免环境配置的Edge0App。大模型在端侧硬件上的效率还在不断突破,AI的应用范式正从过去的“云端优先”稳步转向“端侧优先,云端辅助”的新阶段。