MiniMax开源H3-Image:原生4K生图,一张两毛

资讯 网易科技 作者:网易 全文 3528 字 · 约 9 分钟读完 配图 16 张 分类SOTAMiniMax开源图像生成多模态

sina qqZone renren ydCloud 0

所属频道 模型发布开源生态视频图像生成
Jay发自 凹非寺 量子位|公众号QbitAI

坏了,多模态这块是真让MiniMax玩明白了。

开源视频旗舰H3叫好声还没落,新的图像模型H3-Image又把全网刷了一遍。

最火的是「CAD拆解」:丢一张参考图进去,H3-Image直接把手办给你开盒拆开。
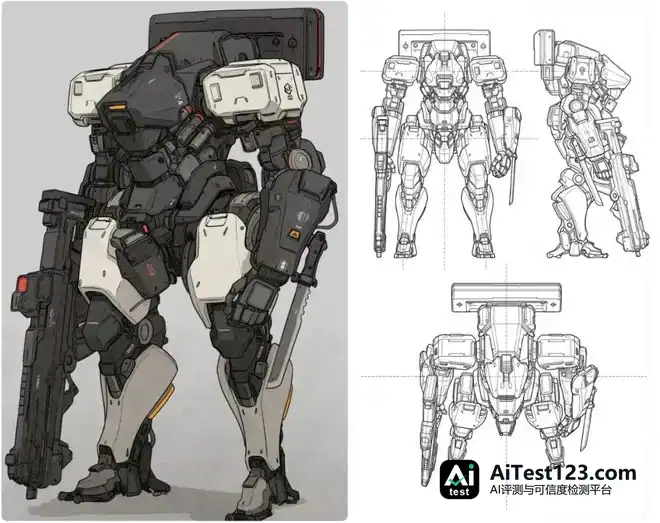
MiniMax开源H3-Image:原生4K生图,一张两毛(配图 1)

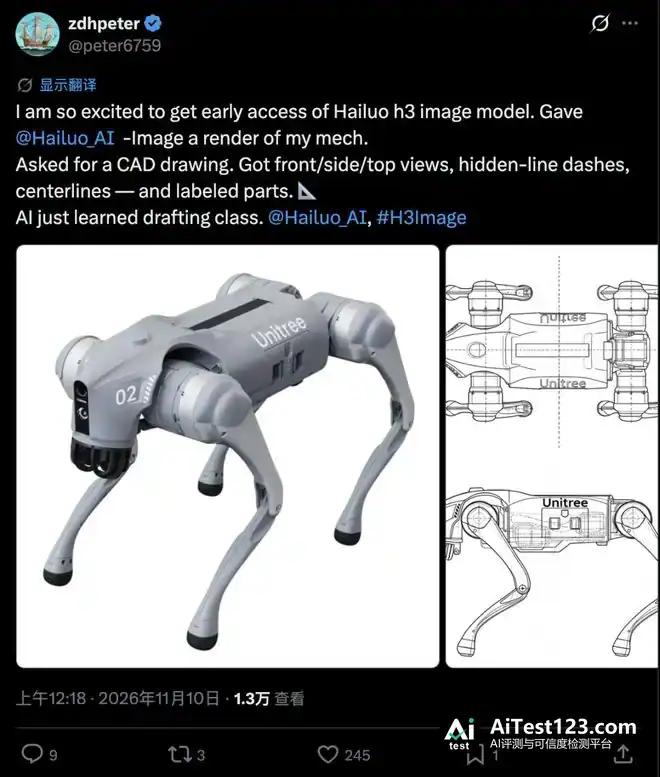
连宇树机器狗也被网友拿去CAD了一遍。

MiniMax开源H3-Image:原生4K生图,一张两毛(配图 2)

一句话,什么都能拆,拆完还替你把零件一个个标清楚。

我自己也上手测了,别说,还真有点东西……

MiniMax开源H3-Image:原生4K生图,一张两毛(配图 3)

海外网友那边,其他复杂生图任务也测了个遍,H3-Image都稳得住,比如游戏这块。
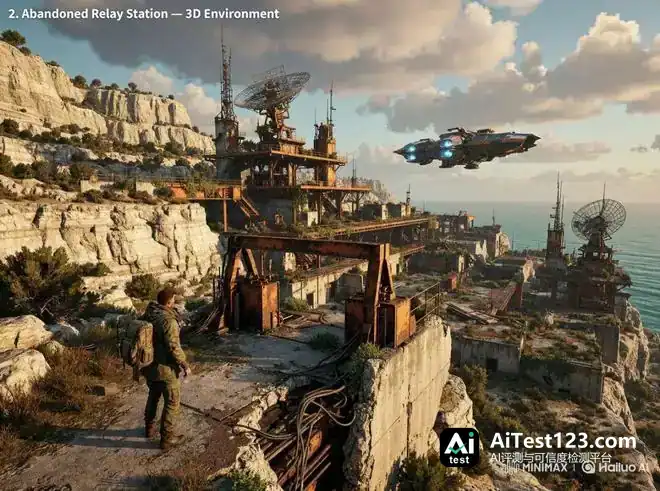
MiniMax开源H3-Image:原生4K生图,一张两毛(配图 4)

这画面,不提前说,我还当是GPT写代码做出来的。

要是只做电商那种简单资产,那就更省事了。
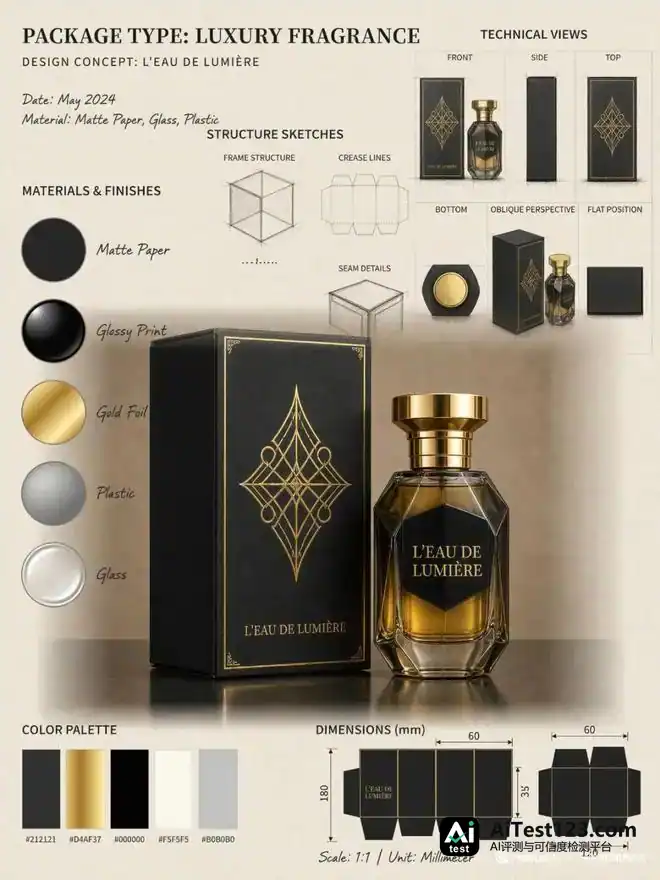
MiniMax开源H3-Image:原生4K生图,一张两毛(配图 5)

没想到的是,这家伙文理都不偏科。

智商在线的同时,H3-Image的审美也拿得出手。
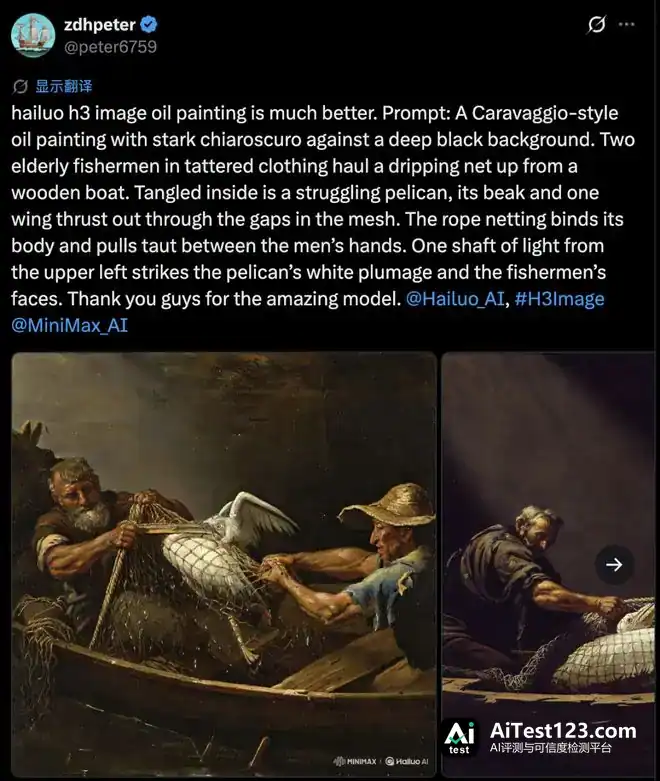
MiniMax开源H3-Image:原生4K生图,一张两毛(配图 6)

对了,还有件事得说。

这种质量的图像生成模型,居然是开源的?

那还说啥。

我宣布,多模态领域的「源神」就是MiniMax(bushi)。

告别塑料「美商」

以前一提AI生图,大家第一反应就是油光满面,皮肤滑得像剥了壳的鸡蛋,眼神发直,伪人感特别重。

说白了,就是一股浓烈的「AI味」。

GPT Image 2在这块进步已经很大,可用久了,恐怖谷效应还是会冒上来。

这回的H3-Image,我感觉这问题基本算是解决了。

生成完我人都懵了,兄弟,这谁看得出是AI?

最关键是脸,毛孔、雀斑,连绒毛都画了出来。

镜子上的水泽和灰尘、闪光灯打在镜头上起的光晕,这些细节处理得也离谱,真跟小某书首页刷到的一样。
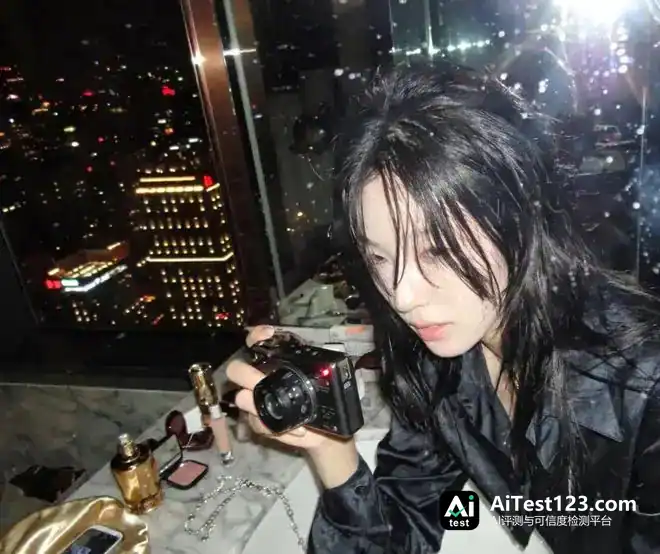
MiniMax开源H3-Image:原生4K生图,一张两毛(配图 7)

从下往上仰拍的角度,脸上的细节照样藏不住。下面这张图把桌子拍成了ins风的时尚杂志封面,人物的眼神、面部肌肉那点细微的牵扯,都跟现实社交里的反应对得上。
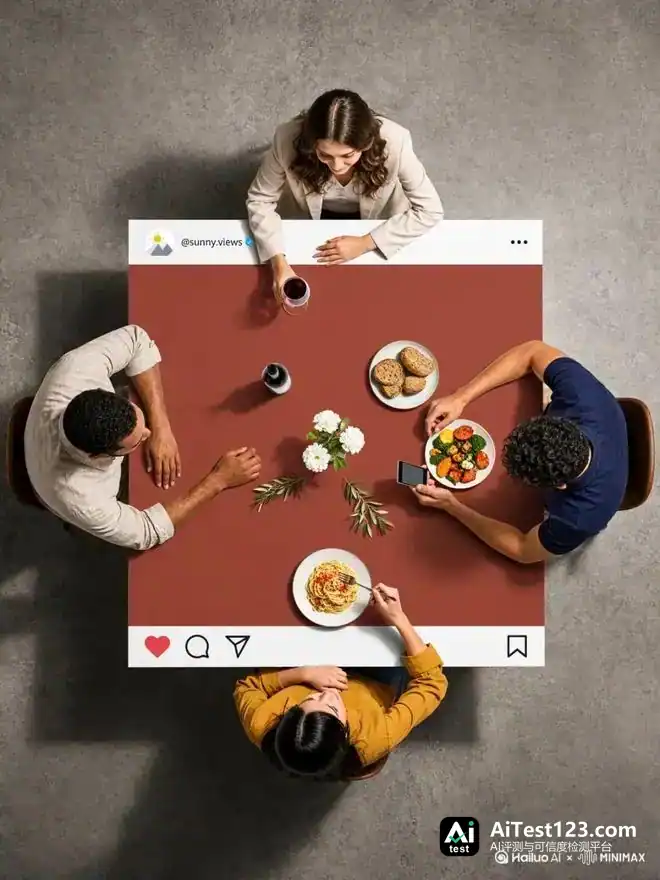
MiniMax开源H3-Image:原生4K生图,一张两毛(配图 8)

测H3-Image的时候,这一点给我的感受最深:以前丢给老模型跑过的不少提示词,换它来做都能给出全新的解释。世界知识这块,确实挺厚实。

人脸以外的主体就更不用说了。比如让它把里约热内卢的城市地标做成一本立体纸雕风格的旅行手帐,微缩景观、光影的厚度,hmm,总有点Fable 5宣传片的味道。
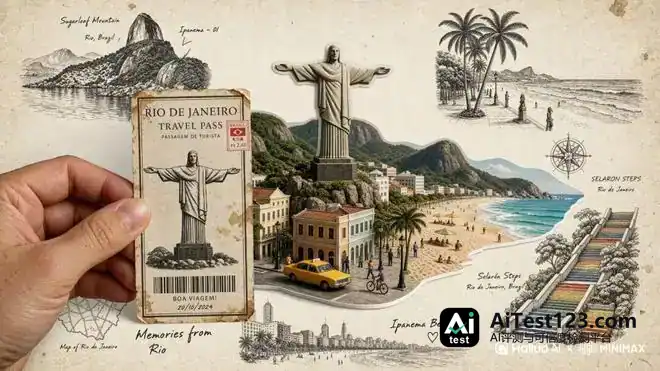
MiniMax开源H3-Image:原生4K生图,一张两毛(配图 9)

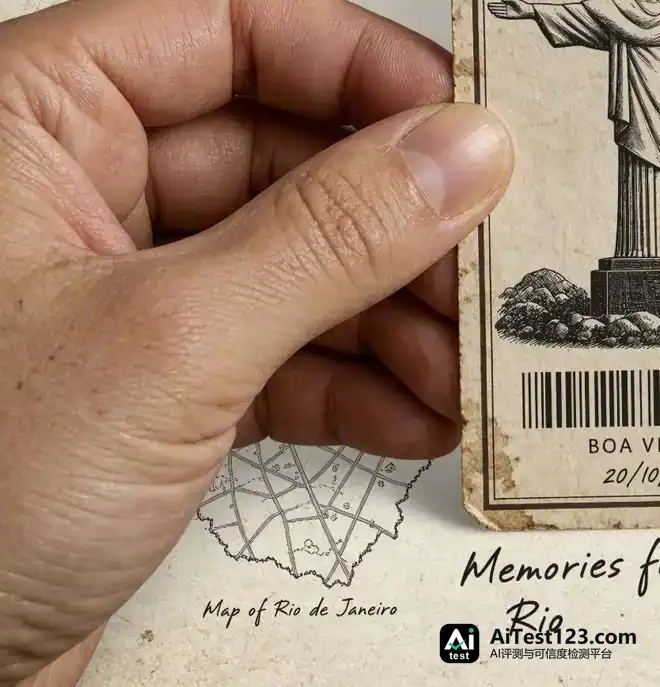
结果小鸡脚又露出来了。看左下角那只手,瞧见没,大拇指关节附近被加上了几颗痣!

可放大之后完全不露怯,手指上的皮肤纹理、关节褶皱,连指甲边缘那种自然的光泽和质感,都清清楚楚。
MiniMax开源H3-Image:原生4K生图,一张两毛(配图 10)

有意思。

我琢磨着,H3-Image身上AI味这么淡,很大程度上可能就来自这些刻意留下的「瑕疵」。人主观做出来的作品,本来就满是随机性,太追求完美,反倒不合人脑接收信息的习惯。

不过这也让我有点犯怵。我一直犟着认为,审美是机器学不会的。现在看,似乎只要把里头的Trick摸透,人类不少引以为傲的品质,可能真没那么玄乎……

再放个demo,我用H3-Image搓了张法国旅游海报。咋说呢,我真不太好意思开口评价,以鄙人的艺术素养,已经完全看不出门道了。

唉。
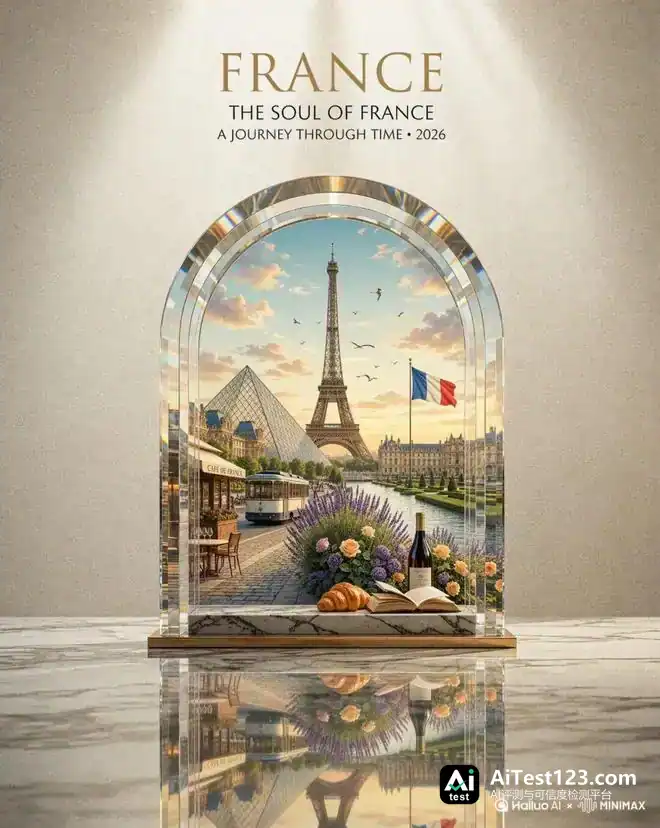
MiniMax开源H3-Image:原生4K生图,一张两毛(配图 11)

SOTA级智力

还是整点我自己能搞明白的任务。对多模态模型,我一直有两个评判标准——美商和智商。美商就是上面测的那些,比较玄乎,只能聊聊主观感受。

智商倒是可以说道说道。比如H3-Image有一项很特殊的技能点——世界理解能力。

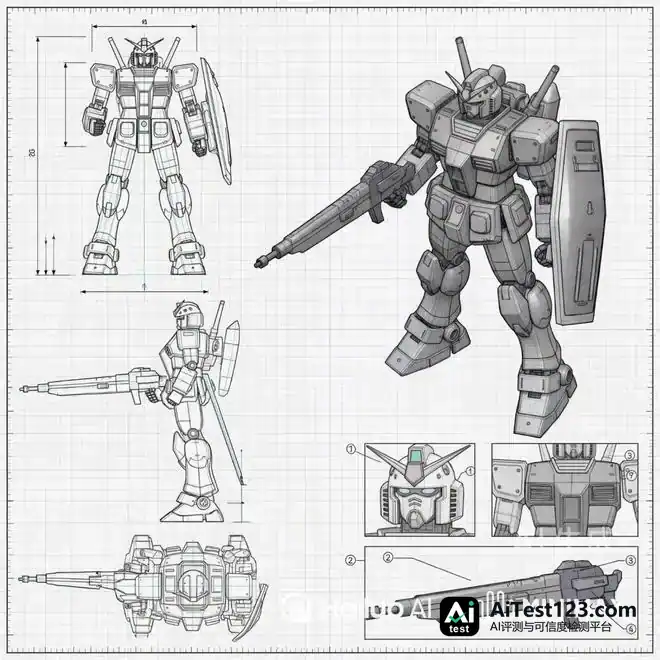
你可以拿它生成CAD图纸。是的,给它一张产品的外观图,它就能自动推演出标准的正交三视图——

正视图、侧视图、俯视图,三张齐了,一个不落。

说实话,看到这儿我整个人都软了。
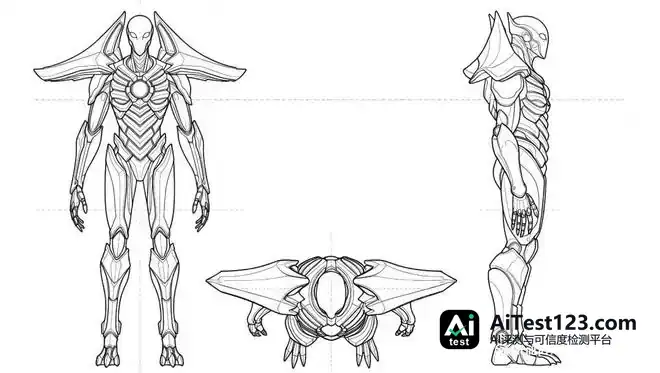
MiniMax开源H3-Image:原生4K生图,一张两毛(配图 12)

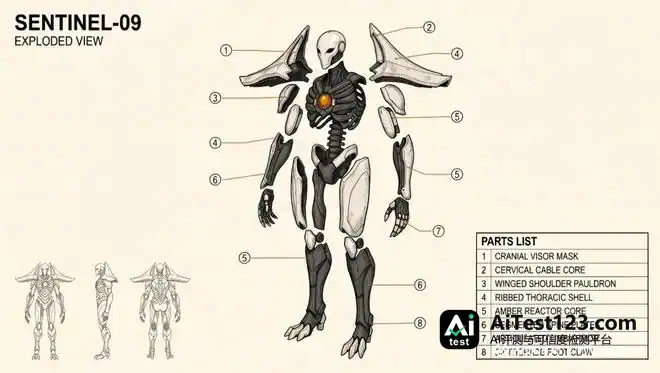
更狠的还在后头——这个模型还能把东西「炸」开。让H3-Image画一张机械拆解爆炸图,它会老老实实按装配逻辑来,把零件分层炸得清清楚楚,连组件引线都标好了。

能做到这一步,靠的是对三维几何和空间关系的理解。

不过这类功能属性明显的图,指令遵循同样是硬指标。光「画」出来不难,难的是模型怎么规划、怎么推理。不然用户丢过来一大堆提示词,它根本搞不清在说啥。
MiniMax开源H3-Image:原生4K生图,一张两毛(配图 13)

当然,要进严肃的生产力场景,尺子就得抬高了:商用图必须把信息传准。空间理解之外,文本排版这一维的分量也很重。
MiniMax开源H3-Image:原生4K生图,一张两毛(配图 14)

于是我又试了一把——

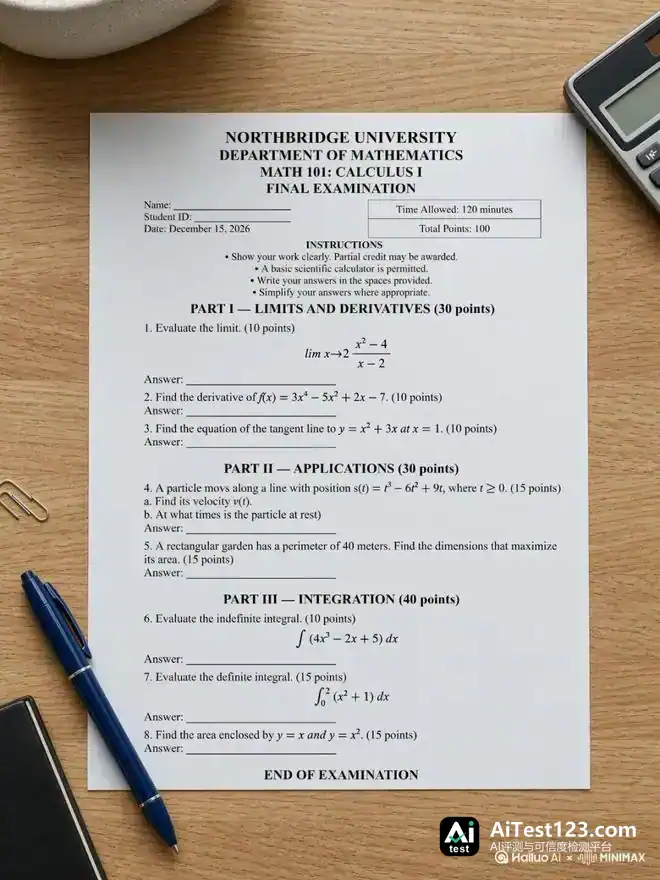
让它生成一份高数期末考卷,十多秒就出来了。

极限符号、复杂积分式,这种高密度的学术排版,一个字符都没乱码。
MiniMax开源H3-Image:原生4K生图,一张两毛(配图 15)

大概是觉得太简单,我又憋出一个天才提示词:

完成这份试卷。

点开一看,我椅子都快炸了。

图像生成模型的微积分水平比我还强,这算什么?

凭我那点勉强结业的高数底子粗看了一遍,答案居然是对的,还带解题步骤!?


一时说不出话。

当然,自己的老本行——资产生成也没落下。

眼下不是流行Coding吃掉一切吗,Astra降维3D,Opus 5.5降维视频。

但我一直觉得,不少是宣传口径。这些跟文本八杆子打不着的任务,我干嘛非得用文本模型?

说到底,纯文本领域资源多、跑得快,也就这样了。

我的判断还是从第一性原理来的:垂直模型这条路更靠谱。各个领域分开训,天花板能更高,成本也更贴近现实。

像H3-Image这类垂直模型,本身就适合专精一件事,接入Harness让Agent直接Tool Call,顺理成章,没什么冲突。

这大概也是最近冒出来的一个方向:不必让单个模型包打天下,用通用模型把各个垂直模型串起来,总体效用反而更高。

如果只是要生成用来展示的资产,比如下面这种恐龙玩具,垂直图像模型显然更划算,犯不着让Computer Use折腾半天。

毕竟现在的图像模型,光影、几何这些基本物理常识早就不是问题了。


小零食也没问题,且看我如何让中国辣条走向全球。


3D游戏画面它也能出,简直倒反天罡。丢一段长文本战术指令进去——掩体、火力压制、侧翼包抄,它马上就能搭出一个3D战斗场景,纵深真实,遮挡关系也合理。

游戏术语遵循得很严,几乎能直接拿去概念设计里用。


那我也不必去蹬Astra Ultra了,反正都是看demo,生成几张图不就得了。(bushi)

多模态「源神」

差不多就这些。另外,作为旗舰图像模型,H3-Image还附送了几项小福利。

最要紧的一项:分辨率直接拉到16MP(4096×4096像素),也就是原生4K。

泪目了家人们,以后不用GPT生完图、再丢给Nano Banana优化半天了。

4K生成速度也很快,这么大的图,网页端体感就10-20秒。

不过话说回来,等GPT磨洋工的时候,谁不想美美来上一把贪吃蛇呢(bushi)。


扯远了。

还有一个参数比较特别——H3最多支持16张参考图输入。

能塞的参考图非常多,对完美主义者是福音;角色一致性、复杂分镜连续性上,创作者的自由度前所未有。

4K日常创作,这下真普及了。

于是你可以随手扔几张参考图,再喝口水……


就能拿到这种质量的装修效果图。

还要啥Blender啊。


不过有件事是我真没料到的:H3-Image居然是开源的。

MiniMax此前开源了SOTA级视频模型H3,这次再度出手,给全球开发者又送上了一个能自由定制的SOTA底座。

多模态源神,这话不用多解释。

即便你懒得折腾部署,走API调用也便宜得很。价格只有主流竞品的50%到70%,首周16MP请求还能再打五折(站起来蹬啊兄弟们!!)。


测到这里,我心里冒出个预感:多模态生成,兴许正迎来属于自己的Coding时刻。

以前AI生图在商业端经常「沦为玩具」,说到底就是细节经不起推敲、塑料感太重,换谁是甲方看了都不乐意。

而现在H3-Image把三件事做到了——去AI味、可泛化的审美、逻辑。

这些条件一旦满足,多模态的应用市场绝不会比编程逊色。

高精度工业包装设计、商业插画、多语言跨境营销物料,图像模型一进来,传统工作流的周期就能大幅压缩。再加上前面说的速度、开源、低价……

那会是个什么样的未来,难以想象。


话说回来,还是把视线移回当下的AI圈。全球AI公司的目光几乎全盯着纯文本,MiniMax却仍把很大一部分精力投在多模态世界。

这其实是这家公司一贯的特点,从一开始就押注多模态,如今总算迎来涌现。

总有人说多模态对AGI不重要,Coding才有商业模式。可我一直觉得,如果AI的定义只容得下文本,这个未来未免太无趣了。

从改写视频生成格局的H3,到眼下在逻辑、结构与审美上全面突破的H3-Image,国产开源这把野火,彻底烧向多模态领域——

蔓延。

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. MiniMax H3 Image开源:原生4K直出,10秒生成

    编辑|泽南、杨文「GPT is cooked.」这两天,这句话在 AI 社区里反复出现。让人坐不住的是 MiniMax 刚发布的图像模型 MiniMax H3 Image。这是一个原生 4K 直出、10 秒级生成、支持 16 张参考图的模型,本周二刚刚开源,刷新了开源图像模型的 SOTA。从大家的第一波反应看,这个说法

    来源 腾讯网
  2. MiniMax开源H3 Image:4K出图约10秒,支持16张参考图输入

    内容编辑丨特工小海 特工小饼内容审核丨特工少女这半年,中国开源的大语言模型越来越强,价格也越来越便宜,能力也越来越趋同。不过有意思的是,当文本模型带来的新鲜感逐渐少了,在图像、视频和 3D 这些多模态领域,要找一个理解力强、成本不高、速度还快的模型,选择却很少,还有不少让我期待的空间。MiniMax 今年开源 H...

    来源 腾讯网
  3. 智谱MiniMax等大模型厂商:Token订阅最低三折,首战双11

    11月11日,天猫商城的天猫AI空间站显示,智谱、MiniMax、千问AI、Qoder等大模型厂商,相继推出五折甚至三折的Token(词元)订阅套餐。这是大模型厂商首次集体参与“双11”网络促销活动,也是其加速向C端(消费端)商业化进程的重要营销事件。

    来源 华尔街见闻
  4. 智谱、MiniMax、阿里云等齐推双11折扣:Token与会员卡低至3折

    大模型厂商迎来史上最热闹的双11促销季。据最新消息显示,包括智谱、MiniMax、千问办公、阿里云以及 Qoder 在内的多家头部大模型厂商,近日集体在天猫 AI 空间站的 Token 充值中心推出了一系列力度空前的折扣活动,多款热门产品和 Token 资源包迎来了大幅让利。 头部厂商集体发力,多款产品迎来大幅折扣 从

    来源 AI 开发者社区
  5. MiniMax闫俊杰谈中美AI差距:效率路线能走多远

    来源:新浪科技 文 | 《硅谷观察》栏目 郑峻 MiniMax创始人兼CEO闫俊杰(Yan Junjie)近期接受了知名投资播客Invest in Progress的专访,向苏格兰抵押信托(Scottish Mortgage)投资经理劳伦斯·伯恩斯(Lawrence Burns)系统阐述了这家中国AI公司的技术路线、商

    来源 AI 行业观察
  6. MiniMax闫俊杰首谈英文播客:效率本身就是智能的一部分

    内容来源:笔记侠(Notesman)。责编 | 二月 第 9960 篇深度好文:3878 字 | 11 分钟阅读商业思维MiniMax的创始人闫俊杰,很少接受长篇采访。11月3日,他第一次接受英文播客采访,也是MiniMax今年1月登陆港交所之后,一次少见的创始人公开表达。对面的提问者,是一家持仓方的投资人,参与了Mi

    来源 腾讯网
  7. 速腾聚创联手BitRobot:发布100小时RoboCap LiDAR-100数据集

    【TechWeb】11月12日消息,11月11日CoRL2026期间,速腾聚创宣布与BitRobot达成战略合作,双方围绕三维感知与真实世界数据采集展开协同,合作成果之一的RoboCap LiDAR-100数据集同步发布。 据悉,该数据集采用速腾聚创三维感知方案,收录100小时厨房、汽修及汽车美容等真实作业,为机器人理

    来源 AI 行业观察
  8. 谷歌发布 Gemini Decisions API,单次调用可完成1000项判断

    该 API 由全新 Gemini Decision 1 模型驱动,支持文本、图像、音频、视频和 PDF 混合输入,最多 256K tokens。输入定价每百万 Tokens 仅 0.10 美元,输出免费,目前已在 Google AI Studio 提供免费额度供开发者试用。#谷歌Gemini# #AI开发者工具#

    来源 IT之家
  9. 谷歌上线 Gemini Decisions API:一次处理最多 1000 个是非判断

    IT之家 11 月 12 日消息,谷歌昨日宣布推出 Gemini Decisions API 快速多模态决策,由全新 Gemini Decision 1 模型驱动。该 API 可在 1 次快速处理过程中,对文本、图像、视频和 PDF 内容进行至多 1000 项是非判断、选项选择和标准评估。 据介绍,Gemini Dec

    来源 AI 行业观察
  10. 谷歌A2UI 1.0正式发布:智能体直接回UI,字节跳动已用上

    IT之家 11 月 12 日消息,A2UI 是谷歌在 2025 年底公布的一份生成式 UI 开放协议,让智能体不仅能回复用户文字,还能直接回复 UI 界面内容。今日,谷歌正式发布了 A2UI 1.0 版本,这是该协议的首个稳定版。开发者现在可以搭配开源的网页、Android 和 iOS 渲染器 SDK 以及 Pytho

    来源 腾讯网
  11. 同一模型多转几圈,准确率涨13个点:Lehigh团队提出循环决策模型Lev

    新智元报道 设想一个客服系统,每秒涌进成百上千条用户请求。每一条都要先过一个「分诊台」:这是退款、查物流,还是投诉?要不要转人工?该调哪个工具?这类问题有一个共同点:答案就在给定的几个选项里。为此,业界有了专门的决策模型,例如Jev和开源的Kev。它们读入请求和候选项,一次前向就给出每个选项的概率,几十毫...

    来源 腾讯网
  12. 蚂蚁灵波开源触觉模型LingBot-Touch:三类传感器统一成触觉Token

    这两天,Claude Fable 5.2的消息大家都看到了,真机演示了拧瓶盖、解魔方、画画等任务,一气呵成,直接把双臂泛化成功率拉到64.9%,是Astra的两倍还高。 同一时间,蚂蚁灵波科技开源触觉基础模型LingBot-Touch,把磁触觉、视触觉、压阻式三类完全不同的传感器信号统一成同一套“触觉Token”,供不

    来源 AI 行业观察
向下滚动自动加载更多