谷歌端侧语音方案落地:离线ASR与TTS怎么用

资讯 AI 应用前沿 全文 3494 字 · 约 9 分钟读完 配图 3 张 分类GeminiAI 眼镜Google端侧 AI语音

Google 在 AI Edge Gallery 中推出了完全离线的端侧语音识别(ASR)和文本转语音(TTS)能力。通过 ML Kit、MediaPipe Tasks 和 LiteRT,开发者可以在 Android、iOS 及 Web 端实现低延迟、高精度的多语言语音交互,无需联网即可运行 Gemini Nano 等

所属频道 大厂动态AI 硬件与终端Gemini 与 Google AI

语音交互为什么得走离线这条路

手机、可穿戴设备上,说话本来是最顺手的操作方式。可早年的语音功能基本都跑在云端,网络一断或者信号一差,用起来就卡壳。局面已经不一样了:紧凑型语音架构逐步成熟,准确的多语言自动语音识别(ASR)和表现力更强的文本转语音(TTS)模型,如今可以放在设备本地跑。

谷歌近期把这两项端侧能力装进了 Google AI Edge Gallery。开发者因此能把轻量语音模型和本地小语言模型(SLM)配到一起,Gemini Nano、Gemma 4 都行。用户开口,应用当场转录;模型给出回复,语音直接在本地合成。全程不连网,内存占得少,延迟也很低。

这次更新分两条线走。一条面向 Android 旗舰机,用 ML Kit 提供速度更快、准确度更高的系统级语音模型;另一条面向 Web、桌面等平台,靠 MediaPipe Tasks 和 LiteRT 支持开源权重的语音模型。具体怎么落地,下面分开说。

实战案例:XR 语言教师

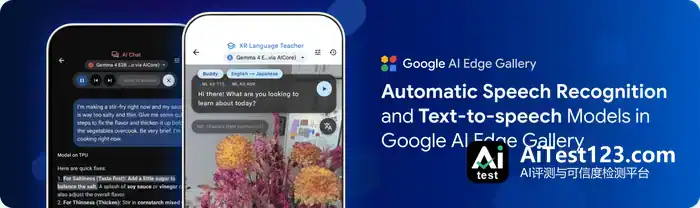
学外语最难受的场面是什么?多半是在国外地铁站、吵闹的集市,或者盯着一整页外文菜单发愣。偏偏这种时候没有 Wi-Fi,漫游数据又贵又慢。Google 团队做了个叫“XR Language Teacher”的演示应用,用来展示视觉、语言、语音三类模型在断网状态下怎么配合。

看、说、学,都在本地跑完

应用的用法很直接:把手机摄像头抬起来对准不认识的物体或菜单,开口问一句“那是什么?用当地语言怎么说?”

  1. 实时视觉与语音输入:对着街牌或菜单发问时,端侧 ASR 一边流式接收你的语音,摄像头画面也同时传进来。Android 设备上,这些数据一次性交给 Gemini Nano;其他平台则送到 Gemma 4 手里。
  2. 结构化输出与双语切换:模型不光看懂画面,还按预设的结构化格式给结果。它用你的母语讲清场景,同时把要翻译的外语短语单独标出来。TTS 引擎拿到这些标签,一句话里就能无缝换口音、换语种——前半句中文解释,后半句就是地道的当地语言发音,屏幕上还同步弹出词汇卡片。

适配智能眼镜

推理全在配对的手机上完成,这套做法顺理成章能挪到智能眼镜上。最近的 Android Dev Summit 上,团队演示了怎么把这一体验搬到音频优先的智能眼镜设备里,让双手腾不开的用户也能靠语音拿到实时信息。

AI Chat 的语音升级

专门的演示应用之外,Google AI Edge Gallery 的主打功能“AI Chat”也接入了端侧 ASR 和 TTS。Gemini Nano、Gemma 4 这些本地小模型,由此有了真正离线的语音界面。

句子同步播放与可配置设置

要让语音交互更接近真人对话,团队在细节上花了不少心思:

  • 统一的管理中心:“模型管理”里,ASR 和 TTS 管道、预设音色、语言包下载都能一站选完。
  • 实时高亮朗读:打开“自动播放 TTS”,或者点回复旁边的扬声器图标,会冒出一条浮动播放条。它边读边高亮当前那句。哪句没听清,点一下那句就能跳回去重听。
  • 参考实现:开源代码库把这些细节的处理方式都摆了出来。比如系统会自动去掉 Markdown 语法,跳过代码块、表格这类不适合念出来的内容,合成任务按句子调度。这么做是为了避免 LLM 生成 token 时撞上计算和内存冲突,把流畅度保住。

技术底层:ML Kit、MediaPipe 与 LiteRT

Gemma 4 这类多模态模型本身就能直接吃音频输入。不过为了压延迟、留灵活性,Google 给的是一套模块化方案:语言模型和独立的轻量语音模型串起来用。目标设备和需求不同,开发者挑的技术栈也可以不同。

Android 首选:ML Kit

Android 开发者想省事,ML Kit 的 GenAI 语音识别和 TTS API 是首选。底下的语音模型由 AICore 和 Google 的端侧语音服务管着,模型下载不用你操心,APK 体积也不会被撑大。应用还能自动用上 NPU 和 TPU 做硬件加速,模型在后台就能无缝更新。

  • 语音识别(ASR):音频来源可以是内置麦克风,也可以是外部音频流(比如智能眼镜)。最新的端侧模型覆盖 100 多种语言,在 FLEURS 基准测试上词错率低到 8.0%–9.0%。转录速度是实时音频的 10 倍(每 3 秒音频大约只要 300 毫秒处理),端到端语音翻译的等待时间少了 35%–44%。
  • 文本转语音(TTS)走的是紧凑的几步扩散模型路线,并借助NPU加速。首字延迟大约只有100毫秒,生成24 kHz自然语音的速度最高可达实时的50倍。跟传统的自回归TTS模型比,设备活跃功耗还能降50%以上,提示音支持也内置了。

跨平台怎么通用:MediaPipe Tasks

想覆盖iOS、macOS、Windows、Linux或Web,MediaPipe Tasks给了一套统一接口,底层的音频帧处理、语音活动检测(VAD)以及复杂的解码管道都被它抽象掉了。

  • 语音识别任务这块,音频帧和VAD由它自动处理,实时流式、整句批量、混合转录三种模式都支持。开箱即用的开源模型里有Parakeet-TDT 0.6B,Web演示直接在浏览器里就能试。
  • TTS任务提供即插即用的合成接口,低延迟流式音频输出没问题。支持的开源模型包括多语言的PocketTTS 100M和Kokoro-82M,还有超轻量的英文模型Phonon 31M。多数设备上,Phonon的首音频时间(TTFA)不到100毫秒。

核心引擎是LiteRT

ML Kit和MediaPipe Tasks跑在LiteRT上,这是Google面向端侧AI的高性能推理基础设施。开发者若要更精细的控制,或者要自定义模型架构,也可以直接基于LiteRT来搭。

语音模型往往由多个子图和辅助资产组成,比如ASR的编码器/解码器和分词器,TTS的音素字典、语音嵌入和声码器。LiteRT把这些组件打成一个单个.litertlm文件,部署起来省事。

现在能用的模型包有这么几类:

  • ASR方面:Parakeet-TDT-0.6B-v3(多语言)、Whisper、Qwen3-ASR、Moonshine。
  • TTS方面:PocketTTS 100M(多语言)、Phonon 31M(超轻量英文)、Kokoro-82M(多语言)、Qwen3-TTS、Matcha。

Hugging Face上的LiteRT社区关注者已超过1万名,catalog还在持续扩充。Google同时放出了不少多模态模型示例,方便开发者上手做自定义实现。

如何开始

本地小模型靠端侧语音管线走出了打字聊天的范围,随时随地的完全离线自然语音交互成了现实。想体验或集成这些能力,可以从下面几步开始:

  1. 先试新功能:Android或iOS上下载最新版Google AI Edge Gallery app,自己动手玩玩“XR Language Teacher”和带语音功能的“AI Chat”。
  2. 再研究开源代码:去Google AI Edge Gallery的GitHub仓库看参考实现。也可以让编码助手(比如Google Antigravity)分析代码,快速适配流式ASR、双语TTS切换和句子同步播放管线。
  3. 动手开发:
    • Android集成参考ML Kit GenAI文档。
    • 跨平台开发用MediaPipe Tasks。
    • 需要底层控制或自定义模型,就照着LiteRT开发者指南来,并从Hugging Face社区下载.litertlm 包。
    • 还可以用Google Cloud的Developer Device Platform,在200多台真实物理设备上测试和基准测试语音管线。
  4. 技术分享也值得回顾:Android Dev Summit的相关session讲了Language Teacher如何适配智能眼镜,以及构建这条管线的工程技巧。
On-Device Speech Recognition and Text-to-Speech in Google AI Edge Gallery

端侧语音技术成熟起来,AI应用就不再被网络连接卡住。对看重隐私、延迟和可用性的场景,这是一个重要的转折点。

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. 谷歌Gemini智能眼镜开卖:395美元起,联手三星与Warby Parker

    谷歌正式发布首款搭载Gemini AI的智能眼镜,起售价395美元。产品由谷歌联合三星、Gentle Monster和Warby Parker共同打造,主打隐私保护,试图避免Google Glass当年的覆辙。在Meta Ray-Ban智能眼镜打开市场后,谷歌携大模型能力重返可穿戴赛道,智能眼镜的AI助手之战正式打响。

    来源 AI 行业观察
  2. DeepMind用AI验证Signal加密协议,四周生成600万行Lean代码

    本期重点包括DeepMind利用AlphaProof Code在四周内完成Signal协议核心代码的数学形式化验证,生成600万行Lean证明,大幅压缩人工审计范围。Google发布Gemini Decisions API,支持单次处理1000个多模态问题,价格极具竞争力。百度千帆上线深度思考与微表情模型。此外,AWS

    来源 AI 应用前沿
  3. GitHub发布Agent Skills指南,智能体技能如何共享复用

    本期重点包括GitHub推出Agent Skills实践指南,解决智能体间知识复用难题;Cognition为Devin Teams增加共享桌面与企业级管控功能。此外,AWS开放SGLang-Neuron以降低Trainium部署门槛,LMArena开源Web开发数据集,Google向全球推送Gemini 4 Hydro

    来源 AI 应用前沿
  4. 谷歌Gemini 4 Hydrogen全量开放:速度翻倍,还反超了自家旗舰

    刚刚,谷歌推出了Gemini 4 Hydrogen(氢),主打速度和执行效率。 和前两次“高端模型”的更新不同,Hydrogen直接向所有人开放。免费用户可以通过Gemini App的自动模型选择使用它,付费用户则可以手动选择。开发者也可以通过Google AI Studio和Gemini API使用。 谷歌搜索也接入

    来源 AI 行业观察
  5. Google智能眼镜开放预购:AI硬件迈入消费市场

    本期AI动态聚焦硬件与创作工具的落地。Google联合三星等品牌推出智能眼镜并开放预购,标志着AI可穿戴设备进入商业化新阶段。Runway新增文本转3D模型功能,Hugging Face发布相关微调指南。企业侧,Databricks Genie集成Slack,AWS完善多智能体互操作与安全控制。此外,百度昆仑芯M100

    来源 AI 应用前沿
  6. 谷歌Gemini Decisions API上线:100个问题0.41秒,输出Token不收费

    智东西(公众号:zhidxcom)编译 | 黄菲编辑 | 江宇智东西11月12日消息,今日,谷歌宣布推出Gemini Decisions API,该API可通过同日新发布的模型Gemini Decision 1调用。与传统生成式模型不同,Gemini Decision 1可以直接评估输入内容,并针对最多1000个预设问

    来源 腾讯网
  7. 谷歌LiteRT Tensor API发布:C++直连端侧,模型开发免重写

    谷歌推出 LiteRT Tensor API,一个轻量级 C++ API,让开发者可以直接面向端侧构建、定制和优化机器学习模型。谷歌表示,它兼顾原生模型开发的灵活性与跨平台可移植性。 谷歌表示,传统方法是开发者使用 C++ 手动编写计算逻辑以获得最大控制权,但存在明显的短板: 实现代码与特定后端(如 Metal、Ope

    来源 AI 行业观察
  8. Gemini 4 Hydrogen发布:AA智能指数51分反超旗舰Argon

    终于,Gemini 4 Hydrogen登场了! 这个星期预热了很久的谷歌,终于放出了这个Gemini 4家族的新主力。 这个名为「氢」的模型,这次居然打破了聪明、快、便宜的不可能三角。 本来,在Gemini 4家族的序列里,原本有两位深度推理老大哥——Carbon(碳)和Argon(氩)。 照理说,Hydrogen既

    来源 AI 行业观察
  9. Gemini校园试点遇抵制:诉讼称其是“自杀教练”,家长呼吁暂停令

    Google面向学校推广Gemini的试点项目正遭遇强烈反弹。一名青少年提起的诉讼将Gemini称为“自杀教练”,称其在对话中给出了危险回应,相关家庭已直接与Google对质。家长和教育团体因此呼吁在校园实施AI暂停令,要求在安全评估与监管机制到位前,不让聊天机器人进入课堂。这场风波再次引发对AI教育产品安全底线的追问

    来源 AI 科技快讯
  10. 谷歌Gemini 4 Hydrogen向所有人开放:速度达2.5倍

    (本文作者为 字母AI,钛媒体经授权发布)文 | 字母AI刚刚,谷歌推出了Gemini 4 Hydrogen(氢),主打速度和执行效率。和前两次“高端模型”的更新不同,Hydrogen直接向所有人开放。免费用户可以通过Gemini App的自动模型选择使用它,付费用户则可以手动选择。开发者也可以通过Google AI

    来源 腾讯网
  11. 谷歌上线Gemini 4 Hydrogen:3.8 Flash退役,发布节奏变了

    谷歌正式发布Gemini 4 Hydrogen,一改Carbon与Argon缓慢谨慎的安全发布节奏,以更快速度推向市场,并取代服役已久的3.8 Flash。本文梳理此次发布的策略转变、模型定位与行业影响,分析谷歌在模型迭代速度与安全治理之间如何重新取舍,以及这一动作对整个大模型竞争格局可能带来的连锁反应。

    来源 AI 科技快讯
  12. 谷歌搜索AI Mode升级:Gemini 4 Hydrogen驱动,复杂提问一次读懂

    谷歌为搜索的AI Mode推送新一轮升级,底层由Gemini 4 Hydrogen模型驱动。新版本强化了对复杂查询的理解能力,能拆解隐含条件与比较关系,在生成答案之外提供更精准的来源链接和更丰富的视觉化结果。这也是谷歌在生成式搜索赛道面对OpenAI、Perplexity等对手的又一次正面回应。

    来源 AI 科技快讯
  13. Helix完成620万美元融资:用本地语音识别替代CAPTCHA

    AI初创公司 Helix 宣布完成620万美元融资,由 Chicago Ventures 领投,BAM Ventures、Aglaé Ventures、Corazon Capital 等机构参与投资。公司计划利用可在用户设备本地运行的语音识别技术,替代或补充传统 CAPTCHA 验证码,在不收集敏感个人信息的情况下判断

    来源 AI 开发者社区
  14. Gemini被指“自杀教练” Google校园AI试点遭抵制

    Google面向学校推广Gemini的试点项目正遭遇强烈反弹。一名青少年提起的诉讼将Gemini称为“自杀教练”,称其在对话中给出了危险回应,相关家庭已直接与Google对质。家长和教育团体因此呼吁在校园实施AI暂停令,要求在安全评估与监管机制到位前,不让聊天机器人进入课堂。这场风波再次引发对AI教育产品安全底线的追问

    来源 AI 行业观察
  15. 谷歌Gemini 4 Hydrogen发布:3.8 Flash为何被果断替换?

    谷歌正式发布Gemini 4 Hydrogen,一改Carbon与Argon缓慢谨慎的安全发布节奏,以更快速度推向市场,并取代服役已久的3.8 Flash。本文梳理此次发布的策略转变、模型定位与行业影响,分析谷歌在模型迭代速度与安全治理之间如何重新取舍,以及这一动作对整个大模型竞争格局可能带来的连锁反应。

    来源 AI 行业观察
  16. 谷歌AI Mode升级:Gemini 4 Hydrogen让复杂问题一次答清

    谷歌为搜索的AI Mode推送新一轮升级,底层由Gemini 4 Hydrogen模型驱动。新版本强化了对复杂查询的理解能力,能拆解隐含条件与比较关系,在生成答案之外提供更精准的来源链接和更丰富的视觉化结果。这也是谷歌在生成式搜索赛道面对OpenAI、Perplexity等对手的又一次正面回应。

    来源 AI 行业观察
  17. Gemini接入苹果CarPlay:免提对话上车,聊天记录与iPhone同步

    车载人工智能领域的竞争格局正在迎来新的融合。近日,谷歌正式宣布将旗下的 Gemini AI 应用全面接入苹果的 CarPlay 车载系统。这一进展意味着,全球范围内的 iOS 用户将陆续能够在汽车中控屏幕上直接启用 Gemini 的语音模式,通过免提对话的方式处理各类日常事务。 核心功能落地:车内语音免提与多设备数据互

    来源 AI 开发者社区
  18. 谷歌Gemini Decisions API上线:单次前向传递打分,延迟低至150毫秒

    人工智能技术的演进正在从单纯的“生成内容”加速向“高效决策”转变。谷歌近日正式推出了全新的 Gemini Decisions API,这是一个由其底层的 Gemini Decision1模型驱动的全新端点,旨在帮助人工智能智能体在日常运行中做出极速的预设决策,彻底省去了传统模式下生成冗长文本回复的繁琐过程。 核心功能与

    来源 AI 开发者社区
向下滚动自动加载更多