TensorFlow 2 语音识别实战:从环境搭建到 CTC 的完整路径

资讯 AI 应用前沿 全文 4007 字 · 约 11 分钟读完 配图 3 张 分类语音芯片

这本书不讲虚的,直接上手TensorFlow 2.1。从安装GPU驱动开始,讲清楚Keras API、ResNet残差块、LSTM时序处理,最后用MFCC和CTC算法跑通一个完整的中文语音转文字项目。适合想跳过理论推导、直接看代码怎么写的开发者,也适合需要补充底层原理的初学者。

所属频道 算力与芯片

为什么现在还要学 TensorFlow 2 做语音识别

PyTorch 在学术圈确实热,可真到工业界要落地部署,TensorFlow 的位置仍然很难被替代。TensorFlow 2 把 API 彻底重做了一遍,Keras 成了默认的高层接口,过去那个“难用”的 TF 因此顺手了不少。
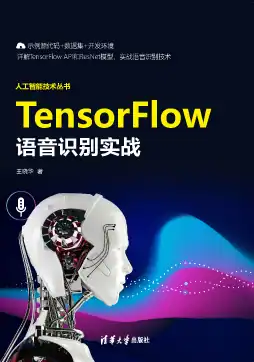
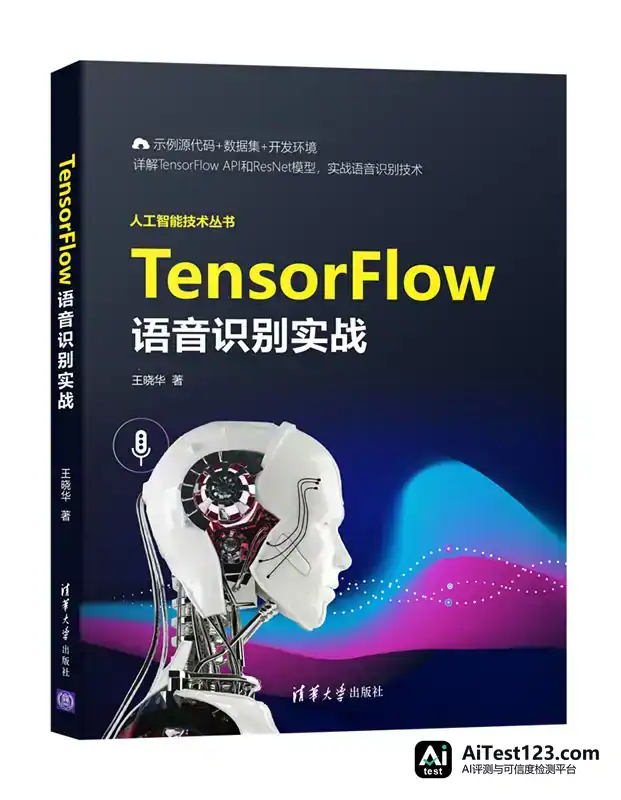
封面

王晓华这本《TensorFlow语音识别实战》2021 年出版,基于 TensorFlow 2.1 版本。今天再看,这个版本算不上新,可核心架构没怎么动——Eager Execution、Keras Model、Dataset API 都还在。语音识别(ASR)这套技术栈本身也相对稳定:前端特征提取用 MFCC 或 Fbank,后端模型从 CNN+RNN 一路演进到 Transformer/Conformer,损失函数绕不开 CTC 或 Attention。这本书把这些环节串成了一条线,还配了能跑起来的代码,价值就在这里。

对刚入门深度学习的开发者来说,如果不想一上来就陷在数学公式里,而是希望先跑通一个 Demo、再回头补理论,这本书的路径是对路的。

别在环境搭建上卡壳

不少教程第一章就开讲反向传播,读者连 Python 环境都还没配好。这本书第一章走的是务实路线:装 Python、装 Anaconda、装 PyCharm,然后把重点放在 TensorFlow 2.1 的 CPU 版和 GPU 版安装上。

有个细节作者专门写了:GPU 显卡怎么挑。深度学习训练没有 GPU,过程相当难熬。书里演示了怎么确认安装成功——跑一个简单的 Hello TensorFlow。看着不起眼,但 CUDA、cuDNN 版本不匹配这类最常见的坑,正好能靠这一步排掉。
作者简介配图

紧接着第一章就上了一个小实战:基于特征词的语音唤醒。它不像那种只打印一句 “Hello World” 的示例,而是把数据准备、数据处理、模型设计、输入方法、训练和结果展示完整走了一遍。这种小步快跑的路子,能让初学者很快建立起信心。

TensorFlow 2 的核心:Keras 与模型构建

第二章是全书的地基。TensorFlow 2 变化最大的一点,就是 Keras 成了亲儿子。书里把两种建模方式摆在一起做了详细对比:

  1. 顺序模式(Sequential):层叠结构简单时用它合适,比如几层全连接,或者简单的 CNN。
  2. 函数式编程(Functional API):这是重点。实际项目里的模型常常有多输入、多输出,或者带残差连接,顺序模式应付不了,只能上函数式 API。

作者拿鸢尾花分类这个经典案例,演示了怎样用 Keras API 搭模型,以及模型怎么保存、怎么复用。书里还专门讲了“自定义层”的写法。为什么要自己写?标准库里的层未必合你的需求——比如要加一个特殊激活函数,或者改数据流向,那就得动手写 Layer 类。

这一章也讲到了 TensorFlow 的标准化编译方法,还有多输入单输出、多输入多输出这些复杂场景。后面的语音识别模型会反复用到它们,比如语音信号当输入、文本序列当输出,中间还可能夹着声学特征。
内容简介配图

理论基础:不推导公式,但要看懂图

第三章讲深度学习理论。很多书在这一章堆公式,读者看得一头雾水。作者换了个讲法,用“道士下山的故事”来解释梯度下降算法。比喻当然替代不了数学,但理解方向够用了。

这一章的重头是 BP(反向传播)神经网络。作者手写了一个反馈神经网络,用 Python 代码把链式求导法则展示出来。误差究竟怎么从输出层传回输入层,搞清楚这一点很关键。要是只会调用model.fit(),却不清楚背后在发生什么,调参的时候就跟盲人摸象差不多。

书里还介绍了激活函数。ReLU 凭什么比 Sigmoid 好用?深层网络为什么需要 Batch Normalization?这些知识点都配着代码讲。

从图像到语音:CNN 与 ResNet 的迁移

第四章和第六章表面讲的是图像识别(MNIST、CIFAR-100),实际上是在给语音识别铺路。

语音信号预处理之后,一般会转成频谱图(Spectrogram)。这张图在计算机看来就是一张二维图片。卷积神经网络(CNN)因此在语音识别里大有用武之地,专门用来提取频谱图中的局部特征。

第四章借 MNIST 手写数字识别,讲了卷积运算、池化运算和 Softmax 激活函数,也演示了自定义卷积层怎么写。这一步的目的是让你熟悉 CNN 的基本组件。

第六章引入了 ResNet(残差网络)。深层网络的退化问题被它解决了,其“残差块”思想后来被大量用到语音模型里(比如 Wav2Vec 的某些变体)。书里除了 ResNet,还讲了它的兄弟 ResNeXt,并把两者的区别做了对比。作者在 CIFAR-100 数据集上实战了 ResNet 的分类任务,代码结构清晰,展示了如何使用 TensorFlow 的高级模块layers省得一切从头造。

处理时序数据:RNN、LSTM 与 GRU

语音属于典型的时序数据,前后帧之间关联很强。提取空间特征,CNN 拿手;可要应付时间上的依赖关系,还得交给 RNN(循环神经网络)。

第七章是语音识别最关键的章节之一。LSTM(长短期记忆网络)和 GRU(门控循环单元),作者在这一章里讲得很细。

  • LSTM:传统 RNN 的梯度消失毛病,它给解决了,远距离的信息也能记住。三个门——遗忘门、输入门、输出门——各自怎么运作,书里都讲了。
  • GRU:相当于 LSTM 的精简版,参数少一些,训练也更快,实际效果常常差不了多少。

双向 RNN(Bidirectional RNN)在章里同样被提到。做语音识别,上下文信息一般要一起用上,双向结构因此成了标配。TensorFlow 里怎么搭双向 LSTM 层、搭好之后怎么用到语音识别任务上,作者都做了演示。

自然语言处理的铺垫:词嵌入与 Transformer

声学特征要变成文字,才算走完语音识别的最后一步。这一步会用到自然语言处理(NLP)的技术。

词嵌入(Word Embedding)放在第八章。内容从 Word2Vec 讲到 fastText,再到预训练词向量。作者举了个挺有意思的例子——“梅西-阿根廷+意大利=?”,用来说明词向量怎么抓住语义关系。用 CNN 做文本分类(TextCNN)同样有介绍,一维卷积(Conv1D)和二维卷积(Conv2D)在文本处理里各自怎么用,也都包含在内。

第九章走得更靠前,讲 Transformer。书名叫 TensorFlow 语音识别,可 Transformer 如今已是 ASR 的主流架构(比如 Conformer)。注意力机制(Attention)、自注意力层(Self-Attention)、多头注意力(Multi-Head Attention)以及 Layer Normalization,作者逐一做了讲解。

这章动手做的项目是个“汉字拼音转化模型”。说白了,它就是语音识别里“解码”环节的简化版:输入拼音序列,输出汉字序列。编码器和解码器搭起来之后,Sequence-to-Sequence(Seq2Seq)模型的工作方式,读者能看得比较直观。

终极实战:MFCC + CTC 实现中文语音转文字

全书的高潮落在第十章。前面铺了那么多,等的就是这一刻。

作者挑了两个关键技术:

  1. MFCC(梅尔频率倒谱系数):语音识别里最经典的特征提取手段。它照着人耳感知声音的方式,把原始音频波形变成一组特征向量。
  2. CTC(Connectionist Temporal Classification):对付语音对齐难题的利器。语音信号的长度跟文字序列的长度对不上——比如“你好”说了两秒,背后是几百个音频帧——CTC 的好处是,没有强制对齐标签也能训练模型。

实战用的是 THCHS-30 数据集,也就是清华大学中文语音数据集。作者按步骤做了演示:

  • 音频文件怎么读。
  • MFCC 特征怎么提取。
  • 混合模型怎么搭:CNN 负责提取特征,RNN 负责处理时序,CTC Loss 负责算损失。
  • 模型怎么训练、怎么做推断(Inference),最后把识别出的汉字输出。

全书最有价值的部分就是这段代码。直接复制下来,换成自己的数据集,一个基础的中文语音识别系统就能跑通。

这本书适合谁?

  • 如果你学过一些 Python,却还没接触过 TensorFlow,这本书可以带你入门;想弄清 ASR 从前端特征到后端解码的整个流程,它也能给出一个完整视角。
  • 高校师生拿它当课程设计或毕业设计的参考教材也合适,代码规范、注释详细;工程开发人员若要快速搭出一个语音识别原型,书里的代码能直接复用或改。

阅读时还有几点可以留意。

  1. 别只看不动手。深度学习本来就是门实践学科,书上的代码最好亲手敲一遍、跑一遍。碰到报错不用慌,调试的过程往往学得最快。
  2. 版本差异要留神。书基于 TF 2.1,如今最新已到 TF 2.x(如 2.15+)。大部分 API 兼容,一旦报错,去官方文档查查有没有弃用警告。
  3. 新知识也得补。书里讲的 Transformer 和 CTC 属于基础,业界眼下更流行 Conformer、Wav2Vec 2.0 等模型。读完这本书,不妨再去 Hugging Face 上看看相关模型,了解最新进展。
  4. 硬件方面,条件允许就尽量用 GPU 训练。用 CPU 跑 LSTM 和 Transformer 会慢得厉害,容易打击积极性。

整体看,《TensorFlow语音识别实战》是本接地气的技术书,没多少学术炫技,重点放在“怎么做”上。想进入语音识别领域的开发者,拿它当起点不错。

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. 英伟达东南亚AI芯片管控收紧:NCP客户须接入追踪系统

    【TechWeb】11月12日消息,据外媒报道,英伟达正在加强对东南亚地区AI加速器的出货监控,寻求官方Nvidia Cloud Partner(NCP,英伟达云合作伙伴)资格的当地客户,必须接入其Fleet Intelligence芯片追踪系统。据报道,Fleet Intelligence系统除收集英伟达硬件的部署信

    来源 腾讯网
  2. 利普思完成近亿元B轮融资:SiC模块厂加码AIDC,海外营收近半

    作者 | 乔钰杰 编辑 | 袁斯来 本文约3800字,建议阅读9分钟 硬氪获悉,国产碳化硅(SiC)功率模块厂商利普思半导体(以下简称“利普思”)近日完成近亿元B轮融资,新投资方为上海新微资本。本轮资金将主要用于加大AIDC相关产品研发和全球市场推广。 利普思(Leapers)成立于2019年11月,总部位于江苏无锡,

    来源 AI 行业观察
  3. Claude三天改写GPU内核,英伟达CUDA壁垒还稳吗

    作者 | 四月计算产业半个世纪的历史反复证明:最难被逾越的工业壁垒,往往不是硅片本身的物理极限,而是数以万计的工程师长期积累的技术经验、海量存量代码,以及由此形成的高昂迁移成本。英伟达耗时近二十年搭建的 CUDA 帝国就是最生动的例子。然而,这道看似坚不可摧的防线,正因它的产物——大模型而开始动摇。11 月 11...

    来源 腾讯网
  4. Claude三天适配AMD MI355X,英伟达CUDA生态面临多大冲击?

    IT之家 11 月 11 日消息,英伟达 CUDA 生态系统的领先优势,可能正在受到越来越大的挑战。Anthropic IPO 路演材料中的一张幻灯片显示,随着高性能 AI 模型逐渐具备自主适配不同计算平台的能力,GPU 正在变得越来越像可以相互替换的通用算力资源。IT之家注意到,Anthropic 的 IPO 路演材

    来源 腾讯网
  5. Muse Spark Open megakernel:Blackwell单请求解码破1109 tok/s

    本文详解SGLang为何转向megakernel架构,并介绍为Muse Spark Open从零用CUDA C++与PTX构建的megakernel实现。该方案将Blackwell GPU上的单请求解码速度从517 tok/s提升至1109 tok/s,性能提升2.1倍。通过单层单核、12个warp分工、权重全缓存预取

    来源 AI 科技快讯
  6. 平头哥分拆赴港上市:估值差数百亿美元,难在哪

    出品 | 智械岛作者 | 霍如筠(北京)2018年,马云从一堆候选名字里拍板,给阿里新成立的芯片公司取名平头哥,这是蜜獾的诨名,体型不大,但敢跟狮子叫板,被称作世界上最无所畏惧的动物,以生死看淡、不服就干闻名。阿里想借这个名字传达的意思很简单,芯片行业竞争激烈,但我们不怕。八年过去,这只“蜜獾”终于走到资本市场门口。2

    来源 腾讯网
  7. Helix完成620万美元融资:用本地语音识别替代CAPTCHA

    AI初创公司 Helix 宣布完成620万美元融资,由 Chicago Ventures 领投,BAM Ventures、Aglaé Ventures、Corazon Capital 等机构参与投资。公司计划利用可在用户设备本地运行的语音识别技术,替代或补充传统 CAPTCHA 验证码,在不收集敏感个人信息的情况下判断

    来源 AI 开发者社区
  8. 联发科确认ISHO iFlow搭载Genio 420:9999元起,端侧AI助睡眠

    IT之家 11 月 11 日消息,今天(11 日)晚间,@联发科技官方微博 发文宣布,MediaTek 赋能 ISHO 今日宜休发布 AI 睡眠科技生态产品 ——ISHO iFlow 智能温控系统和 Pro 版本,两款产品均采用 MediaTek Genio 420 平台,并搭载芯发科技(ZelusTek)自主开发的

    来源 AI 行业观察
  9. 苏姿丰给AMD准备了另一把“增长密钥”

    11月初,AMD交出了一份亮眼的三季报,其中数据中心业务单季收入85.46亿美元,同比增长97%,营收占比达到64%。AMD正式进入“数据中心时间”。 支撑AMD“数据中心时间”的两个关键业务线,是Instinct系列GPU和EPYC处理器。 AMD 董事会主席及首席执行官苏姿丰博士在业绩声明中说,Instinct系列

    来源 AI 行业观察
  10. Fractile拿下7.2亿美元融资:英国AI芯片新秀能否突围英伟达

    英国AI芯片初创公司Fractile完成7.2亿美元融资,跻身专用AI芯片赛道资金最充足的公司之一。TechCrunch指出,这笔资金将加剧其与英伟达生态及云厂商自研芯片的竞争。面对资本密集、软件生态和客户验证三重门槛,Fractile能否把融资优势转化为产品与商业化优势,成为英国半导体复兴的关键观察样本。

    来源 AI 科技快讯
  11. AI交易逻辑轮动:GPU租赁价格还能撑多久?

    中期选举后数据中心建设面临监管与审批收紧风险,但GPU租赁价格上涨有望弥补资本开支缩减的损失。这一机制将推动AI投资逻辑发生结构性轮动:具备丰富存量算力的超大规模云厂商将重获定价权与溢价;而依赖算力扩建的AI实验室、新兴云服务商及数据中心产业链则面临承压。 数据中心的政治逆风正在重塑AI投资逻辑,但这场交易的生死,最终

    来源 AI 行业观察
  12. 台积电10亿美元投OpenAI与Anthropic:AI循环融资再添样本?

    全球最大芯片代工厂台积电据悉将向Anthropic与OpenAI投资约10亿美元,成为AI热潮中“循环融资”的最新案例。在AI交易出现动摇迹象之际,这笔投资既凸显台积电对AI算力长期需求的押注,也引发外界对AI资本闭环与泡沫风险的关注。

    来源 AI 科技快讯
  13. Nothing首款AI设备曝光:无屏设计,红色按键可语音交互

    裴宇在 X 平台晒出 Nothing 首款 AI 设备外观,绿红 LED 指示灯配实体按键,科幻感十足。他强调上下文不应局限于聊天框,暗示采用无屏幕设计,按键或为 AI 语音交互入口。##Nothing AI 设备## 该产品预计 12 月正式发布。

    来源 IT之家
  14. AMD高管反问英伟达Arm:芯片研发需数年,智能体CPU说法站得住吗

    AMD企业副总裁Madhu Rangarajan与Zen首席架构师Mike Clark近日质疑英伟达、Arm将新品称为“专为智能体AI设计”的说法。AMD称芯片研发周期长达数年,四年前无法预见智能体AI兴起,并主张智能体工作流负载多样,需由不同类型CPU组成完整产品组合,而非单一专用型号。

    来源 凤凰科技
  15. GPU租赁价格成AI交易关键:数据中心逆风下的算力博弈

    中期选举后数据中心建设面临监管与审批收紧风险,但GPU租赁价格上涨有望弥补资本开支缩减的损失。这一机制将推动AI投资逻辑发生结构性轮动:具备丰富存量算力的超大规模云厂商将重获定价权与溢价;而依赖算力扩建的AI实验室、新兴云服务商及数据中心产业链则面临承压。

    来源 华尔街见闻
  16. 摩尔线程MDC 2026定档12月29—30日:S6000与“庐山”将亮相

    11月11日,国产GPU龙头摩尔线程(688795.SH)正式官宣:2026 MUSA开发者大会(MUSA Developer Conference,简称MDC 2026)将于12月29—30日在北京举行。作为国内首个聚焦全功能GPU的开发者盛会,MDC 2026大会规模全面升级。官方释放的预告显示,多款下一代重磅新品

    来源 腾讯网
  17. 摩根士丹利:半导体被恐慌错杀,算力存储排前两位

    摩根士丹利认为半导体板块近期抛售过度,市场恐慌而非基本面才是最大风险。受AI基础设施需求驱动,下游订单持续加速,半导体供给仍是核心瓶颈,LPS制约反而令增长更平稳。板块短期或区间震荡,当前已接近底部,看好算力和存储板块。

    来源 华尔街见闻
  18. 摩根士丹利:20%美国数据中心项目延至2029,40%芯片难通电

    摩根士丹利最新研究显示,美国中期选举引发的政治阻力正在实质性改变AI数据中心的建设节奏,约20%原定2028年落地的美国新增容量将被推迟至2029年,2026至2028年间在美部署的芯片中约40%面临无法及时通电的风险。 这一判断将对科技供应链、数据中心融资市场及AI整体资本开支周期产生连锁影响。 根据摩根士丹利11月

    来源 AI 行业观察
  19. 平头哥启动港股IPO:阿里拟分拆芯片子公司上市,最高募资234亿港元

    11 月 10 日晚间,阿里巴巴的一纸公告,把科技圈和资本市场的目光拉到了港交所。 在港交所披露的公告中,阿里巴巴正式宣布,拟分拆全资芯片子公司平头哥在香港联交所主板独立上市。实际上,平头哥早在两个月前的 9 月 11 日,就已经以保密形式向港交所递交了 A1 上市申请表。路透社等媒体披露的信息显示,平头哥计划募资 2

    来源 AI 行业观察
  20. Synaptics发函叫停Vino开源驱动,索赔2.5万美元并称每7天加价

    一个个人爱好者的小项目,被芯片巨头的律师函逼到了墙角。Synaptics 近日向开发"Vino"驱动的开源爱好者洛锡安发出停止侵权函,要求他停掉、撤下并销毁这套为 DisplayLink 设备提供开源支持的 Linux 驱动——而他写代码时,还请了 Claude AI 当帮手。 逆向出来的开源替代,动了谁的奶酪 Dis

    来源 AI 开发者社区
  21. 德州仪器推TICS100MOD工业通信模块,2026年底供货

    11月5日,德州仪器(TI)宣布推出TICS100MOD多协议工业通信系统级模块(System-on-Module,SoM),支持EtherCAT、PROFINET和EtherNet/IP三种工业以太网协议,预计于2026年底供货。SoM通常将处理器、存储器、电源管理以及必要的外围电路集成到一块小型PCB上,客户通过设

    来源 腾讯网
  22. Fractile获7.2亿美元融资:AI芯片赛道再添资金玩家

    英国AI芯片初创公司Fractile完成7.2亿美元融资,跻身专用AI芯片赛道资金最充足的公司之一。TechCrunch指出,这笔资金将加剧其与英伟达生态及云厂商自研芯片的竞争。面对资本密集、软件生态和客户验证三重门槛,Fractile能否把融资优势转化为产品与商业化优势,成为英国半导体复兴的关键观察样本。

    来源 AI 行业观察
  23. 英伟达Rubin Ultra CPO需求测算:单Pod光学价值540万美元

    英伟达下一代AI芯片架构所催生的共封装光学(CPO)需求,正推动光学通信行业进入一个规模远超当前预期的新增长周期。据追风交易台消息,据伯恩斯坦分析师Daniel Zhu在最新研报中测算,基于Coherent披露的每100 Tbps芯片对应1.5万美元内容价值这一数据,一个8机架Rubin Ultra计算集群(Pod)所

    来源 腾讯网
向下滚动自动加载更多