

蚂蚁数科LingDT-Decision首发信息抽取:决策模型能读懂金额日期了
LingDT-Decision是蚂蚁数科推出的新型决策模型,首次在System One协议中集成信息抽取能力,突破传统决策模型仅支持单选/判断的局限,助力产业智能决策升级。
以 Jev 为代表的决策模型,能应付的只有单选、判断这类题型。可产业决策不光是做选择、下判断,还得从上下文里把金额、日期等信息抽出来,再综合判断。这类问题,现有决策模型还接不住。
蚂蚁数科为此在 System One 协议上做了拓展,由决策模型 LingDT-Decision 首发信息抽取能力。按官方说法,该模型借助 mid-train、强化学习等手段,深度适配产业侧对决策精度与效率的双重需求。
从效果看,LingDT-Decision 的信息抽取性能已超过同尺寸乃至更大尺寸的生成式模型,速度上有优势,推理可靠性也有保障。目前该模型已在蚂蚁数科 DTMaaS 平台开放,Slotting 功能可参照 DTMaaS 公开调用示例免费体验。
以 Jev 为例:决策模型的能力边界
客服后台进来一条新工单:
订单 A123 多扣了 199 元,退款等了一周还没到。
系统得判断工单该派给谁。用 Jev 等决策模型处理这条工单,流程大致是:客户原话放进 state,questions 里问「这条工单该交给谁」,给出账单、物流、账号三个选项,然后发起调用:
{"state": "订单 A123 多扣了 199 元,退款等了一周还没到。","questions": {"department": {"type": "choice","instructions": "这条工单最适合交给哪个团队处理?", "criteria": { "billing": "扣款、账单或退款问题", "shipping": "物流、包裹或配送问题", "account": "登录或账号设置问题" } } }}返回的响应如下,概率和置信度均为示意值。
{"answers": {"department": {"type": "choice","choice": "billing","probabilities": { "billing": 0.94, "shipping": 0.04, "account": 0.02 },"confidence": 0.91 } }}后台读到 answers.department.choice 为 billing,工单即可送进账单队列。
客服点开工单,先得找出客户说的「199 元」,再与扣款记录核对。问题在于退款金额属于开口的数值类型,想用选择、判断或评分功能把它提取出来并不容易。
从设计上看,System One 模型目前处理这类信息抽取问题还有困难。
LingDT-Decision 针对 System One 模型的这一缺陷,在 System One 协议上加了信息抽取功能,原生支持 extract 题型来做信息抽取。应用指定要找「多扣金额」,模型就会返回对应的原文片段和位置,客服便能在工单里看到「199 元」被划出来。
不同 System One 模型支持的问题类型
从 jev 的开源实现出发:答案究竟怎样被读出来?
不妨想一想:上面 Jev 响应里的三个概率从哪来?拿 Jev 的开源实现 Kev 来看,整个过程可拆成几步:
拼接输入,经基座 Prefill,取特定 Token 的向量,算出目标 token 的概率,再返回结果,如下图所示:

先把请求拼成一条序列
<state>订单 A123 多扣了 199 元,退款等了一周还没到。<instruct>这条工单最适合交给哪个团队处理?<opt>billing: 扣款、账单或退款问题</opt><opt>shipping: 物流、包裹或配送问题</opt><opt>account: 登录或账号设置问题</opt><decide>Prefill 之后,选取特定位置 Token 的向量表示计算
基座模型对编码后的序列做一次前向计算,得到每个 token 位置的隐藏向量。针对 Choice、Score、Noul 问题取三个 和最后一个
从挑选项到找位置:信息抽取如何沿用这套打法
换回前面那个工单场景,问题已经从「该转给哪个部门」变成「多扣了用户多少钱」——前者只在三个预设选项里挑,后者的答案就藏在客户原话里。LingDT-Decision 处理信息抽取走的还是那条老路:拼接输入、基座 Prefill、取特定 Token 的向量、算出目标 token 的概率,如下图:
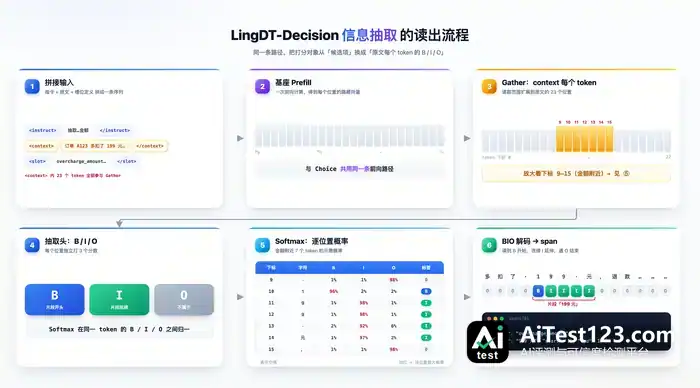
请求拼接方式
如下所示,
<state> 此处放历史上下文信息<instruct>从下面正文中抽取预定义的实体类型<context>订单 A123 多扣了 199 元,退款等了一周还没到。</context><slot>overcharge_amount:这笔订单中多扣的金额,保留原文单位。</slot><decide>需要取哪些位置的 token 向量
Prefill 完成之后,除了
概率的计算方法
抽取头会为原文的每个 token 打三个分数:B 表示片段开头,I 表示片段延续,O 表示不属于这个片段。同一个 token 的 B、I、O 三个分数之间用 softmax 算出标签概率。Choice 是给每个选项分配概率,这里算的则是
LingDT-Decision 的实际表现
整体性能
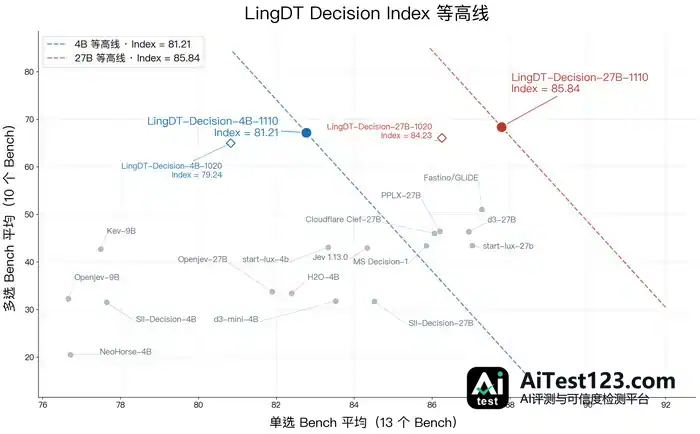
与其他决策模型相比,LingDT-Decision 眼下多出信息抽取和多选两项原生能力,并借助 mid-train、强化学习、OPD 等技术,与企业真实应用场景做了深度对齐。23 项开源评测基准里,该模型的综合评分压过 Microsoft-Decision-1、Jev 1.13 等热门决策模型,27B 版本更是在同参数规模模型中拿下最高准确率。

(图注:LingDT Decision 的 4B/27B 版本优势区间,覆盖 Jev、MS Decision、GLiDE 等相关尺寸决策模型,综合性价比突出)
信息抽取表现
评测挑了信息抽取领域 10 个典型 bench,结果表明 LingDT-Decision 的整体性能已超过同尺寸乃至更大尺寸的生成式模型,速度上也占优,推理可靠性同样有保障。
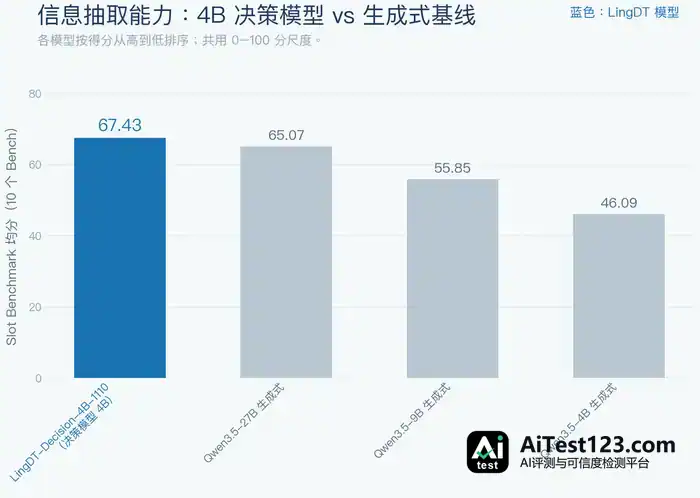
(图注:图中均分为各数据集的 macro F1)
单选与多选表现
23 项主流开源评测基准的测试显示,LingDT-Decision 的 27B 版本综合评分(90%x 单选评分+10%x 多选评分)排在第一,准确率高于 Microsoft-Decision-1、Jev 1.13.0、Fastino/GLiDE 等热门决策模型。
多选任务上,LingDT-Decision 的 4B 和 27B 版本准确率超过 Microsoft-Decision-1、Jev 1.13.0、Star-lux 等 16 个决策模型,原生多选能力在多标签与组合判定任务中的优势由此显现;单选任务上,它处在第一梯队。
上手体验
请求和返回
拿前面提到的工单案例来说,要让 LingDT-Decision 处理抽取任务,按下面这个请求体发过去就行:
{ "state": ".....", "questions": { "overcharge": { "type": "extract", "instructions": "抽取这条工单中多扣的金额。", "criteria": { "overcharge_amount": "这笔订单中多扣的金额,保留原文单位。" }, "context": "订单 A123 多扣了 199 元,退款等了一周还没到。" } }}接口返回的内容长这样:
{ "answers": { "overcharge": { "type": "extract", "spans": [ { "type": "overcharge_amount", "text": "199 元", "start": 12, "end": 17 } ] } }}眼下 LingDT Decision 模型已经在蚂蚁数科 DTMaaS 平台上线,想试 Slotting 功能的话,照着 DTMaaS 的公开调用示例操作,就能免费体验。












