

Gemini 4 Carbon全面开放:API尝鲜价每百万输入2美元
API限时半价。
谷歌今日凌晨宣布,旗下最强AI模型 Gemini 4 Carbon正式向开发者、企业、科研人员以及普通消费者开放。智东西11月11日消息,该模型在网络安全、复杂知识工作、软件工程和科学推理等场景的长程Agent工作流中,均达到前沿水平。
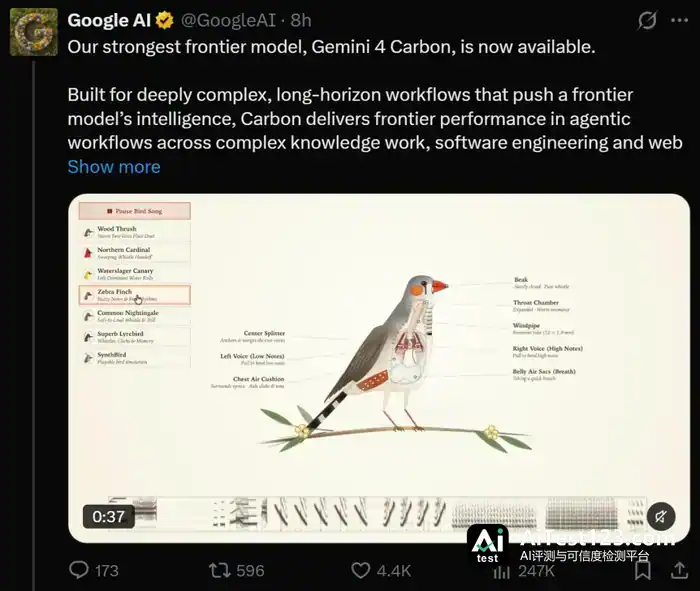
谷歌宣布开放Gemini 4 Carbon(图源:X)
10月28日,也就是两周前,Gemini 4 Carbon首次发布,当时通过Fairwind计划向一批网络安全工作人员开放。如今开放范围扩大,开发者和企业用户可以在Google AI Studio和Gemini for business上调用API;Google AI Ultra订阅用户则能在 Google Antigravity、Gemini应用和谷歌搜索AI模式中体验。
独立基准测试用来衡量模型在实际工作流中的表现,Carbon在这些测试里既保持了前沿准确性,也控制了部署成本。Cursor测评榜单CursorBench 4.0、Perplexity的WANDR和Zapier的AutomationBench中,它都排在第一位,单任务成本不到排名最高的外部模型的一半,表现优于Fable 5.2、Opus 5.5等模型。
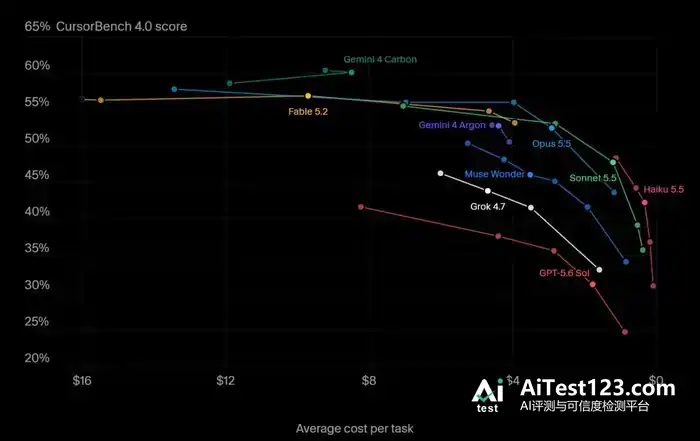
Gemini 4 Carbon在CursorBench 4.0测评中表现(图源:Cursor)
Artificial Analysis Intelligence Index榜单上,Gemini 4 Carbon(high)拿到60分,位列第二,只落后于 Claude Fable 5.2(max),同时超过了Claude opus 5.5(max)、GPT-6 Astra(max)和GPT-6.1 Sol(max)等模型。
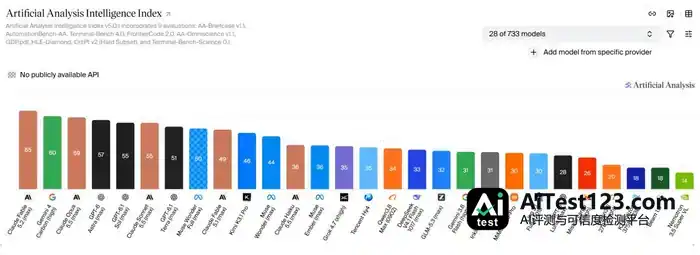
Gemini 4 Carbon在Artificial Analysis榜单上位列第二(图源:Artificial Analysis)
价格上,Gemini 4 Carbon的API尝鲜价与Argon一致:每百万输入Token 2美元(约合人民币13.3元),每百万输出Token 10美元(约合人民币66.7元),优惠到11月30日截止。此后输入、输出价格分别调整为4美元(约合人民币26.7元)和20美元(约合人民币133.4元)。
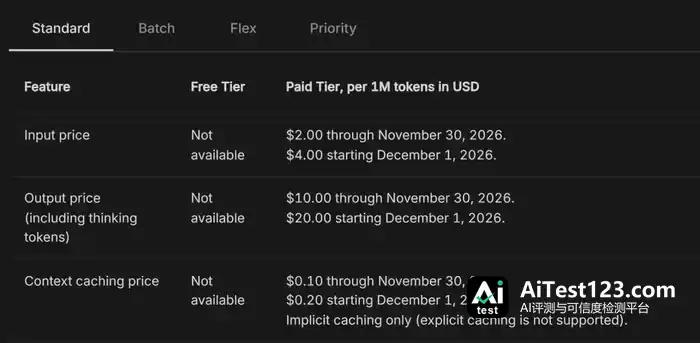
Gemini 4 Carbon价格(图源:谷歌)
在Gemini 4系列里,谷歌目前仍建议大多数软件工程和知识工作任务使用Argon。Carbon针对的是更难的场景,比如复杂代码调试、开放式科学研究,这类任务会消耗更多Token,推理更深,结果也要反复验证。
谷歌首席执行官桑达尔·皮查伊(Sundar Pichai)发文称:“Carbon做了个鹈鹕骑车的Demo,所以你不用专门测试。”动画里,鹈鹕在谷歌园区中骑行,飞跃斜坡后张开翅膀保持平衡,随后平稳落地继续骑行。

模型开放后,一些开发者在海外社交平台X上表示,Gemini 4 Carbon比Argon提升明显,能力很强,思考方式也和Claude、GPT不太一样。

开发者对Gemini 4 Carbon的评价(图源:X)
也有开发者提到,Gemini 4 Carbon相较Gemini以往模型进步较大,但审美比不上Fable和Opus,需要更详细的提示词或参考案例来引导。

开发者对Gemini 4 Carbon的评价(图源:X)
01.多模态知识工作评测排名第二,基于206张工程图复刻谷歌办公楼
法律、金融和企业运营等场景中,Carbon能检索并分析大量文档,把其中的图表、图片和表格结合起来,得出有材料支撑的结论,再按照指定结构和格式生成电子表格、演示文稿或报告。
谷歌与Artificial Analysis合作推出了多模态知识Agent评测(Multimodal Knowledge Agent,MKA),用来考察Agent处理工程蓝图、示意图和数据表等复杂资料的能力。谷歌称,Carbon在这项测试中排名第二,平均单任务成本不到榜首模型的六分之一。
谷歌还展示了Carbon把不同类型资料做成交互应用的例子。其中一组Carbon Agent根据一条提示词,将历史照片和工程图版做成了基于Three.js的3D展览,呈现埃菲尔铁塔从1887年到1889年的建造过程。
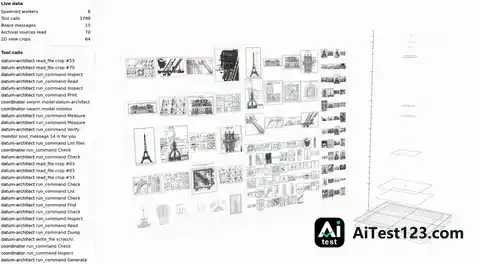
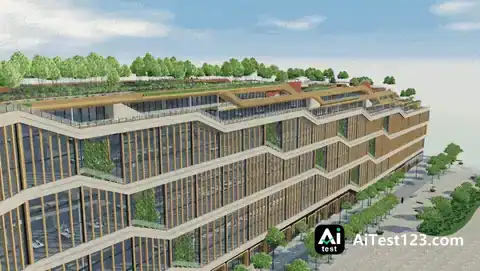
另一项演示中,Carbon团队依据一条提示词和7份市议会公开的规划PDF,提取出206张工程视图,经过一夜10轮迭代,做出了谷歌Platform 37办公楼的交互式3D模型,包含约90.6万个三角面。
02.多Agent协作能力突出,一夜重写OpenCode桌面应用
谷歌称,Carbon擅长需要多Agent协作的工程任务,比如跨软件包迁移、跨子系统排查故障根因和复杂架构重构。开发网页应用时,它会反复构建、运行和验证,遇到错误后尝试恢复,并检查源代码和页面的实际渲染效果。
OpenCode团队曾在下班前交给Carbon一份需求清单,希望桌面应用与现有界面框架保持视觉一致。第二天,Carbon已经从零构建了一个Rust界面库,重写OpenCode桌面应用,并交付了可运行的演示。HubX则在包含1.4万项测试的代码库中,用16项真实Bug修复任务测试Carbon,结果修复率为94%,测试中未出现回归。
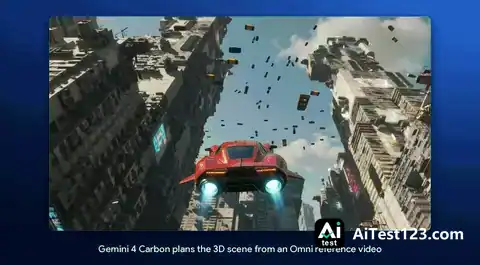
谷歌展示的案例中,Carbon以Gemini Omni生成的视频为参考,在Blender中构建程序化遗迹、水下焦散光照和水体仿真,再把水下亚特兰蒂斯场景移植到Three.js,在浏览器中实时渲染,生成可交互3D游戏。
03.漏洞发现、利用与修复评测均领先,谷歌内部扫描测试召回率100%
Gemini 4 Carbon的安全能力是谷歌至今最强的,能帮安全团队从发现到修复全程保护关键软件。按照Fairwind计划,Carbon在漏洞发现(EC-bench Pro)、漏洞利用(ExploitGym)、漏洞修复(CWE-bench v1)这三项关键评测中排在前列。
谷歌让Carbon跑了一遍内部自动化安全项目Project Fortify,这个项目涵盖扫描、分诊、修复三个环节。按谷歌自己的评测,Carbon的扫描召回率到了100%,分诊精确率到了95%。在开源代码库上测试时,它发现漏洞的召回率比Argon高出25%以上,还揪出了以前漏掉的逻辑漏洞。
谷歌旗下网络安全公司Wiz有个“Scan for Good”项目,团队用Carbon去评估公共数字基础设施的安全状况。谷歌说,Wiz检查两家大型SaaS服务商时,不到两小时就找出了此前不掌握的漏洞,之后和受影响机构一起修复,潜在波及范围达到数万家公司。
04.参与验证Signal协议代码,科研免费计划扩至Carbon
谷歌表示,Carbon在物理、数学、生命科学推理上都有进步,能用来汇总实验数据、验证假设、处理多步骤问题。药物毒性研究公司Axiom Bio评价说,Carbon在其转化科学任务里表现最好,帮团队找到了过去没发现的毒性机制。这家公司正在把实际科研用的分析流程和Agent迁到Carbon与Argon上。
在谷歌内部,研究人员已经拿Carbon做代码形式化验证、酶检测方法开发和蛋白质结构预测。
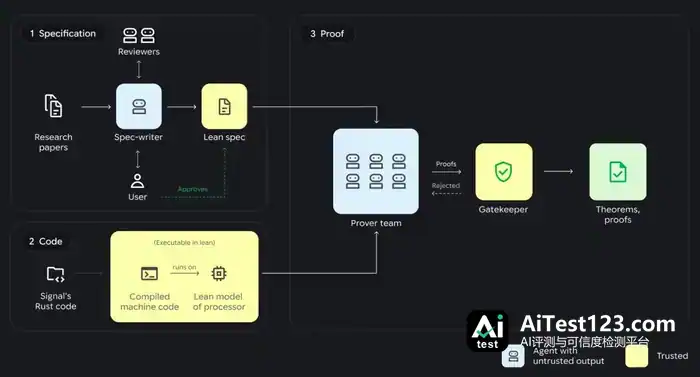
代码验证这块,研究人员搭了个叫AlphaProof Code的Agent框架,对Signal加密协议的真实代码做数学验证。他们用Carbon和其他模型把安全目标转写成数学定理,Carbon产出了超过600万行经Lean自动检查的证明代码,原本专家要花几年的验证工作被压到几周,约1%的代码库仍需人工审查。
酶检测方法开发这块,Carbon从实验记录和原始数据里找出了难以解释的异常,帮研究人员定位到深孔板自动混合不充分、仪器里残留微量样品等问题,并改进了色谱峰解析方法。谷歌称,这些改动让实验结果更容易复现,也加快了新检测方法的开发进度。
蛋白质结构预测这块,AlphaFold 3等模型靠多序列比对,用进化上相关的蛋白质序列推断折叠结构。数据库里已知同源序列少的蛋白质,预测模型能用的信息也就少。谷歌说,在CASP17盲测集的7个低同源蛋白质家族中,Carbon帮忙检索到的同源序列数量平均变成原来的40倍,结构预测模型不用重新训练就能多出可用信息。范围更大的评估还在进行。
大约四周前,谷歌启动了一项面向1万名科学家的免费计划,给6个月的Google Antigravity使用权限,目前已有数千名科学家加入。这次开放之后,已有和新加入的参与者都能用上Carbon和Argon。谷歌会按资格、容量和筛选结果每周分批放行,并打算在新一代前沿模型上线后继续给参与者提供访问权限。
05.结语:Carbon正式开放,复杂任务进入实战检验
一夜重写桌面应用,再到参与验证Signal协议的机器代码,谷歌演示了Gemini 4 Carbon怎样在一项任务里反复调用工具、核对结果、修正方案。
Carbon上线后,谷歌给Gemini 4系列分了更清楚的角色:Argon负责大多数日常开发和知识工作,Carbon则投入更多推理Token去啃需要多轮验证的难题。Carbon正式开放后,任务耗时、Token消耗量、交付前还要多少人工复核,都会成为用户挑模型时的考量。












