

Gemini 4 Carbon全量开放:650万行证明与四周验证
模型的价值正在从回答问题,延伸到承担复杂工作。
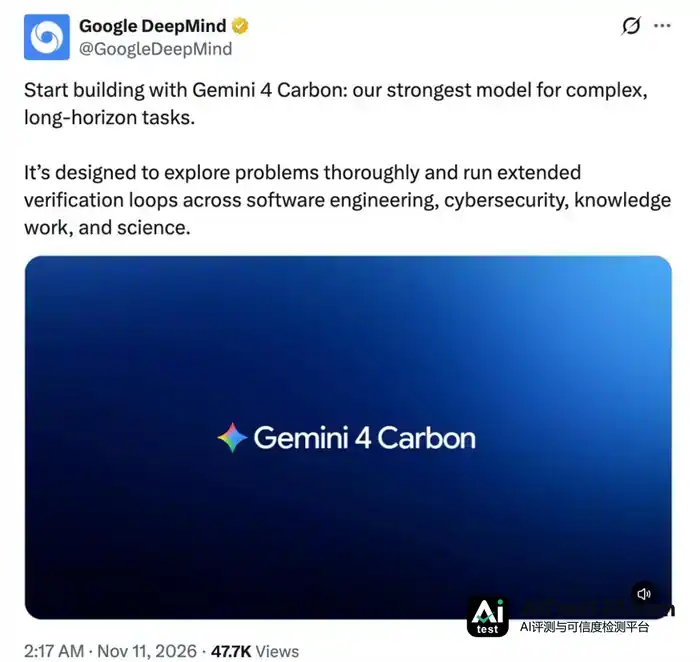
Google DeepMind 宣布, Gemini 4 Carbon 于今天正式开放,并称其为「Google 目前能力最强的模型」。该模型面向复杂、长周期任务,能投入更多推理资源深入探索问题,并在持续执行、检查和修正中完成软件工程、网络安全、知识工作和科学研究中的复杂任务。
和此前的 Gemini 4 Argon 比起来, Carbon 的定位更清楚:它并不急于抛出一个答案,而是肯花更多时间与算力,把一件复杂的事真正做完。
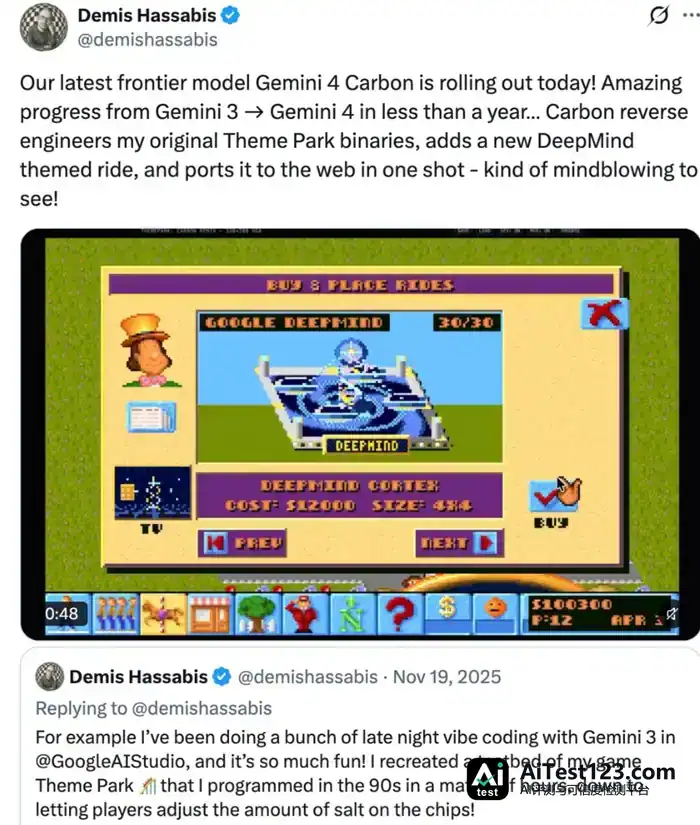
Demis Hassabis 举了一个直观例子:「Carbon 对我最初开发的《Theme Park》游戏二进制文件进行了逆向工程,在游戏中新增了一项以 DeepMind 为主题的游乐设施,并一次性将整个游戏移植到了 Web 端。」
他还附上了去年同一时期用 Gemini 3 做的视频作对比,并感叹:「不到一年的时间,Gemini 就从 3 进化到 4,进步实在惊人……亲眼看到这一切,真的有种不可思议的感觉!」
如今这种能力已向全球用户开放。官方表示,从今天起,Gemini 4 Carbon 将经以下渠道提供:
- 消费者:Google AI Ultra 订阅用户可在 Gemini App 以及 Google 搜索的 AI Mode 中使用。
- 开发者与企业:可通过 Google AI Studio 和 Android Studio 中的 API 开发;Google AI Ultra 订阅用户还能经
 Google Antigravity 使用,企业用户则可通过 Gemini for Business 使用。
- 科学家与研究人员:可在 Google Antigravity 提交申请,有机会拿到为期 6 个月的免费使用资格。
- 网络安全防御人员:可申请加入 Fairwind 计划,获取 Carbon 在网络安全领域的使用权限。
为展示该模型处理科研复杂任务的能力,模型正式发布后不久,Google DeepMind 又公布了一项名为 AlphaProof Code 的研究:研究人员用 Gemini 4 Carbon 驱动的 AI Agent 对 Signal 加密协议的底层代码做了形式化验证,最终产出超过 650 万行经机器检查的数学证明代码。

这项工作原本可能要专家团队花上数年,结果只用了四周。
更关键的是,它意味着 AI 正从「写出代码」迈向「用数学证明代码是安全的」。
从长周期推理,到真正完成复杂工作
按 Google 的说法,Gemini 4 Carbon 是目前最适合处理高难度、多步骤任务的模型。
软件工程里,它能应对复杂代码库,做跨模块问题排查、架构调整和多轮调试;科研中,它能围绕开放问题不断提出假设、分析证据并验证结果;知识工作里,它也能处理大量复杂文档、数据和结构化信息。
支撑这些的是一项重要设计:Extended Verification Loops(扩展验证循环)。
遇到复杂任务,Carbon 会投入更多 Thinking Tokens,尝试不同解决路径,并在执行中反复核对结果。一旦发现问题,它会接着修改、测试,直到结果更可靠。
Google 公布的独立工作流基准测试显示,Carbon 在 CursorBench 4.0、Perplexity WANDR 和 Zapier AutomationBench 上均排第一。Google 还称,这些测试中其单项任务成本比表现最好的下一款外部模型低两倍以上。
同时,Google 正在 Google Antigravity 中预览 /swarm 功能:用户只给一个任务,就能让多个 Agent 组成协作团队,分头承担架构设计、任务协调、代码实现和审查等工作。
其中,Carbon 负责最需要深度推理的环节,其他更轻量的模型并行处理具体任务。
从模型能力到多 Agent 协作,Google 想让 AI 接手的工作更复杂,也更贴近真实的专业工作流程。
650 万行数学证明,AI Agent 给 Signal 做了一次「安全体检」
如果说 Gemini 4 Carbon 展示的是能力上限,那 AlphaProof Code 就是一次很具体的能力验证。
软件安全领域有个老难题一直没解决:怎么证明一套真实跑着的软件,确实符合设计者要求的安全属性?
Signal 就是个例子。这套加密通信协议用得很广,安全性靠的是一整套复杂的密码学机制。密码学专家过去能做的是从数学上分析协议设计安不安全,再通过代码审查和测试去找漏洞。
可中间始终横着一道沟:协议在理论上安全,不等于最终跑在用户设备上的代码也安全。从协议设计到实际运行,还得经过代码实现、编译和优化,一个很小的实现错误,就可能让原本严密的安全设计失效。
传统的形式化验证想用数学证明来填这道沟——把软件该满足的安全条件写成严格的数学命题,再证明实际代码确实满足。问题是这活儿极其复杂,往往要专家砸进去大量时间。
Google DeepMind 这次推出的 AlphaProof Code,就是想靠 AI Agent 把这门槛降下来。
研究团队先和模型配合,把 Signal 的安全目标转成 Lean 语言能理解的数学规格,由人类专家逐条审核。之后,Gemini 4 Carbon 驱动的多个 Agent 开始自动构造证明,试着证明实际代码满足这些安全要求。
关键在于,研究没有停在协议设计或源代码层面,而是一路扎到最终编译后的设备代码。研究人员建立了 AArch64 指令集的形式化语义,把编译后的机器码也纳入验证范围。也就是说,他们要证明的是真正跑在设备上的代码,而不只是理论上的算法描述。
AlphaProof Code 最终为 Signal 的核心实现生成了约650 万行 Lean 证明代码,底下垫着约 2.6 万行经过审核的形式化规格和机器码语义。
整个验证过程只花了四周。AI Agent 还会自动标出需要人类进一步检查的部分,最后只有约 1% 的代码库需要额外人工关注,其余证明都交给 Lean 的可信内核做机器检查。
这套系统也不是只会给正确代码生成证明。研究团队故意把两个过去真实存在、后来已经修复的漏洞重新植进隔离版本的 Signal 代码,结果 AlphaProof Code 都成功生成了机器检查通过的反例证明,识别出这些代码不满足原先的安全要求。这说明它不光能验证正确实现,也能识别特定的错误实现。
AI 编程的下一步,是让代码变得可信?
这项研究的意义,远不止帮 Signal 做了一次安全验证。形式化验证一直是软件工程里成本最高的安全保障手段之一,即便是非常重要的系统,想证明其代码满足严格的安全属性,也往往要专家团队耗上数年。
如今,这些繁重活儿里有很大一部分交到了 AI Agent 手上:先写形式化规格,再摸索证明路径、产出 Lean 代码,最后交给独立的证明内核把关。
当然,这不代表 AI 已经能独立证明任何软件绝对安全。人类专家仍然要定义和审核安全规格,证明系统也只能保证代码满足已经明确表达出来的属性。
但这条路线已经展示出一种新的可能:当 Agent 能持续推理、调用工具、构造复杂中间结果,并通过外部验证机制反复检查,AI 就有机会承担过去要专家团队长期完成的工作。
Google DeepMind 还提到,往后打算把这项技术推向医疗设备固件、电网软件这类关键基础设施,同时接入自动化漏洞修复工具 CodeMender,让软件在漏洞发现、问题修复和形式化验证之间串起更完整的安全链条。
从 Gemini 4 Carbon 的发布,到 AlphaProof Code 对 Signal 的验证,Google 展示的是同一个方向:模型的价值正在从回答问题,延伸到承担复杂工作。
AI 如今不只是会写代码,还能帮人用数学证明代码确实满足了安全要求。Agent 能做的事,边界也被推到了另一个领域。
大模型不再只盯着打榜比分,而是去啃更复杂的数学和密码难题,你怎么看?评论区聊聊。
参考链接:
https://x.com/GoogleDeepMind/status/2120219371473617099
https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available/?utm_source=x&utm_medium=social&utm_campaign=&utm_content=
https://x.com/sundarpichai/status/2120207062655549933
https://deepmind.google/blog/introducing-alphaproof-code/












