

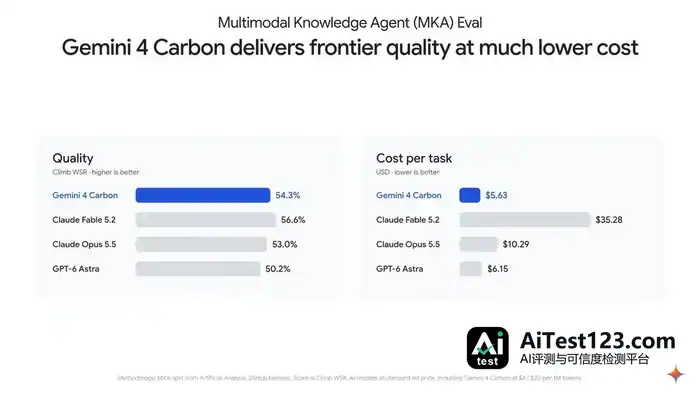
Gemini 4 Carbon:MKA基准测试第2,任务成本仅第1名1/6
IT之家 11 月 11 日消息,当地时间 11 月 10 日,谷歌宣布联合 AI 模型评测机构 Artificial Analysis 推出多模态知识智能体基准测试 MKA(Multimodal Knowledge Agent),用于评估 AI 智能体处理视觉复杂文件、完成现实世界知识工作任务的能力。 谷歌表示,其最
当地时间 11 月 10 日,谷歌与 AI 模型评测机构 Artificial Analysis 共同发布多模态知识智能体基准测试 MKA(Multimodal Knowledge Agent),瞄准的是 AI 智能体处理视觉复杂文件、完成现实世界知识工作任务的能力。谷歌方面称,自家最新发布的  Gemini 4 Carbon 在参测模型中质量排名第二,平均每个任务的完成成本大约只有第一名模型的六分之一。

谷歌 DeepMind 高级产品经理 Rohan Doshi 与首席工程师 Ben Caine 表示,眼下不少知识工作基准测试只靠文本就能做完,可现实里的活儿往往夹杂大量视觉信息:建筑师要对着建筑蓝图来回核对,工程师得分析工程示意图,专业人员还得把不同来源的材料汇总成演示文稿、报告和电子表格。
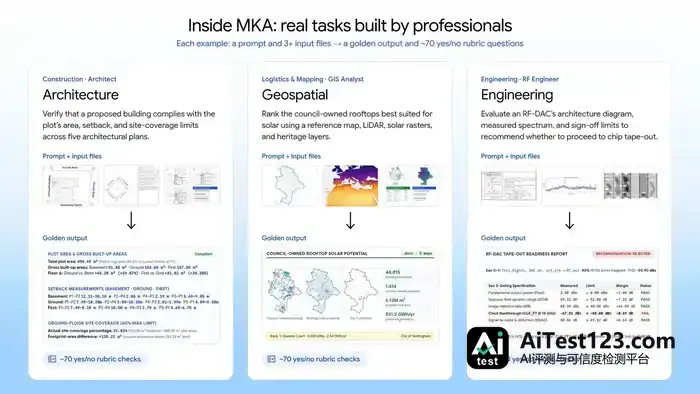
据谷歌介绍,MKA 基准测试正是为衡量 AI 智能体在这些复杂工作场景中的表现而设。谷歌与来自 10 个行业、83 种职业的领域专家合作,搭起一个包含 200 项任务的评测集,覆盖商业、建筑、教育、工程、金融、医疗、法律与政府、物流与地图、科学以及软件与数据等领域。每项任务都模拟一个多步骤专业项目,给出真实工作提示词和一组多模态输入文件,谷歌称这类任务通常要经验丰富的专业人员花上 3 至 8 小时才能完成。
专家为每项任务编写了评分标准,平均下来,每套标准里约有 70 个是非判断检查项;权重上,事实准确性占 75%,视觉设计占 25%。

评测机制上,所有参测模型都跑在同一个开源智能体框架 Stirrup 里,所用工具、沙箱环境和交互轮次预算完全一致。最终成果交给一个基于非谷歌模型搭建的智能体评审系统打分,该系统会打开全部文件、渲染页面、检查电子表格公式,再对照专家评分标准逐项核验。谷歌称,领域专家人工评分与自动评审系统的结果一致率达到 96%。
为防止测试题泄露、混进模型训练数据,Artificial Analysis 把 200 项正式评测任务全部设为私有;同时项目在 Hugging Face 上另外公开了 10 项任务,方便开发者了解测试格式、评估自己的智能体。
谷歌公布的测试结果还显示,不同模型完成同一批任务的效率差别明显,平均每项任务消耗的交互轮次落在 30 至 130 轮之间。
目前 MKA 基准测试已通过 Artificial Analysis 开放,开发者可借助该平台评估自己的模型;Gemini 4  Carbon 则已通过 Gemini API 在 Google AI Studio 中提供。













