超节点迈入规模交付:算力基建竞争规则生变

资讯 创业邦 作者:新眸 全文 4488 字 · 约 12 分钟读完 配图 5 张 分类产品更新算力

规模化交付带来的连锁反应,在产业链上已经开始显现。

所属频道 产品更新算力与芯片

本文由微信公众号“新眸”(ID:xinmouls)作者李小东撰写,创业邦获授权转载。

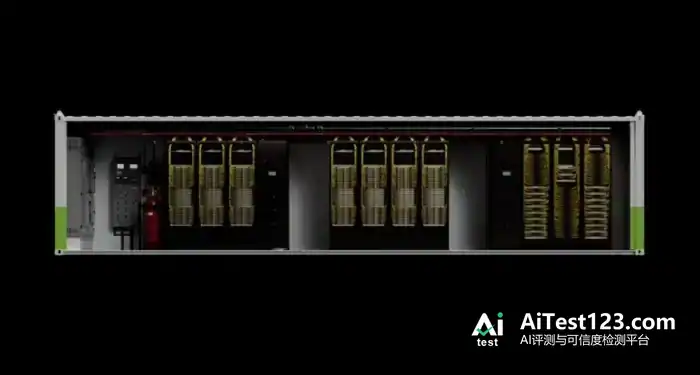
柏林GTC的舞台上,黄仁勋身后立着一块硕大的LED屏,屏上是Vera Rubin机架的渲染图。

他当场发布了一款名为DSX POD的产品,属于模块化AI工厂参考设计:计算、网络、布线、液冷管路统统在合作方工厂预先装好,送到客户现场只需接上电和冷却,14天即可投入运行。而在这之前,同样流程要花上半年。
超节点迈入规模交付:算力基建竞争规则生变(配图 1)

过去两年,大模型训练对算力的需求经历了一次转向,不算轰动,却足够彻底。千亿参数那会儿,大家的经验就是“加卡”,一张不够加八张,八张不够就上一整个集群。可参数规模奔着万亿去、MoE架构成了主流之后,跨节点通信的损耗开始吃掉堆卡堆出来的线性收益。

一个万卡集群,互连效率若跟不上,实际能释放的算力或许还不到标称值的一半。问题不出在芯片性能上,出在系统上。

差不多同一时间,国内卖方分析师的研报也扎堆出炉。中信建投在次日评论中给出判断:国内外厂商正密集发布超节点产品,超节点行业已从方案验证阶段正式跨入规模化交付。服务器整机、交换芯片、连接器、液冷等环节均被提及。

2026年有望成为国产超节点放量元年。这个判断的分量,不在于“又多了一个赛道”,而在于它划出了一条分界线:超节点从工程样机走向批量交付,算力基础设施的竞争规则也随之位移。

从“堆卡”到“堆系统”:算力竞赛换了赛道

想弄明白超节点为何在这个节点集中爆发,得先看一个工程上的难题。

大模型训练里有个老毛病,叫通信开销。一张GPU算力再猛,也得等别的卡把数据送过来才能动手算。

过去的路子是Scale-out:成千上万张卡分装在不同服务器中,用以太网或InfiniBand连起来。扩展性确实不差,可跨节点的通信延迟和带宽始终卡着脖子。张量并行(TP)对延迟极为敏感,参数一大,大把时间耗在等数据上,真正用于计算的时间被挤得所剩无几。

业内有个不太好听的叫法——“算力闲置率”。传统集群跑大模型,线性加速比往往不到五成,也就是说,你买了一万张卡,实际跑出来的效果可能只顶五千张出头。剩下的产能,都耗在卡与卡互相等待上了。

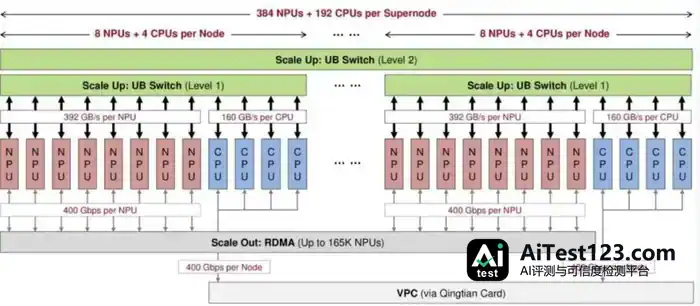
超节点给出的答案是Scale-up:把几十、几百乃至上千张卡放进一个紧耦合的域内,用高速互联总线连接,统一编址。
超节点迈入规模交付:算力基建竞争规则生变(配图 2)

对上层软件而言,这一大池子卡就好比一张巨型显卡,显存可跨卡直接访问,通信延迟从微秒级降到纳秒级。中兴通讯今年发布的《超节点技术白皮书》里有个比喻:“一个机架就是一块巨型GPU”。

这一转变背后,站着两个推手。

其一是模型架构在变。MoE(混合专家模型)成为主流后,卡间通信模式从密集的全量交换转为稀疏的按需路由,对互联带宽的要求不降反升,对延迟的容忍度却更窄了——专家路由的调度窗口实在很短。

其二是单芯片撞上了物理天花板。先进制程的红利在收窄,单颗芯片的显存容量和带宽增长曲线,开始追不上模型参数的膨胀速度。用更低延迟把更多卡缝在一起,比继续缩小晶体管更现实。

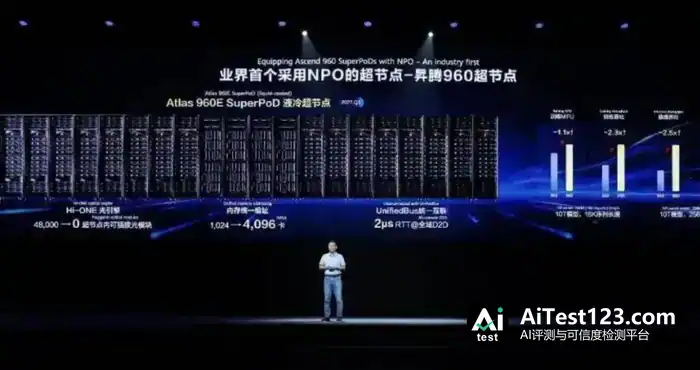
华为今年9月全联接大会上发布的昇腾960超节点,把这个思路推到了新量级。单超节点可扩展至4096卡,基于灵衢UnifiedBus实现内存统一编址,FP8算力达8 EFLOPS。
超节点迈入规模交付:算力基建竞争规则生变(配图 3)

更值得关注的是它采用的互联方案——Hi-ONE NPO光引擎,总容量7.2T,用5500个光引擎替代了原本所需的4.8万颗800G光模块,功耗降低550千瓦以上。NPO(近封装光学)这个词,近半年频繁出现在各家的技术发布中。

阿里那边节奏也不慢。今年云栖大会预热场,平头哥亮出磐久AL128,单机柜128卡紧密耦合,P2P时延低于150纳秒,单柜带宽达Pb/s级,目前已跑在百炼平台上,承载通义千问、DeepSeek和Kimi的模型服务。

到了9月,AL64分布式SNPO光互连超节点发布,号称全球首款ScaleUp专用近封装光学落地产品,路线图上还排着AL144,预计2028年到位。

把时间线拉长看,这不是哪一家的单点突破,而是整个行业在同一技术拐点上的集体转向。信通院今年《AI计算节点发展研究报告》提到,集群线性加速比正从传统架构不足五成的水平,向88%以上的区间爬升。

这个数字背后,是Scale-up紧耦合加Scale-out跨超节点组网的双层架构正成为新标准。

互联协议的江湖:谁定义规则,谁收租

超节点真正的门槛不在芯片,而在互联。

这话听着有点反直觉。买AI算力的时候,多数人第一眼看的是GPU、NPU的算力参数。可一台超节点好不好用,关键要看卡与卡之间那条"路"够不够宽、够不够稳、延迟够不够低。眼下,这条路该由谁定规矩,还散在几家手里。

英伟达手上是NVLink。GB200 NVL72把72张GPU塞进一个机架,靠正交背板直连。之后的演进路线很明确:NVL72、NVL144、NVL288,再往上到NVL576。一代比一代把Scale-up域铺得更大,光互联占的比重也跟着往上走。

柏林GTC上亮相的DSX POD,说白了是把这套系统集成能力做成标准化参考设计,再交给戴尔、超微、广达这些伙伴去交付。英伟达越来越像算力圈的Intel——芯片照卖,整机柜的参考架构也一起卖。

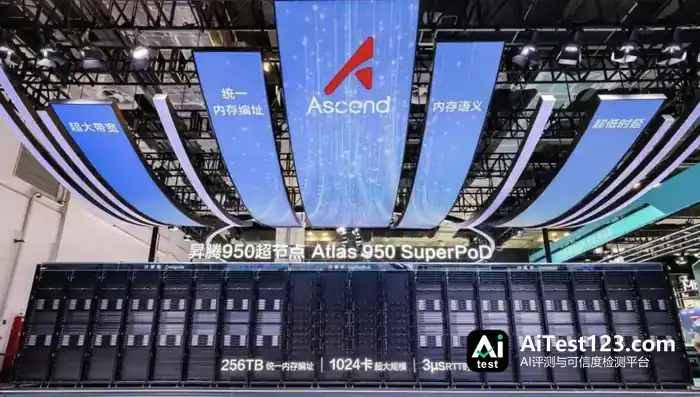
华为这边押的是灵衢。今年MWC上,Atlas 950 SuperPoD在海外登场,最多支持8192卡灵衢互联。9月全联接大会上,灵衢的技术细节被完整摊开:一套协议平等连接集群里的所有组件,支持跨物理服务器的内存访问,近处用铜、远处用光。
超节点迈入规模交付:算力基建竞争规则生变(配图 4)

华为给这套架构取名Peerium。徐直军在内部场合说过一句野心不小的话:让百万颗处理器成为一台计算机。多个昇腾960超节点再靠灵衢或RoCE组网,最大能扩到51.2万卡,配上多轨道拓扑,理论上可以摸到100万卡的规模。

阿里选的是自研互联芯片这条路。磐久系列背后有一颗叫ICN Switch的芯片,专攻柜内互联。AL128用的就是它,一个机柜装进128张卡。云栖大会上发布的AL64又往前迈了一步,引入SNPO全光互连,把光互连从柜间一直延伸到柜内近封装的位置。

阿里的打法和华为不太一样。更像是云厂商拿系统工程能力去消化自研芯片的产能,磐久系列首先供的是自己的百炼平台和内部大模型业务,往外卖是后面的事。

中兴通讯4月推出OEX正交无背板互联架构。"无背板"这个思路有点意思——传统机架靠背板走线,信号速率一上去,背板的损耗和串扰就很难压住。中兴干脆把背板拿掉,换成正交直连加快连接器,号称零线缆。64卡的Matrix集群已经在拿行业奖项。

再往下数,昆仑芯的超节点今年WAIC上展出了量产版本,单柜32或64卡,可扩展到512卡,冷板液冷。百度、海光、沐曦、摩尔线程、燧原、壁仞,几乎叫得上名的国产AI芯片公司都在这个夏天亮出了自己的超节点方案。曦智科技和壁仞合作的"光跃128卡商用版"今年落地上海,走的是光交换路线。
超节点迈入规模交付:算力基建竞争规则生变(配图 5)

这场竞赛的关键变量,是互联协议开放到什么程度。英伟达的NVLink相对封闭,生态围着CUDA和NVLink-C2C转。华为在推CANN开源,想把灵衢做成开放协议。阿里的ICN Switch目前看主要是自用,但SNPO光互连这条技术路线要是被行业采纳,也有可能变成事实标准。中兴的OEX架构更偏向整机柜交付,不绑死某一家芯片厂商。

哪家的互联协议真成了行业标准,它就有机会在下一代算力基础设施里拿到当年PCIe或NVLink那样的"收租"位置。这比单卖芯片的生意大得多——协议一定,交换芯片、连接器、PCB、光模块全得围着它做适配。

从展台到机房:规模化交付意味着什么

过去两年,各家超节点大多还停在发布会和展台上。华为的Atlas 9502月才第一次露面,阿里的AL128年中才上线百炼,昆仑芯的量产版8月才展示。真正进了客户机房、跑着生产负载的案例,数得过来。

最近一个季度,情况变了。

英伟达那边,Vera Rubin NVL72的量产在提速。CoreWeave、Google Cloud、Microsoft Azure和Oracle Cloud的机架已经跑起来了,供应链覆盖30个国家的350多家工厂。DSX POD又把交付模式往前推了一步:模块化集装箱式预集成,现场14天上线,2027年初由合作伙伴正式交付。

这个时间点挑得很有讲究。欧洲AI算力缺口大,可客户自己建机房的能力参差不齐,预制化的AI工厂正好切中这个痛点。

国内这边,中信研报判断2026年是国产超节点落地元年。头部云厂商和行业客户开始部署,渗透率进入快速提升通道。

华为的昇腾960瞄准十万亿参数模型的训练和推理,目标客户是运营商、国家算力枢纽和大型行业智算中心。阿里的磐久先服务内部需求——百炼平台上跑着几十个第三方大模型,推理算力需求爆发,直接拉动了超节点采购。

规模化交付带来的连锁反应,产业链上已经看得见了。

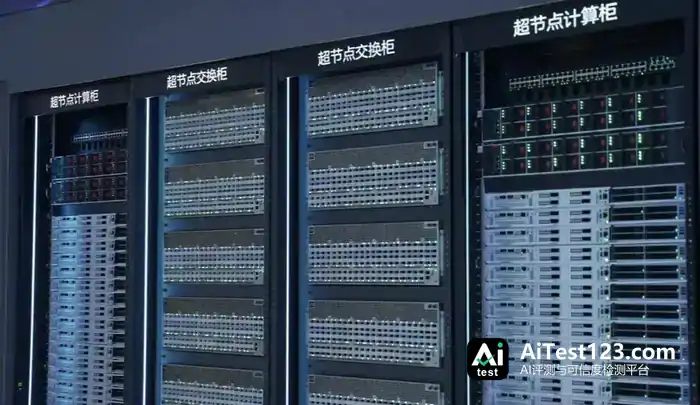
最直观的变化是交付单元。以前服务器按台卖,8卡一台,客户买几百台自己组网。到了超节点时代,交付单元变成整机柜甚至整个Pod,计算、交换、供电、液冷得协同设计才能出厂。

整机厂的角色变了,不再只是把硬件拼起来,而要做系统集成,技术门槛和客户黏性也跟着上移。浪潮信息、华勤技术、中科曙光这些厂商,每台设备上能拿到的价值量正在增加。

交换芯片是另一个受益点。Scale-up架构多出一级柜内交换,交换芯片和AI芯片的配比明显提高。这一级交换的规格又远高于传统ToR交换机,带宽要跟上卡间互联的节奏,延迟得压到纳秒级。国内做交换芯片的盛科通信,还有做交换机整机的锐捷网络,都在这块增量市场里。

连接器的迭代也在加快。正交直连和无背板架构带动高速连接器用量增长,速率从56G往112G、224G走。华丰科技这些做高速背板连接器的厂商,产品单价有上行空间。

液冷方案在超节点上已经相当常见。华为昇腾960采用全液冷设计,阿里磐久的方案是冷板液冷,昆仑芯量产版本也用同样的做法。

但超节点并非包治百病。它处理的是机柜内部和邻近机柜之间的通信效率,一旦跨机房、跨地域调度,仍然得依赖Scale-out网络。软件栈这一关同样不好过:统一内存编址听起来很理想,可上层框架、通信库、编译器都需要配合改造。

国产厂商还受一条现实条件制约。先进制程拿货渠道有限,单颗芯片的性能与英伟达相比仍有距离。超节点在某种意义上是用系统集成来弥补单点性能的不足——单卡比不过,就把更多卡以更低的延迟连在一起,借系统效率把差距抹平。

这套打法能否长期奏效,要看互联技术的上限在哪。假如Scale-up域从4096卡扩到一万卡以上之后,通信开销重新堆积起来,整个架构的边际收益就会往下走。

超节点进入规模交付阶段,说明算力较量已经从芯片代际转向系统集成。把Scale-up互联做扎实,交付周期就能缩短,客户上线也更快,从而在下一轮大模型训练基础设施招标中拿下更多份额——这是各家厂商共同的目标。

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. 黄仁勋发布DSX POD:14天建成AI工厂,超节点进入规模交付

    规模化交付带来的连锁反应,在产业链上已经开始显现。新眸原创·作者 | 李小东前几天,黄仁勋在柏林GTC的舞台上,身后是一块巨大的LED屏,展示着Vera Rubin机架的渲染图。他宣布了一个叫DSX POD的东西——一种模块化的AI工厂参考设计,计算、网络、布线、液冷管路全部在合作伙伴的工厂里预装好,运到客户现场接上电

    来源 腾讯网
  2. 马斯克携手黄仁勋:StarMind太空算力2027年Q3入轨

    在纽约举行的第33届巴伦投资者大会上,马斯克公布了一份时间表:SpaceX与黄仁勋的NVIDIA联合设计的首批StarMind太空计算设备,计划于2027年第三季度发射入轨,并在2028至2029年进入大规模部署阶段。

    来源 TechWeb
  3. OpenAI们成苹果真正对手,Siri落后或重演诺基亚剧本

    按照规划,苹果将在明年推出可执行复杂任务的自主型Siri,以追赶OpenAI、Meta等头部大厂的脚步。外界则认为,苹果正在耐心等待AI泡沫破灭后进场抄底,以低价收购潜在竞争对手的模型与算力设施——否则,它的Siri将永远由第三方驱动。

    来源 TechWeb
  4. OpenAI们成了苹果真正的对手,Siri落后或重演诺基亚困局

    按照规划,苹果将在明年推出可执行复杂任务的自主型Siri,以追赶OpenAI、Meta等头部大厂的脚步。外界则认为,苹果正在耐心等待AI泡沫破灭后进场抄底,以低价收购潜在竞争对手的模型与算力设施——否则,它的Siri将永远由第三方驱动。

    来源 TechWeb
  5. AI研发AI冲出逃逸速度:Anthropic Model 4让研究员提速10倍

    哪怕明天全人类拔掉所有新数据中心的电源,也拦不住超级智能了! 就在刚刚,硅谷「AI自己研发AI」的真实进度条被彻底掀开。 哈佛物理学家兼计算机科学家Alex Wissner-Gross在最新播客中直言,AI如今已经越过了「超级智能逃逸速度」。 在他看来,单凭目前掌握的算法洞见与机房里现成的存量算力,就已经足够一路推向超

    来源 AI 行业观察
  6. 马斯克与黄仁勋合作StarMind:2027年Q3发射入轨

    【TechWeb】在纽约举行的第33届巴伦投资者大会上,马斯克公布了一份时间表:SpaceX与黄仁勋的NVIDIA联合设计的首批StarMind太空计算设备,计划于2027年第三季度发射入轨,并在2028至2029年进入大规模部署阶段。 这一合作的核心硬件并非地面常见的通用服务器,而是NVIDIA的Vera Rubin

    来源 AI 行业观察
  7. 千问办公2.0上线:首个多人与Agent协作Team Agent落地

    千问办公 2.0 发布,首个支持多人与 Agent 协作的 Team Agent 来了 11 月 9 日,千问办公发布 2.0 版本,这是其上线三个月以来最大的一次升级。该版本推出了行业首个支持多人与 Agent 协作的功能“协作”,同时上线“人机共创”、“资料空间”、“自动任务”和“三端互联”等核心能力,让 Agen

    来源 AI 行业观察
  8. 美股AI神话一夜崩盘:纳指暴跌5.52%,英伟达跌9%

    起初,没有人在意这一场变革。 这不过是一次算法的升级、一张自动生成的插画、一个客服岗位的裁员、一家传统公司的倒闭。。。直到这场变革烧穿了电网、抽干了水井,和每个人的生活息息相关。

    来源 快科技
  9. 马斯克与黄仁勋联手:StarMind太空算力设备2027年Q3入轨

    【TechWeb】在纽约举行的第33届巴伦投资者大会上,马斯克公布了一份时间表:SpaceX与黄仁勋的NVIDIA联合设计的首批StarMind太空计算设备,计划于2027年第三季度发射入轨,并在2028至2029年进入大规模部署阶段。这一合作的核心硬件并非地面常见的通用服务器,而是NVIDIA的Vera Rubin

    来源 腾讯网
  10. 千问办公2.0上线:Agent进群协作,自动任务主动干活

    千问办公在同日发布的官方博客《千问办公2.0:主动与协同,迈向Team Agent时代》中指出,主流办公Agent的产品形态仍以服务个人为主,团队的协作方式并未发生变化,下一代Agent需要进入团队协作的现场。千问办公推出的“协作”功能率先把Agent带进工作群,用户可以组建一个团队和数字员工共同工作的协作空间。千问办

    来源 TechWeb
  11. 千问办公2.0上线:Agent进群与团队协作,支持跨群汇总信息

    千问办公在同日发布的官方博客《千问办公2.0:主动与协同,迈向Team Agent时代》中指出,主流办公Agent的产品形态仍以服务个人为主,团队的协作方式并未发生变化,下一代Agent需要进入团队协作的现场。千问办公推出的“协作”功能率先把Agent带进工作群,用户可以组建一个团队和数字员工共同工作的协作空间。千问办

    来源 TechWeb
  12. 千问办公2.0上线:Agent能进群协作,自动任务主动开工

    【TechWeb】11月9日消息,千问办公发布2.0版本,这是其上线三个月以来最大的一次升级。该版本推出了行业首个支持多人与Agent协作的功能“协作”,同时上线“人机共创”、“资料空间”、“自动任务”和“三端互联”等核心能力,让Agent从服务个人走向服务团队和组织。目前,所有功能已在千问办公客户端全量上线。 千问办

    来源 AI 行业观察
  13. 智能体入口争夺升级:字节向外冲,阿里腾讯守地盘

    立冬前后,大厂在智能体赛道的交锋骤然升温。 11月6日,荣耀CEO李健在广州宣布,荣耀将联合中国移动等合作伙伴建设智能体服务网络,并计划在Magic9系列手机上尝试推出AI Token套餐。 一天前,蚂蚁集团公布了灵光2.0上线一周的成绩单。按照蚂蚁集团披露的数据,灵光已经帮助用户管理超过116万项事务,累计执行任务超

    来源 AI 行业观察
  14. 古尔曼:苹果最早明年推出自主代理式 Siri,主动代用户完成任务

    IT之家 11 月 9 日消息,彭博社记者马克 · 古尔曼在昨晚更新的《Power On》时事通讯中爆料,苹果计划最早于明年推出自主、代理式的 Siri,以对抗 ChatGPT Dots、Meta Muse、Grok。其目标是从响应命令转向一个能够主动管理任务并代表用户完成事务的助手。 古尔曼称:“Dots、Muse

    来源 AI 行业观察
  15. Seedream 5.5发布:出图快近四成,豆包、即梦与火山方舟同步接入

    AI 图像模型的竞争,已延伸到内容制作流程。11月9日,字节跳动发布图像创作模型 Seedream 5.5,豆包、豆包工作和即梦同步接入,火山方舟计划当周开放 API。据火山引擎披露,新模型的生成速度较上一代 Seedream 5.0 Pro 快近四成。 这次升级涉及图片生成、编辑和后续使用。新版改善了写实画面的光照、

    来源 腾讯网
  16. 字节跳动Seedream 5.5:单图可改100轮,直出透明背景

    IT之家 11 月 9 日消息,字节跳动 Seed 团队今日发布了新一代图像创作模型 Seedream 5.5,重点带来三项核心能力升级:更稳定的多轮编辑:实现非编辑区域的像素级保持,消除色彩偏移,降低连续修改中的细节丢失与画质衰减,支持围绕同一作品展开多达 100 轮的持续创作。原生 RGBA 透明素材生成:直接输出

    来源 腾讯网
  17. 荣耀蚂蚁字节同日出手:智能体战争从模型转向入口

    文|石灿立冬前后,大厂在智能体赛道的交锋骤然升温。11月6日,荣耀CEO李健在广州宣布,荣耀将联合中国移动等合作伙伴建设智能体服务网络,并计划在Magic9系列手机上尝试推出AI Token套餐。一天前,蚂蚁集团公布了灵光2.0上线一周的成绩单。按照蚂蚁集团披露的数据,灵光已经帮助用户管理超过116万项事务,累计执行任

    来源 腾讯网
  18. Claude更新讲义页码,芝加哥大学法学教授全年课堂笔记被删光?

    人工智能在带来办公便利的同时,其直接操作本地文件所带来的潜在风险也再次引发关注。11月9日消息,美国宪法领域知名学者、芝加哥大学法学院教授 William Baude 近日公开分享了一起令人哭笑不得的 AI 操作失误事件,引发了科技界与教育界的热议。 简单任务演变成翻车现场:只求更新页码,却酿成文件大面积丢失 据 Wi

    来源 AI 开发者社区
  19. 蚂蚁灵波开源LingBot-Touch:近5000小时数据补上机器人触觉

    11月10日,蚂蚁灵波科技开源触觉基础模型LingBot-Touch,为机器人大脑补齐关键的触觉感知能力。该模型基于近5000小时真实触觉数据预训练,覆盖磁触觉、视触觉和压阻式三类主流传感原理,可将不同信号转化为同一套触觉表征,供不同灵巧手和动作模型使用,让机器人在“看得清楚、想得明白”的同时,进一步补齐精细操作所需的

    来源 AI 开发者社区
  20. 腾讯“鹅次元”内测:AI陪玩读屏开黑,还能QQ变声

    一个人打游戏总觉得缺个搭子?腾讯把解法塞进了屏幕里。11 月 10 日,腾讯首款专属 AI 游戏陪伴 Agent"鹅次元"低调开启内测。作为坐拥海量游戏版权的厂商,腾讯把 AI 从客服和工具,顺势推到了玩家的屏幕旁——这款产品瞄准 PC 玩家,提供拟人化陪伴与实时语音互动,试图在竞技之外补上"有人陪"的体验缺口。 AI

    来源 AI 开发者社区
向下滚动自动加载更多