LLM能否挖出真问题:破译学术品味,跳出文献孤岛?
他们不仅构建了融合5800万篇论文演进脉络的科学创意系统SciMuse,更展开了一场前所未有的实证考验:邀请马克斯·普朗克学会的110位研究组长,对AI生成的4400余个个性化跨学科科研构想进行实名制严格盲审。
人类探索科学的历史里,最难得也最难把握的时刻,常常不是严密的实验验证,而是最初那道思维火花——一个真正有意思的科学设想。提一个好问题,通常比解决一个已有问题更能带动科学范式发生转移。
眼下知识正以前所未有的速度膨胀,全球每年发表的学术论文数以百万计,文献的汪洋把各个学科隔成了一座座孤岛。对一线科学家来说,想跳出固有轨道、在学科交汇处找到颠覆性的灵感,越来越像大海捞针。大语言模型(LLM)等人工智能技术快速推进,于是有了一个颇具野心的设想:AI能不能当科学探索的“缪斯女神”,自己构想出足以启发顶尖学者的前沿课题?
一项研究在2026年11月9日刊登于PNAS,出自德国马克斯·普朗克光学研究所与图宾根大学的研究团队之手。他们搭建了一套能串联5800万篇论文演进脉络的科学创意系统SciMuse,同时开展了一场此前无人做过的实证检验:让马克斯·普朗克学会的110位研究组长,对AI生成的4400余个个性化跨学科科研构想逐一实名盲审,标准从严。
这不只是算法工程层面的探索。科学界第一次用这样严密的数据,让AI创造力与人类顶尖学术直觉正面交锋。
从论文海洋中搭一张科学知识地图
要让AI提出靠谱且有深度的科研创意,绝非在对话框里敲一句“请给我一个前沿课题”就行。通用大语言模型很容易给出天马行空却没法落地的空想,或者把人尽皆知的陈词滥调拼在一起。
为了给AI一张坚实且结构化的科学“认知地图”,研究团队先花数年时间构建了一张庞大的科学知识图谱。他们从arXiv、bioRxiv、ChemRxiv和medRxiv等预印本平台的海量文本入手,用自然语言处理算法,配合严格的多轮规则过滤与GPT-3.5辅助清洗,最终沉淀出123,128个核心科学概念。
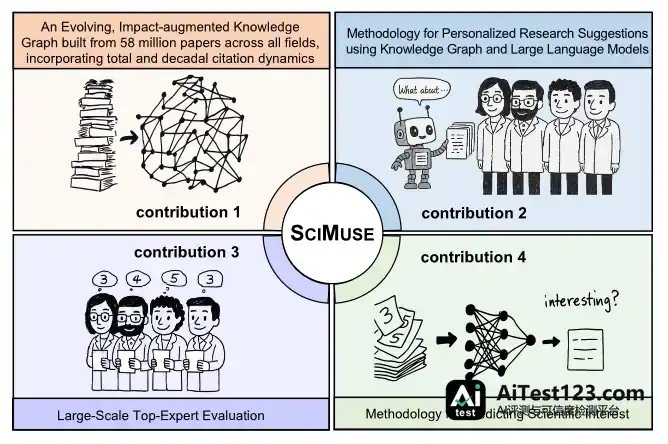
接着,研究团队把这套概念坐标投射到OpenAlex数据库收录的逾9200万篇学术论文中。两个概念只要在同一篇论文的标题或摘要里共同出现,图谱中就建立一条连边。最终建成的动态知识图谱包含超过1.68亿条连边(由15.2亿次共现聚合而成)、涵盖5800万篇论文。这张图谱在时间上跨越了漫长的历史——它的第一条连边,可以追溯到罗伯特·胡克(Robert Hooke)在1666年发表的关于木星和土星观测的天文论文。
全景图谱建成之后,研究团队据此做出了创意生成系统SciMuse。单一学者视角容易带来同质化思维,为绕开这一点,SciMuse的任务被设定成“促成两位科学家的跨界合作项目”。

具体运作上,系统先抓取两位科学家近两年的代表作,在知识图谱中投射出各自的学术子图,再提取出代表两人前沿方向的概念对;随后把这些概念连同学者的研究背景一起输入GPT-4。还有一点很严谨:系统没有采用常规的单次生成,而是引入了一套“自我反思与批判性修正机制”(Self-reflective Critique-and-Revision):
概念阐释:先让模型说清两个核心概念的科学内涵;
跨界结合:构想多个可能的融合研究场景;
自我批判:以严苛同行的眼光,深度审视这种结合到底是“强扭的瓜”,还是具有内在逻辑自洽性的必然融合;
迭代定稿:经过多轮自我反思,最终提炼出严整的研究标题、科学目标与核心科学问题。
让专家评价“有没有趣”
科学想法好不好,很难压缩成一个数字。新颖、重要、可行、独特与有趣这几项彼此牵连,却各有各的含义:有的想法新颖,但不易理解;有的想法重要,看上去却平平无奇;有趣的构想也未必立刻能动手做。论文把“兴趣”看作一种早期信号——想法能否勾起专家的好奇,让他们愿意再想一想、聊一聊。至于专家是否一定立项、投入资源,或认定该课题最重要,它并不代表。
评价环节请来的是马克斯·普朗克学会的研究团队负责人。267位受邀者里,110位交回了调查,分布在54个研究所;参与者以自然科学领域为主,人文与社会科学的研究者偏少。每人拿到48条个性化研究建议,分别对应上述三种生成条件,在不知道潜在合作者是谁的前提下,按1至5分给“有趣程度”打分。研究最终回收4,451份有效评分,约占可获评分数的84.3%。
结果:有些选题的确令人眼前一亮
第一,科学趣味的“二八定律”
评分满分为5分,专家打出的平均分是2.40分,出现最多的分数为1分,占36.7%。一线科学家的挑剔与严谨,在这里看得很清楚——顶级学术殿堂里,平庸的建议激不起任何涟漪。
不过也有让人振奋的一面:有24.9%的AI构想拿到4分或5分的高分评价(其中394个提案斩获5分满分)。也就是说,AI抛出的想法里,每四次出手就有一次能切实触动顶级学者的科研神经。
第二,预测引用率与“有趣”竟然脱节
对照实验设了三种生成条件:基于图谱预测的高被引概念对、图谱随机概念对,以及只给论著标题、不提供概念的纯GPT基线。统计结果出现了一个颇带哲学意味的反转:按预测高被引概念生成的项目,平均趣味得分2.35,没能赢过纯文本基线的2.41,还以微弱的统计学趋势(1.94σ)低于随机概念对的2.45。
更深入的图谱特征关联分析把原因挖了出来:传统科学计量学里,概念的节点度越高、PageRank排名越靠前、历史引用量越大,算法越容易判定它未来会“高被引”。可放到真实的科研心理中,这些特征往往指向已被过度开采的“学术热点”或陈旧套路。
在普通人看来是热点的方向,先锋科学家反倒觉得没意思。概念在知识图谱上的节点度、中心度,跟专家给出的趣味性打分都呈明显负相关。这背后是一个挺实在的道理:搞科研是要往没人去过的海域闯,而不是守着一口已经探明的油田一遍遍往下钻。
第三件事,AI和人类精英比,到底谁更强?
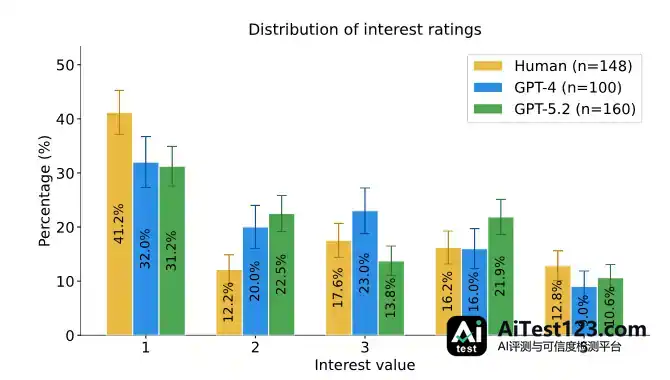
为了把评价的标尺校准,团队还设计了一项基准测试:请来7位资深物理学博士生,在严格限定的10分钟、断网、没有任何辅助的条件下,依据同样的材料,为6位PI写出148个合作提案;另一边让GPT-4和更新一代的GPT-5.2写出对应提案,再做双盲评审。
分数出来了:人类博士生的高分率(4-5分)是29.1%,GPT-4是25.0%,GPT-5.2则达到32.5%。从统计上看,当下前沿大模型拿出的构想,质量已经足以和受过顶级学术训练的高年级博士生掰手腕。
拆解“学术品味”:让“有趣”变成可以研究的题目
这项研究里最有开拓性的一点,是把过去被当成玄学、全凭经验和直觉的“科学品味”,变成了能量化、能建模、能预测的数学对象。既然知识图谱的拓扑特征和专家的趣味打分之间存在内在联系,那机器能不能提前判断哪个Idea会戳中人类的心?团队为此铺了两条预测路线:
第一条走图谱特征加有监督神经网络:完全不输入任何文本,只挑出25个图谱拓扑特征,训练一个精简的前馈神经网络,用来预测高兴趣度(4-5分)。蒙特卡洛交叉验证中,这个网络的ROC-AUC为63.20%;推荐系统最看重的Top-5精准率上,它做到49.20%,明显高过随机筛选。
第二条走大模型的零样本(Zero-shot)排序:不给任何人类标注的先验数据,直接让GPT-4o做成千上万次两两对抗的Prompt提示,再用类似国际象棋的ELO积分系统让提案自己排位。结果很出人意料:分类任务里GPT-4o的ROC-AUC达到67.44%,Top-5精准率也有45.76%。
也就是说,机器不光能“写出”构想,还在学着像学术评审委员会那样,对科研创意做“品鉴”和“分流”。这种能自己筛的能力,为将来在大规模搜索空间里自主挑出高价值科学假设铺了路。
结语
心理学和科学学里,“有趣”是一种认知情绪,它卡在“熟悉”和“不可思议”中间。研究里有个很关键的发现:合作学者之间的语义距离,跟专家的兴趣评分呈明显负相关。换句话说,两个学科隔得太远时,AI硬凑出来的创意表面上新颖度很高,可因为缺少跨学科的知识接口、实验上也做不出来,最后往往成了不着边际的空想。
所以,真正有生命力的科学创意,总是落在“惊喜到足以颠覆认知”和“落地到足以付诸实践”这个精妙的平衡点上。到头来,AI不会替代科学家;但会用AI把认知边界往外推的科学家,或许能先推开未知世界的那扇门。
参考文献
Gu, X., & Krenn, M. (2026). Generating interesting scientific ideas using knowledge graphs and LLMs: Evaluations with 100 research group leaders. Proceedings of the National Academy of Sciences, 123(46), e2611349123.