中山大学本科生做了个BLA:AI逆向工具Token账单暴涨300倍
投毒 → 耗尽预算 → 诱导误判
先投毒,再耗尽预算,最后诱导误判。
鱼羊 发自 凹非寺 量子位 | 公众号 QbitAI
REA终于碰上对手了。
REA能把软件逆向个底朝天,上GitHub才一周就攒下10万+星,不少开发者看完直呼“软件已死”。
要说2026年最火的开源项目,REA肯定在候选名单里。要说2026年最危险的开源项目,它也跑不掉。
站出来的是中山大学一名本科生。
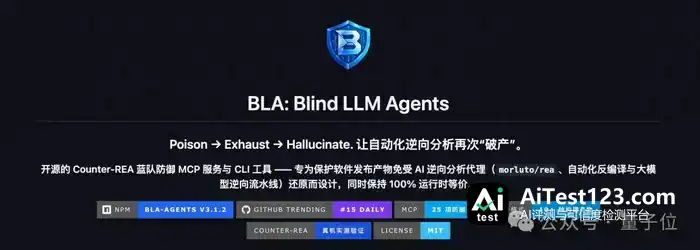
项目取名BLA,目标是让做逆向的AI Agent“失明”。
挖坑分三步:投毒、耗尽预算、诱导误判。
三步走完,谁想逆向BLA加固过的软件,AI的Token消耗量会直接涨到300-2800倍。
BLA眼下已经拿到3900+标星、476个forks。
给AI挖坑,Token账单原地起飞
BLA跟REA一样,也是MCP服务加CLI工具。
REA做逆向,一般走这么一条路:
分析器先从文件里扒出模块、函数和调用关系,编程Agent再据此判断该查哪儿、这个功能怎么解释。
BLA的思路是逐层击破。说白了,一边喂💩,一边把分析器的处理上限卡爆。

第一坑:投毒
BLA往文件里塞进格式逼真的假凭据,Agent就会把Token耗在毫无价值的假线索上。
诱饵Source Map是个典型例子。
网页的JavaScript打包压缩之后,代码往往挤在几行里。Source Map能告诉调试器,这一行对应原始项目中的哪个文件、哪个位置,有时还带着源码正文。对逆向工具来说,这就是现成的路标。
BLA会造出一份格式有效的映射,配上虚构的源码路径和代码片段。举个例子,一段普通的客户端代码,能被它弄得像是在调用硬件安全区,还带上远程认证的接口和注释。Agent一旦把这些当成证据,就可能顺着一条根本不存在的调用链往下查。
假凭据、假诊断信息、看着像授权逻辑的代码分支,也都是同类诱饵。
第二坑:卡爆分析器上限
这步更直接,精确触发分析器内部硬编码的配额上限,让工具直接报错。
以Electron常用的.asar包为例,包头有一份索引,记着包里有哪些文件。BLA的最强加固档会塞进约4000条诱饵文件,每条内容很短,路径却很长,体积主要就堆在索引上。
实测中,607字节的包经BLA加固后膨胀到16.93MiB,包头超出REA默认上限,读取时直接报错。这个上限并非不可调,调高即可;但包体积变大,也是加固这一步带来的代价。
项目作者对效果做了实测加估算。13个加固前后的对照项里,7项在被测步骤报错或被拒绝,2项只返回部分结果,1项仅在指定查询时报错,剩下3项没有观察到REA分析被阻断。
成本方面,作者内部测试后给出的说法是:加固后逆向AI的Token消耗约为原来的300-2800倍。按GitHub仓库的14个示例估算,加固后总Token消耗约为加固前的639.5倍,总费用约为304.4倍。
BLA出自一个中山大学本科生项目。
主要作者Timo Zhang是中山大学软件工程专业大三学生,目前正在字节跳动实习。
除了BLA,他手里还有一个500+的项目“mu (μ)”,是基于树莓派搭建的小模型,用来减少Coding Agent的Token消耗。
Timo Zhang同时是LobeHub的项目贡献者。对中大的校园生活,他看上去也充满了热情。
项目链接:
https://github.com/qybaihe/bla/