傲腾内存跑Kimi K3:无显卡实现2.8万亿参数、1.5词元/秒

资讯 IT之家 全文 604 字 · 约 2 分钟读完 配图 2 张 分类Kimi月之暗面英特尔存储

网友 u/IndividualSurvival 于 11 月 2 日在 Reddit 社区发帖,分享了一项家庭实验室尝试,在不配备显卡的情况下,使用已停产的英特尔傲腾持久内存,成功运行 2.8 万亿参数的月之暗面 Kimi K3 模型。

所属频道 算力与芯片开源生态国产大模型

11月13日消息,Reddit网友u/IndividualSurvival在11月2日发帖,讲了一次家庭实验室里的尝试:机器上没有显卡,靠已经停产的英特尔傲腾持久内存,把2.8万亿参数的月之暗面Kimi K3模型跑了起来。
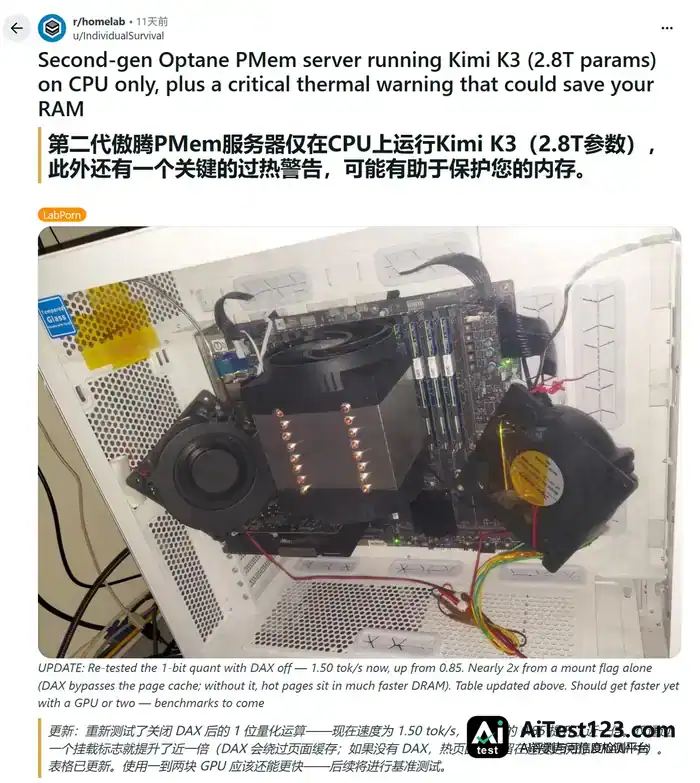
不用显卡:玩家靠停产傲腾内存跑通 2.8 万亿参数 Kimi K3 AI 模型,每秒输出 1.5 词元

所谓傲腾(Intel Optane),指的是一套基于3D XPoint的内存与存储产品技术,由英特尔和美光联手开发,属于非易失性存储。这位网友用的是傲腾持久内存200系列。它的外形和安装方式都接近服务器内存条,单条容量有128GB、256GB、512GB三种,面向第三代至强可扩展处理器平台设计。

配置上,他选的是一颗40核的第三代英特尔至强可扩展处理器(原文未写明具体规格),搭配傲腾持久内存200系列(原文未写明具体容量),运行在App Direct模式下——这种模式把DRAM和傲腾当作两个独立的数据空间呈现在软件面前。推理则交给llama.cpp执行。

这终究只是个测试项目,词元(Token)的输出速度谈不上流畅。按报道,模型数据经1比特量化压缩后,初始生成速度大约每秒0.85个词元;关掉直接访问功能DAX、让常用数据走DRAM缓存之后,速度升到每秒1.50个词元。另一项3比特量化测试只跑到每秒0.75个词元,生成5万个词元差不多要18.5小时。

不用显卡:玩家靠停产傲腾内存跑通 2.8 万亿参数 Kimi K3 AI 模型,每秒输出 1.5 词元

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. 豆包工作开放Kimi、GLM等第三方模型,办公Agent竞争加剧

    字节跳动旗下的豆包工作,开始让用户使用更多竞争对手的大模型。11月12日,豆包工作宣布更新模型阵容,在原有豆包2.1 Lite和Pro两款自研模型之外,正式接入Kimi K3.1 Pro、GLM 5.3、DeepSeek V4.1 Flash等第三方模型。这次更新还伴随着一轮价格调整。豆包工作将在模型选择页面标注不同模

    来源 腾讯网
  2. 豆包工作上线Kimi 3.1 Pro等模型:限时额度优惠怎么用?

    为满足用户根据不同任务自主选择模型的需求,11月12日,豆包工作正式接入 Kimi 3.1 Pro、GLM 5.3、DeepSeek V4.1 Flash 等多款第三方模型,并推出限时特惠计划。在简单小额任务免费的基础上,豆包工作将推出全新限时优惠活动。此外,豆包工作已针对豆包 2.1 Lite和Deepseek V4

    来源 TechWeb
  3. 豆包工作接入Kimi 3.1 Pro等模型:新增额度倍率标注,推出限时优惠

    为满足用户根据不同任务自主选择模型的需求,11月12日,豆包工作正式接入 Kimi 3.1 Pro、GLM 5.3、DeepSeek V4.1 Flash 等多款第三方模型,并推出限时特惠计划。在简单小额任务免费的基础上,豆包工作将推出全新限时优惠活动。此外,豆包工作已针对豆包 2.1 Lite和Deepseek V4

    来源 TechWeb
  4. 豆包工作开放Kimi、GLM、DeepSeek接入:限时倍率优惠上线

    豆包工作正式向个人用户开放第三方大模型选择,包括Kimi 3.1 Pro、GLM 5.3等。平台更新了额度消耗倍率显示,帮助用户直观对比成本。同时推出限时特惠,针对豆包2.1 Lite和DeepSeek V4.1 Flash下调消耗倍率,并在特定时段提供额外优惠,旨在让用户根据任务难度灵活平衡效果与成本。

    来源 AI 应用前沿
  5. DeepSeek-V4等6款模型:Blackwell指纹涉12000块GPU

    2026年11月12日发布的法证报告显示,DeepSeek-V4、Kimi K3等六款中国模型权重初始化痕迹指向NVIDIA Blackwell GPU,涉及约12000块算力资源。此前同实验室旧版模型均匹配Hopper特征。报道从权重可验证硬件痕迹出发,拆解取证机制,分析对评测透明度与管控交叉领域的影响,并给出战略层

    来源 AI 科技快讯
  6. 六款国产AI模型现Blackwell硬件痕迹:约12000块受管制GPU

    2026年11月12日发布的法证报告显示,DeepSeek-V4、Kimi K3等六款中国模型权重初始化痕迹指向NVIDIA Blackwell GPU,涉及约12000块算力资源。此前同实验室旧版模型均匹配Hopper特征。报道从权重可验证硬件痕迹出发,拆解取证机制,分析对评测透明度与管控交叉领域的影响,并给出战略层

    来源 AI 行业观察
  7. 月之暗面徐天天谈AI迭代:三条增长曲线叠加,速度还会加快

    IT之家 11 月 12 日消息,据新浪财经报道,在今日“以发展应变局”为主题的第十七届财新峰会上,月之暗面金融行业与生态负责人徐天天发表讲话。 针对“AI 迭代速度是否还会加快”问题,徐天天表示,当前整个 AI 智能远远未达到上限。 她指出,这背后有三条增长曲线:其一,预训练算力曲线;其二,后训练与推理端曲线,AI

    来源 AI 行业观察
  8. UCIe 4.0规范发布:新增片上存储链路,数据效率93.75%

    IT之家 11 月 13 日消息,UCIe 联盟当地时间 12 日发布了该芯粒互连规范的 4.0 版本。最新的迭代将 UCIe 架构从芯片级接口设计扩展到满足将多个芯片集成到统一的封装系统的关键要求。 UCIe 4.0 引入了标准的片上存储器链路,UCIe.mem 协议简化了 SoC 与存储器逻辑裸片间的集成,实现了高

    来源 AI 行业观察
  9. 月之暗面徐天天:AI能力上限远未到,三条曲线驱动加速

    在人工智能发展速度引发广泛讨论的当下,大模型的能力边界究竟在哪里?在11月12日举行的第十七届财新峰会上,月之暗面金融行业与生态负责人徐天天发表了专业观点,明确指出当前 AI 的能力边界与智能上限还远远没有达到极限,行业整体依然处在加速进化的快车道中。 三条叠加的增长曲线:驱动大模型持续进化的底层逻辑 在主题发言中,徐

    来源 AI 开发者社区
  10. 黄仁勋陷婚外情风波:英伟达股价跌4.27%,身家缩水68亿美元

    福布斯实时富豪榜显示,黄仁勋的个人身家当天缩水68亿美元,降至1554亿美元,全球富豪榜排名也随之下滑至第十位。当然,黄仁勋夫妇目前并未宣布离婚,750亿美元也只是基于公开身家和相关法律作出的假设测算,并非已经发生的财产分割。发言人同时强调,盖茨辞去董事职务与这项调查无关。2019年1月,贝佐斯与结婚25年的妻子麦肯齐

    来源 TechWeb
  11. 黄仁勋邮件承认婚外情:英伟达股价跌4.27%,身家缩水68亿美元

    福布斯实时富豪榜显示,黄仁勋的个人身家当天缩水68亿美元,降至1554亿美元,全球富豪榜排名也随之下滑至第十位。当然,黄仁勋夫妇目前并未宣布离婚,750亿美元也只是基于公开身家和相关法律作出的假设测算,并非已经发生的财产分割。发言人同时强调,盖茨辞去董事职务与这项调查无关。2019年1月,贝佐斯与结婚25年的妻子麦肯齐

    来源 TechWeb
  12. 上一个让CFO接班的芯片巨头,是英特尔

    (本文作者为 好望角,钛媒体经授权发布)文 | 好望角11月12日,英伟达公告,黄仁勋辞去总裁、CEO和董事职务,即刻生效。CFO科莱特·克雷斯出任临时CEO,继续兼任CFO。董事会同时任命哈维·琼斯为公司历史上第一位董事会主席,并启动正式CEO的遴选,内部外部候选人都在考虑范围内。公告没有给出辞职原因。四天前的11月

    来源 腾讯网
  13. UCIe 4.0规范出炉:芯粒互连迈向系统级集成

    IT之家 11 月 13 日消息,UCIe 联盟当地时间 12 日发布了该芯粒互连规范的 4.0 版本。最新的迭代将 UCIe 架构从芯片级接口设计扩展到满足将多个芯片集成到统一的封装系统的关键要求。UCIe 4.0 引入了标准的片上存储器链路,UCIe.mem 协议简化了 SoC 与存储器逻辑裸片间的集成,实现了高达

    来源 腾讯网
  14. 长鑫科技骆晓东:服务器内存需求占比超50%,DRAM供不应求延续

    IT之家 11 月 12 日消息,据中国基金报报道,长鑫科技副总裁骆晓东今日(11 月 12 日)在第八届 IC 企业家大会上发表了题为《算力分层时代探索 DRAM 产品新边界》的主题演讲。 骆晓东指出,算力增长趋势还在持续。据行业预测,2024 年到 2031 年,全球 AI 算力年均增速将达 96.1%;2026

    来源 AI 行业观察
  15. 长鑫科技骆晓东:服务器内存需求占比超50%,AI算力年均增速将达96.1%

    IT之家 11 月 12 日消息,据中国基金报报道,长鑫科技副总裁骆晓东今日(11 月 12 日)在第八届 IC 企业家大会上发表了题为《算力分层时代探索 DRAM 产品新边界》的主题演讲。骆晓东指出,算力增长趋势还在持续。据行业预测,2024 年到 2031 年,全球 AI 算力年均增速将达 96.1%;2026 年

    来源 腾讯网
  16. AI服务器+iPhone Duo双驱动,鸿海Q3净利润大增34%超预期

    财报显示,鸿海三季度净利775亿新台币超预期、营收3.03万亿创纪录;AI服务器成为第一大增长引擎,目标是两年内抢占全球五成份额、把毛利率提升至10%;iPhone Duo销量预计最高达1600万部。鸿海董事长刘扬伟称,存储芯片及零部件短缺问题仍将持续到2027年,上调旗下四大产品类别的业绩预期。

    来源 华尔街见闻
  17. 中芯国际赵海军:Q3收入31.9亿美元,AI配套芯片需求超预期

    中芯国际联合CEO赵海军表示,三季度公司整体销售收入再创新高,达到了31.9亿美元,环比增长6.1%。比起三个月前,我们看到客户对BCD、专用存储、Control等人工智能配套芯片的提拉需求,增量速度比原来预期的更快,使得三季度收入超出指引上限。从量的方面看,公司加快新产线验证,弹性调配已有产能,季度出货量首超300万

    来源 AI 行业观察
  18. 新华三R4930 G7双路服务器发布:192核768线程,IPC提升超15%

    IT之家 11 月 12 日消息,新紫光集团今日宣布,旗下新华三完成 H3C UniServer R4930 G7 服务器核心平台迭代升级。这款自研国产双路旗舰搭载全新一代国产处理器,从计算内核、内存带宽、AI 向量加速到底层 BMC 安全底座全方位跃升。 R4930 G7 单机最高 192 核,支持 768 线程,整

    来源 AI 行业观察
  19. 文艺复兴科技清仓英伟达:减持99.7%,转头加码美光AMD

    最新13F文件显示,量化巨头文艺复兴科技第三季度几乎清仓英伟达(减持99.7%)、Meta(减持99.9%)及苹果、亚马逊等科技巨头,并大幅减持Palantir;同时重金加仓美光科技(增持618.7%)、AMD及闪迪等存储与芯片股。

    来源 华尔街见闻
  20. 长鑫DDR5双线落地:32Gb颗粒量产,MRDIMM冲上12800Mbps

    IT之家 11 月 12 日消息,蓝鲸科技从长鑫方面获悉了其 DDR5 RDIMM、MRDIMM 产品线最新进展。DDR5 颗粒已完成 24Gb 至 32Gb 迭代RDIMM 模组实现 32GB–128GB 主流容量、5600Mbps–8000Mbps 速率全覆盖MRDIMM 则覆盖 128GB、192GB 容量,最高

    来源 腾讯网
  21. 浙大联想联手推EM²Mem:让AI以事件为单位记住长视频

    现在的AI看视频往往只存碎片,问它“谁说要种花”容易答错。浙大和联想团队提出的EM²Mem不再孤立存储画面和文字,而是把人物、动作、时间打包成“事件档案”。这种先对齐再检索的思路,不仅让长视频问答更准,还因为减少了临时拼凑证据的过程,让推理速度提升了近5倍。对于需要长期陪伴的智能体来说,这才是真正能沉淀下来的记忆。

    来源 AI 应用前沿
向下滚动自动加载更多





