新华三R4930 G7双路服务器发布:192核768线程,IPC提升超15%

资讯 AI 行业观察 全文 1097 字 · 约 3 分钟读完 配图 2 张 分类产品更新存储网络

IT之家 11 月 12 日消息,新紫光集团今日宣布,旗下新华三完成 H3C UniServer R4930 G7 服务器核心平台迭代升级。这款自研国产双路旗舰搭载全新一代国产处理器,从计算内核、内存带宽、AI 向量加速到底层 BMC 安全底座全方位跃升。 R4930 G7 单机最高 192 核,支持 768 线程,整

所属频道 产品更新算力与芯片

新紫光集团11月12日对外表示,旗下新华三已完成H3C UniServer R4930 G7服务器核心平台的迭代升级。该产品是自研国产双路旗舰机型,换装全新一代国产处理器,计算内核、内存带宽、AI向量加速以及底层BMC安全底座均较此前有明显提升。
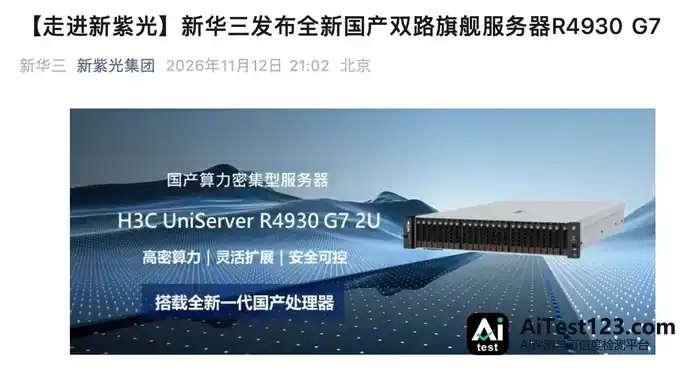
新华三R4930 G7双路服务器发布:192核768线程,IPC提升超15%(配图 1)

单机最高192核、支持768线程,整机计算性能比上代提升幅度很大。其中单线程IPC(每时钟周期指令数)提升超15%,核心规模扩大50%,线程规模则实现翻倍。

在同样的机架和功耗条件下,一台机器能装下的虚拟机、容器或业务实例数量随之增加。按上代单机稳定承载80个中等负载虚拟机计算,新平台可提高到约120个,等于省下了一台服务器的采购费用和机柜占用。

平台原生兼容AVX512指令集,并内置INT8、BF16 AI加速指令,面对大模型推理、向量检索、智能分析等负载时能把算力潜力放出来。通用业务和智能化业务可以在同一平台上混合部署,不必再为AI单独建池,资源闲置和架构复杂度都按下来。
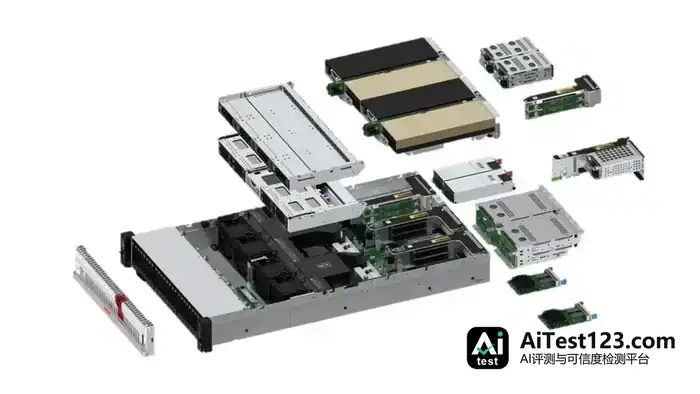
新华三R4930 G7双路服务器发布:192核768线程,IPC提升超15%(配图 2)

整机配有24根DDR5内存,最高速率6400MT/s,内存频率提升33%、带宽提升30%,数据访问时延进一步降低。同等并发下,内存型数据库的数据页交换和缓存刷写等待时间缩短;大模型推理场景里,KV Cache读写瓶颈得到缓解,单机可支撑的并发推理请求数也同步上升。平台还原生支持CXL2.0,为内存池化、异构资源共享留出演进余地,后续架构升级无需整体更换平台。

扩展方面,产品沿用高密度2U形态,可支持10块单宽GPU或4块双宽GPU,PCIe 5.0插槽最多10个;存储最高41块硬盘、300T容量,其中NVMe盘最大28块。按300T裸容量估算,若用于视频解析温数据留存,单路1080P每小时约占2GB,可支撑约15万小时视频在线存储,减少频繁扩盘造成的运维中断。

产品搭载自研国产BMC芯片,叠加100%国产化部件底座,部件国产化率达到100%。整机内置独立安全处理器,支持国密SM3/SM4算法,暴力破解抵御能力有所升级,并搭配可信平台模块提供高级加密支撑。结合CPU内置的可信硬件引擎,内存加密、虚拟机隔离、存储链路加密等多层防护均可落地;全自研BIOS、BMC固件掌握完整知识产权,从底层规避管控风险。

该产品已完成全栈国产软硬件生态认证,兼容国产操作系统、中间件、云平台与主流国产加速组件,业务迁移改造成本更低,适配验证周期和二次开发投入都能减少,可用于政务大模型、金融风控、能源调度、城市视觉分析、企业私有智算等场景。

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. SK海力士HBM4良率突破70%:三星、美光下一代内存竞争升温

    IT之家 11 月 12 日消息,据 Chosun Biz 今日报道,SK 海力士的 HBM4 内存良率已超过 70%,与三星和美光的竞争将更加激烈。 报道称,SK 海力士第六代高带宽内存(HBM4)的产能良率提升至 70% 以上。由于 HBM4 比以往产品更难制造,确保早期产量被视为决定大规模生产竞争力的关键变量。不

    来源 AI 行业观察
  2. 三星联手AMD升级测试系统:引入Zen 6架构EPYC 9006系列

    IT之家 11 月 11 日消息,AMD 今天(11 月 11 日)凌晨发布了霄龙(EPYC)嵌入式 9006 系列 SP7 处理器,基于 Zen 6 架构,最高可达 256 核 512 线程,率先在嵌入式平台落地 PCIe Gen6、CXL3.1,搭配 16 通道 DDR5/MRDIMM 内存、7 年产品生命周期。三

    来源 腾讯网
  3. 谷歌Gemini Decisions API上线:100个问题0.41秒,输出Token不收费

    智东西(公众号:zhidxcom)编译 | 黄菲编辑 | 江宇智东西11月12日消息,今日,谷歌宣布推出Gemini Decisions API,该API可通过同日新发布的模型Gemini Decision 1调用。与传统生成式模型不同,Gemini Decision 1可以直接评估输入内容,并针对最多1000个预设问

    来源 腾讯网
  4. 百度上线词元所:大模型交易平台能否破解落地难题?

    为解决这一落地难题,百度正式推出大模型交易平台词元所。词元所希望汇聚好的模型和模型提供商,让企业乃至个人都能便捷地找到、购买和使用可信的模型Token。向客户提供中立可信、公开透明的模型交易服务。词元所上线一个月以来,入驻供应资源已超100个,日均调用次数突破5000万,日均调用Token超7000亿。

    来源 TechWeb
  5. 百度上线词元所:大模型交易所怎么让Token日均7000亿有处可查?

    为解决这一落地难题,百度正式推出大模型交易平台词元所。词元所希望汇聚好的模型和模型提供商,让企业乃至个人都能便捷地找到、购买和使用可信的模型Token。向客户提供中立可信、公开透明的模型交易服务。词元所上线一个月以来,入驻供应资源已超100个,日均调用次数突破5000万,日均调用Token超7000亿。

    来源 TechWeb
  6. 千问办公2.0上线Team Agent:AI办公转向组织级协作

    11月9日,千问办公办了一场线上发布,推出上线三个月以来最大的2.0版升级。 升级案例来自银泰百货,说过去5名运营要在60多个门店群里逐一收集卡券提报信息,核对后再回填表格;现在门店群和一张AI表格被关联进同一个协作空间,Agent就可以跨群汇总、自动更新表格。 这里面重要的还不是效率,而是Agent干活的方式: 不是

    来源 AI 行业观察
  7. 华为WATCH 5推送HarmonyOS 7 Beta进展:分批升级与2026年公测计划

    IT之家 11 月 11 日消息,华为花粉俱乐部官方团队账号“智能穿戴”今日发布《HUAWEI WATCH 5 系列 HarmonyOS 7 花粉 Beta 版本升级进展通报》。 针对大家反馈的高端精致类、特性体验优化类、系统稳定性等问题,我们已收到,研发团队正在紧急攻关打磨质量,力求为大家呈现更优质的使用体验。 处于

    来源 AI 行业观察
  8. AMD 给服务器内存“减负”,DRAM 需求有望最高降低 75%

    IT之家 11 月 12 日消息,科技媒体 Wccftech 昨日(11 月 11 日)发布博文,报道称 AMD 面向霄龙 EPYC 服务器处理器产品,推出 MEXT 内存解决方案,通过软件协同管理 DRAM 内存与 NVMe 固态硬盘,尝试在降低内存配置成本的同时,维持接近全 DRAM 方案的应用性能。IT之家曾于今

    来源 腾讯网
  9. OpenAI把理财搬上Mac:ChatGPT财务入口可查账户

    OpenAI 今天(11 月 12 日)在 X 平台发布推文,宣布 ChatGPT Finances 功能正式扩展至 Mac 桌面应用。用户更新 ChatGPT 应用后,即可在侧边栏的“财务”入口连接银行、信用卡及投资账户,直接在 macOS 上查看余额、分析消费、管理订阅并跟踪投资组合。

    来源 IT之家
  10. 长鑫科技骆晓东:服务器内存需求占比超50%,AI算力年均增速将达96.1%

    IT之家 11 月 12 日消息,据中国基金报报道,长鑫科技副总裁骆晓东今日(11 月 12 日)在第八届 IC 企业家大会上发表了题为《算力分层时代探索 DRAM 产品新边界》的主题演讲。骆晓东指出,算力增长趋势还在持续。据行业预测,2024 年到 2031 年,全球 AI 算力年均增速将达 96.1%;2026 年

    来源 腾讯网
  11. 智算云需求变了:从租卡问价到按Token算账,市场拼什么?

    智东西(公众号:zhidxcom)作者 | 三北编辑 | 漠影近日,一位智算云企业的工作人员告诉智东西,最近半年,客户的需求点发生了显著变化:过去他们问“一张卡多少钱、能租多久”,现在问题变成了“一百万Token花多少钱、任务能不能稳定跑完”。问题的变化,折射出AI基础设施的一次重要升级。全球AI云市场仍在高速扩张。知

    来源 腾讯网
  12. Adobe MAX 2026:Photoshop 新增加光与去倒影,AI 代理将接管编辑

    AI 不再只是 Photoshop 里的一个按钮,而是要坐到编辑席上。美国当地时间 11 月 10 日的 Adobe MAX 2026 大会上,Adobe 给 Creative Cloud 全家桶甩出一波 AI 更新,从修图到剪辑,再到向第三方智能体敞开接口。 重打光、清倒影,修图更"狠" Photoshop 新推"重

    来源 AI 开发者社区
  13. Netpreme XM-Sparse:外置KV缓存解码TPOT最高缩短63.58%

    XM-Sparse将Netpreme X-Mem™与SGLang HiSparse深度整合,通过高带宽访问外置KV缓存显著降低解码延迟,并借助海量外部容量支持更大批次与更高并发。测试显示,在16K上下文和20% miss率下,X-Mem™相比主机DRAM将每输出token时间缩短49.25%,峰值吞吐提升2.09–3.

    来源 AI 科技快讯
  14. 李彦宏杨元庆对谈:AI替代不了CEO见客户,联想第五个十年怎么走

    【TechWeb】11月12日消息,在百度世界2026开幕式上,百度创始人李彦宏与联想集团董事长兼CEO杨元庆围绕AI时代的企业变革、组织调整、供应链管理以及AI落地边界展开对话。杨元庆在对话中表示,联想正围绕AI时代开启“第五个十年”的第五次创业,用AI变革智能终端、智能基础设施、智能解决方案和服务三大业务;但他同时

    来源 AI 行业观察
  15. 李彦宏:AI下阶段迈向智能组织,未来岗位仅分两类

    【TechWeb】11月12日消息,在今日的百度世界2026开幕式上,百度创始人李彦宏表示,2016年到2026年这十年,正是人工智能技术形成独立技术栈的十年,“芯云模体”四层架构就是在这十年逐步形成的。如果AI技术的上游是能源,那么AI技术的下游,“我认为是组织能力,是一个不同于现在通行的科层制的AI原生组织体系,我

    来源 AI 行业观察
  16. GLM-5.3-Flash在H200上提速:四卡实现48064 tokens/s预填充

    GLM-5.3-Flash融合稀疏注意力、循环线性注意力和MoE架构。在长上下文场景下实现高效服务,需要充足内存支持高并发、低输出token执行成本以及足够的prefill吞吐。本文介绍SGLang在NVIDIA H200上的优化方案,包括混合缓存复用、加速投机执行、针对性内核调优和FP8 prefill通信。实验结果

    来源 AI 科技快讯
  17. MiniMax开源H3-Image图像模型:10秒出4K图,支持16图融合

    智东西11月11日报道,昨天深夜,MiniMax正式发布新一代图像生成模型H3-Image,并同步开放模型权重。 根据不少网友的实测反馈,H3-Image的水准已经能和全球顶级的图像生成模型掰手腕,在开源图像模型中达到SOTA水平。速度方面,H3-Image高速版可以在10秒左右生成一张4096×4096像素(16MP

    来源 AI 行业观察
  18. Anthropic新规2026年11月12日生效:中资控股企业全面禁用Claude

    Anthropic于2026年11月12日起更新政策,禁止中资直接或间接多数控股企业使用Claude.ai、Claude Code及全系API,范围覆盖全球任何注册地。该举措以国家安全为由,关闭此前通过境外子公司规避的漏洞,对依赖其API的中资关联机构形成直接合规压力,也为其他美系AI厂商提供先例参考。

    来源 AI 科技快讯
向下滚动自动加载更多