Netpreme XM-Sparse:外置KV缓存解码TPOT最高缩短63.58%
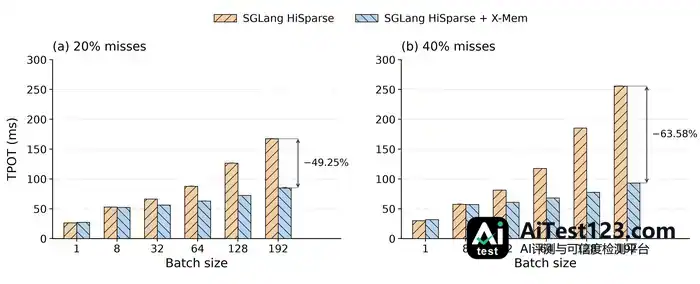
XM-Sparse将Netpreme X-Mem™与SGLang HiSparse深度整合,通过高带宽访问外置KV缓存显著降低解码延迟,并借助海量外部容量支持更大批次与更高并发。测试显示,在16K上下文和20% miss率下,X-Mem™相比主机DRAM将每输出token时间缩短49.25%,峰值吞吐提升2.09–3.
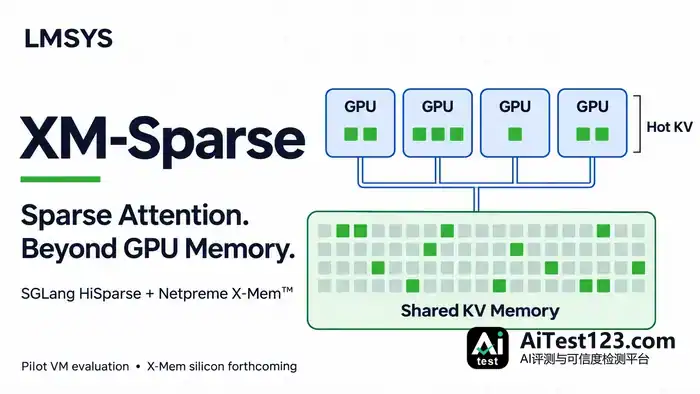
XM-Sparse把Netpreme X-Mem™与SGLang HiSparse做了深度整合。外置KV缓存获得高带宽访问后,解码延迟随之下降;新增的容量则让更大批次、更高并发成为可能。
TL;DR
- X-Mem™给SGLang HiSparse补上了高带宽和海量外部容量。外置KV的访问因此更快,批次规模也能突破主机DRAM的上限。
- 批次不变,解码却更快。16K上下文、20% top-k miss率、每GPU批次192的条件下,X-Mem™把平均每输出token时间(TPOT)压低了49.25%,对比对象是PCIe主机DRAM;miss率升到40%,降幅为63.58%。
- 上下文长度变化时,吞吐同样更高。20% miss率下,16K–1M上下文的解码吞吐达到主机DRAM峰值的2.09–3.04倍。
这些数据来自X-Mem™ Pilot Virtual Machine,目前该平台已开放申请;X-Mem™硅片也即将面市。
稀疏注意力为何离不开快速、高容量的内存层
稀疏注意力在每次解码时只访问选定的KV条目,可选择是动态变化的,完整KV缓存还是得留着。SGLang HiSparse的做法是用热KV缓冲压低外部内存读取,索引键缓存则继续放在GPU HBM里。
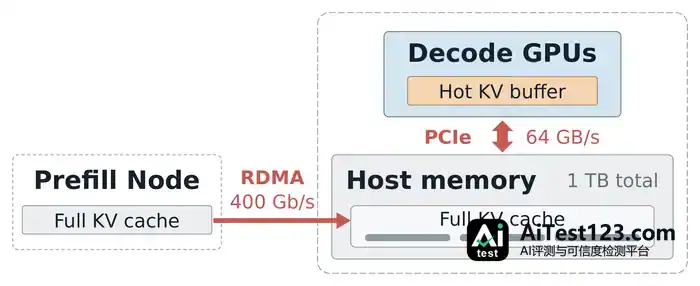
Agentic负载对吞吐的要求更苛刻。编码代理要维持数百个会话,单个会话的KV复用率最高到95%。高并发下能服务多少,直接由解码吞吐决定。
带宽与容量瓶颈的建模
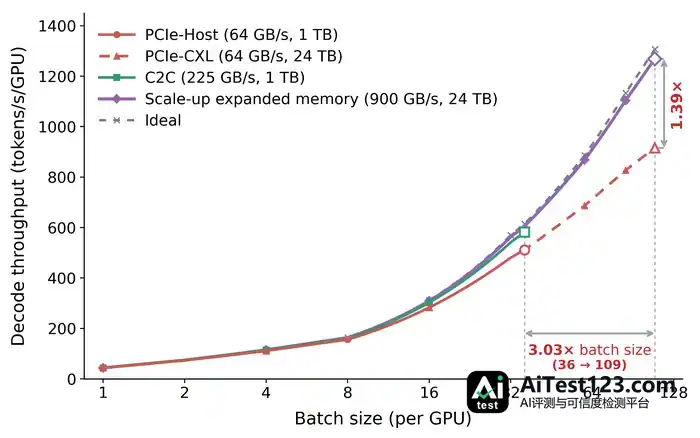
建模比较覆盖四种外部内存配置:PCIe、CXL、NVLink-C2C,以及Scale-up扩展内存。128K上下文时,容量和带宽两头都会卡住性能。24TB容量加900 GB/s带宽,性能提升很明显。
短上下文与长上下文的不同约束
16K和1M上下文,正好分别把带宽与容量推到台前。16K场景带宽是主要瓶颈,900 GB/s能换来1.80倍提升;到了1M,容量成了限制项,24TB配置可把批次从4拉到20。

Netpreme X-Mem™:为SGLang HiSparse准备的高带宽、高容量内存层
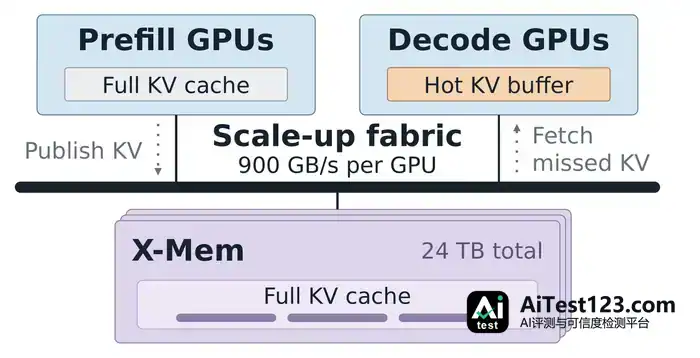
X-Mem™ MPU借助高带宽fabric,在scale-up域内给GPU扩出数十TB内存。单节点可装4个MPU,合计24TB DDR5,聚合带宽约4TB/s。
如何与SGLang HiSparse集成
XM-Sparse沿用了HiSparse的稀疏选择、缓存管理和预取机制,并支持CUDA Graph。KV管理跟着请求生命周期走:发布、获取、写回、释放。
XM-Sparse的测试平台与解码表现
测试在四块NVIDIA B300解码GPU上跑GLM-5.3。20% miss率下,X-Mem™把TPOT明显拉低,峰值吞吐也做到主机DRAM的2倍以上。