Netpreme X-Mem™联调SGLang HiSparse:16K上下文TPOT最多降63.58%

资讯 AI 行业观察 全文 1078 字 · 约 3 分钟读完 配图 7 张 分类DRAM智能体存储

XM-Sparse将Netpreme X-Mem™与SGLang HiSparse深度整合,通过高带宽访问外置KV缓存显著降低解码延迟,并借助海量外部容量支持更大批次与更高并发。测试显示,在16K上下文和20% miss率下,X-Mem™相比主机DRAM将每输出token时间缩短49.25%,峰值吞吐提升2.09–3.

所属频道 算力与芯片智能体与 Agent

XM-Sparse把Netpreme X-Mem™和SGLang HiSparse做了深度整合。外置KV缓存获得高带宽访问,解码延迟因此下降;容量也随之上来,更大批次和更高并发都能撑住。

XM-Sparse: Sparse Attention. Beyond GPU Memory. SGLang HiSparse + Netpreme X-Mem. Pilot VM evaluation; X-Mem silicon forthcoming.

TL;DR

  • 对SGLang HiSparse来说,X-Mem™给的是高带宽和海量外部容量:外置KV访问更快,批次规模也能突破主机DRAM的上限。
  • 批次相同,解码更快。16K上下文、20% top-k miss率、每GPU批次192的条件下,X-Mem™把平均每输出token时间(TPOT)压低了49.25%,对比对象是PCIe主机DRAM;miss率升到40%时,降幅为63.58%。
  • 上下文拉长,吞吐同样更高。20% miss率下,16K–1M上下文范围内,X-Mem™的解码吞吐达到主机DRAM峰值的2.09–3.04倍。

这些数据来自X-Mem™ Pilot Virtual Machine的实测,目前该平台已开放申请,X-Mem™硅片也即将上市。

稀疏注意力为什么需要一层又快又大的内存

稀疏注意力在每次解码时只碰选中的KV条目,可选中哪些条目是动态变的,完整KV缓存还是得留着。SGLang HiSparse的做法是:用热KV缓冲压住外部内存读取,索引键缓存则放在GPU HBM里。

Existing KV cache offloading architecture with full KV caches in host DRAM and hot KV buffers in GPU HBM.

Agentic负载对吞吐的要求更狠。编码代理要同时挂着数百个会话,每个会话的KV复用率最高到95%。高并发下能服务多少,直接由解码吞吐决定。

带宽与容量瓶颈怎么建模

建模对比了解码吞吐在四种外部内存配置下的表现:PCIe、CXL、NVLink-C2C,以及Scale-up扩展内存。128K上下文时,容量和带宽两头都卡。24TB容量加900 GB/s带宽,性能会明显上一个台阶。

Modeled GLM-5.3 decode throughput at 128K context across external-memory bandwidth and capacity configurations.

短上下文和长上下文的差别

16K和1M上下文,分别把带宽约束和容量约束顶到前面。16K时瓶颈主要在带宽,900 GB/s能带来1.80倍提升;到了1M,限制变成容量,24TB配置可以把批次从4拉到20。

Modeled decode throughput at 16K and 1M context, separating bandwidth and external-memory capacity constraints.

Netpreme X-Mem™:给SGLang HiSparse配的高带宽高容量内存层

X-Mem™ MPU借助高带宽 fabric,在scale-up域内给GPU扩出数十TB内存。一个节点可装4个MPU,合计24TB DDR5,聚合带宽约4TB/s。

Prefill and decode GPUs connect to Netpreme X-Mem for shared KV cache storage and selected-KV fetching.

和SGLang HiSparse怎么集成

XM-Sparse保留了HiSparse原有的稀疏选择、缓存管理和预取机制,CUDA Graph也支持。KV管理跟着请求生命周期走:发布、获取、写回、释放。

XM-Sparse的测试平台与解码性能

测试用四块NVIDIA B300解码GPU跑GLM-5.3。20% miss率下,X-Mem™把TPOT明显拉低,峰值吞吐也提到主机DRAM的2倍以上。
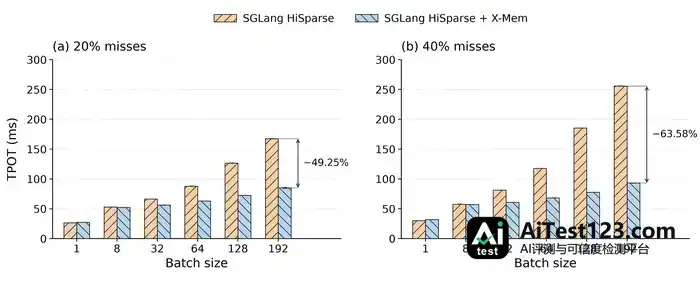
Average time per output token versus per-GPU batch size at 16K context with 20% and 40% KV miss rates.Peak per-GPU decode throughput and batch size across context lengths for host DRAM and SGLang HiSparse with X-Mem.
本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. 便宜得离谱!Meta甩出“最省钱模型”,1/3成本追平Claude Haiku 5.5

    单项任务成本约为Claude Haiku 5.5的三分之一。 编译 | 黄菲 编辑 | 江宇 智东西11月10日消息,今日,Meta正式发布最新模型Muse Ember,主打复杂推理和智能体任务。Meta称,这是其迄今体量最小、效率最高的模型,能够跨应用执行工作流、连续调用工具、运行测试并修复代码。Muse Ember

    来源 AI 开发者社区
  2. GLM-5.3-Flash在H200上提速:四卡实现48064 tokens/s预填充

    GLM-5.3-Flash融合稀疏注意力、循环线性注意力和MoE架构。在长上下文场景下实现高效服务,需要充足内存支持高并发、低输出token执行成本以及足够的prefill吞吐。本文介绍SGLang在NVIDIA H200上的优化方案,包括混合缓存复用、加速投机执行、针对性内核调优和FP8 prefill通信。实验结果

    来源 AI 科技快讯
  3. 红帽AI平台战略:三个C四个A,支持任意加速器与模型

    AI技术快速迭代,模型、算力、云平台和智能体层出不穷。对于企业而言,如何避免被单一技术路线绑定,在保持系统稳定与安全的同时,持续拥抱创新,已经成为一道重要课题。红帽给出的答案是提供一个能够承载过去、现在与未来的稳固平台,把选择权交还给企业。

    来源 TechWeb
  4. 红帽曹衡康谈AI落地:三个C、四个A,把选择权还给企业

    AI技术快速迭代,模型、算力、云平台和智能体层出不穷。对于企业而言,如何避免被单一技术路线绑定,在保持系统稳定与安全的同时,持续拥抱创新,已经成为一道重要课题。红帽给出的答案是提供一个能够承载过去、现在与未来的稳固平台,把选择权交还给企业。

    来源 TechWeb
  5. 三星官宣图库应用支持同步谷歌云存储,此前已结束同微软 OneDrive 合作

    IT之家 11 月 11 日消息,三星电子 (Samsung) 当地时间 10 日宣布,其图库应用 Samsung Gallery 正式支持与 Google(谷歌)云存储的同步集成,用户可在更多位置随时访问保存照片和视频。 三星电子还推出了一项新功能,可将已同步至谷歌云存储的媒体内容从本机删除,释放本地存储空间,同时保

    来源 AI 行业观察
  6. 阿里云第十代ECS:基于AMD第六代EPYC,Agent算力升级

    Agent 正在接手越来越多的工作,一场发生在模型之外的算力升级也悄然开始。 2026 年 9 月,Meta 发布个人 AI 智能体 Muse,仅用了十余天,下载量就突破 250 万,一度登顶美国 App Store 免费榜,并快速霸占全球各大科技热榜头条。但这仅仅是浪潮的起点。9 月底,OpenAI 发布了常驻于 C

    来源 AI 行业观察
  7. aiXcompact-4B开源:4B参数实现上下文压缩,API成本降97%

    智东西(公众号:zhidxcom)作者 | 杨京丽编辑 | 李水青智东西11月11日报道,今日,孵化自北京大学软件工程研究所的AI编程创企硅心科技(aiXcoder)开源上下文压缩专用模型aiXcompact-4B。该模型主要面向编程Agent的长程复杂研发任务场景,参数量仅4B,支持单张A100-40GB显卡私有化部

    来源 腾讯网
  8. Claris测试Harbor:Mac可组集群跑本地AI模型

    IT之家 11 月 11 日消息,苹果全资子公司 Claris 正在测试 Harbor 应用程序。这款 App 可以将苹果芯片的 Mac 变身本地 AI 服务器。据介绍,Harbor 可以运行在单台苹果芯片 Mac,也可以使用雷雳 5 接口连接多台 Mac,运行规模更大的 AI 模型。苹果已在 macOS Tahoe

    来源 腾讯网
  9. Adobe MAX 2026:Photoshop 新增加光与去倒影,AI 代理将接管编辑

    AI 不再只是 Photoshop 里的一个按钮,而是要坐到编辑席上。美国当地时间 11 月 10 日的 Adobe MAX 2026 大会上,Adobe 给 Creative Cloud 全家桶甩出一波 AI 更新,从修图到剪辑,再到向第三方智能体敞开接口。 重打光、清倒影,修图更"狠" Photoshop 新推"重

    来源 AI 开发者社区
  10. 优步、DoorDash财报透露:AI智能体下单仅数百笔

    IT之家 11 月 11 日消息,据《商业内幕》今天(11 日)凌晨报道,外界预测 AI 智能体将彻底改变网络购物方式,但海外两大巨头优步和 DoorDash 在最近的财报电话会议上透露,通过 Meta 的 Muse、Instinct 等 AI 智能体下达的订单仅有数百笔。 相比两家公司每天数以百万计的网约车和外卖订单

    来源 AI 行业观察
  11. AMD高管反问英伟达Arm:芯片研发需数年,智能体CPU说法站得住吗

    AMD企业副总裁Madhu Rangarajan与Zen首席架构师Mike Clark近日质疑英伟达、Arm将新品称为“专为智能体AI设计”的说法。AMD称芯片研发周期长达数年,四年前无法预见智能体AI兴起,并主张智能体工作流负载多样,需由不同类型CPU组成完整产品组合,而非单一专用型号。

    来源 凤凰科技
  12. 2028年空档期:美国中期选举如何推迟5GW数据中心建设

    大摩担忧,蓝色浪潮后,数据中心项目延迟可能在2028年造成科技供应链的“空档期”(air pocket),引发“定价权下降或库存积压”,甚至出现订单放缓、利润率正常化和盈利下调,即便AI需求本身仍然完整。亚洲云半导体厂商以及旧内存板块评级遭集体下调,理由是定价权“见顶”预期或提前到来。

    来源 华尔街见闻
  13. 美团开源LongCat-2.5,长序列SFT单卡吞吐较DDP提升86%

    美团11月10日开源LongCat-2.5,采用MIT协议,支持商用推理部署与二次训练,无需额外授权。模型面向长程智能体任务,为原生多模态架构,总参数1.6万亿、每个token激活约480亿参数,支持一百万上下文,在复杂代码库开发、完整项目构建、Visual Coding与专业办公场景的端到端交付能力明显提升,权重上线

    来源 AI 开发者社区
  14. Gemini4Carbon正式发布:多智能体协作与网络安全能力升级

    人工智能行业的更新迭代正在持续加速。Google DeepMind 近日正式宣布,旗下综合能力最强的旗舰级大模型——Gemini4Carbon 正式上线,全面面向开发者、企业、科研人员以及普通消费者提供服务。 定位高难度复杂任务:多维基准测试表现亮眼 作为 Gemini4家族中的核心实力派,Carbon 主要聚焦于复杂

    来源 AI 开发者社区
  15. Databricks用AI智能体替员工说真话:CEO不必认识每个人

    员工规模达到12000人后,Databricks CEO阿里·戈德西坦言:他不可能认识每个人,员工也不会主动汇报坏消息。为此,他用上了公司改版后的Genie智能体,让AI代替员工说出那些被层层过滤掉的真相——这或许揭示了企业AI应用的新方向:不只对外提效,也对内向管理层说真话。

    来源 AI 科技快讯
  16. Plurai把自动驾驶那套办法搬给AI智能体,想解决落地可靠性

    让自动驾驶汽车上路的端到端思路,正被一家名为Plurai的初创公司搬到AI智能体上。面对概率系统在不可预测环境中的稳定性难题,Plurai试图用系统化评估与仿真测试,帮助智能体从演示走向生产。本文梳理其方法论、行业背景与竞争格局。

    来源 AI 科技快讯
向下滚动自动加载更多