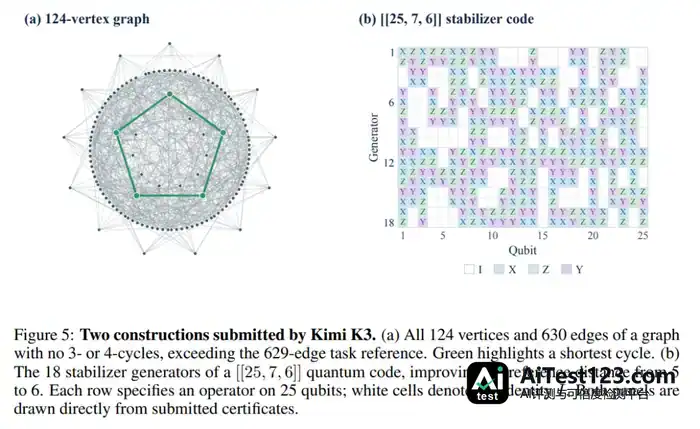
Kimi在图论124点构造出630条边,姚期智杨植麟联手测AI科研能力
Kimi 刷新 629 条边图论参考纪录,只多加了1条边,为什么数学界等了这么多年?

1条边,听上去没什么。可放到组合数学里,每想多塞一条边,都得在124个点之间把整套结构重新精密地大改一遍。说到底,这1条边是AI头一回在“极值构造”这类研究级任务上,把人类的参考纪录又往前顶了一步。
成果出自一项联合研究,参与者包括图灵奖得主、中科院院士、清华大学交叉信息研究院院长姚期智和月之暗面创始人杨植麟等人。他们要回答的问题很明确:AI究竟能不能做数学研究,还是只能做数学题?

01
“多1条边”能不能算真突破?
姚期智是图灵奖得主、清华大学交叉信息研究院院长,也是中国理论计算机科学的奠基者之一。杨植麟是月之暗面创始人,Kimi背后的推动者。
一位是理论计算机科学的泰斗,一位是大模型创业的一线操盘手,两代人、两种身份,这是他们第一次联合署名。
这个组合本身就透出一件事:AI做科研已不再是“实验室里的猜想”,理论计算机科学家和大模型团队得坐到一起,先定义清楚“什么叫算做出来了”。
不过争议也一直跟着:多构造出一条边,算不算真正的科学突破?会不会只是暴力搜索蒙对的个例?AI真的懂背后的数学机理吗?
姚期智团队的核心初衷正在这里。按他们的判断,如果分不清“运气好撞上”和“逻辑上证明”,AI就永远只是个黑盒计算器。于是他们没有继续在传统基准上打转,而是联手搭起一套此前没有的评测系统——TCSExam。
为了回答这个问题,TCSExam被提了出来:100项理论计算机科学科研任务,用来测试前沿AI Agent能不能证明定理、开发Solver、构造数学对象,乃至挑战长期未解决的猜想。
论文地址:https://arxiv.org/pdf/2611.07962v1
实验里,GPT-6 Astra在20项研究级定理中完成了14项;它还把有限域矩阵猜想在特定条件下的已知证明范围,从8维推到9维。
TCSExam的核心创新,是把AI的科研能力转成可以独立验证的研究成果。数学证明、算法表现、中间推导三项,分别由Lean 4、程序检查器和Checkpoint机制把关,局部进展不会被误判成完整成果。
Astra那个9维证明,把复杂的矩阵问题压成整数约束,最后用143条方程造出可核验的矛盾证书。从任务形式化、研究证书设计到数学证明的自动检查,这套框架给出了一条AI参与真实科研的技术路径。
02
这套评测框架是怎么搭起来的?简单说,就是把「AI 做科研」这件事拆成四条能验证的路径,再设三层机制,避免把只走了一半的进展当成完整成果。
普通数学考试有标准答案,理论计算机科学的研究工作却千差万别:有人要证新定理,有人要做出最优算法,还有人得构造满足约束的数学对象。成果形态不同,评法自然也得跟着变。
于是研究团队把 100 项任务分进四条轨道。第一条是定理证明,共 20 项,横跨 13 个理论计算机科学领域,模型须提交 Lean 4 证明。

第二条是 Solver 工程,30 项,要求写出能重复运行的算法程序,在独立测试实例和统一资源限制下接受评测。第三条是数学构造,20 项,看模型能不能生成符合严格约束的图、纠错码这类对象。第四条是开放猜想,30 项,允许模型从两条路走:证明成立,或者找出反例。
任务分好了,更麻烦的事在数学语言的转换上。人读一段定理描述能明白,机器验证却需要明确的定义、量词、假设和参数范围。哪个条件一变,最终证明的数学含义就可能不同。
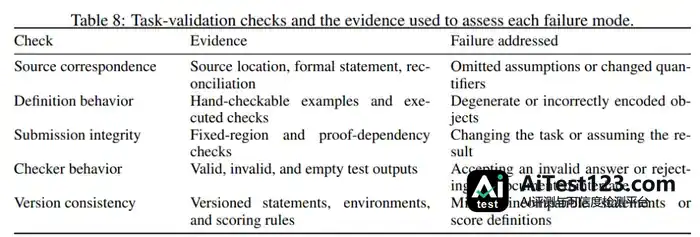
举个例子:某定理原本要求某种性质对任意规模的图都成立,转写成 Lean 时若多加一条图规模限制,模型即便证完,解决的也只是缩小范围后的版本。形式化证明系统能查代码里的逻辑,却没法自己判断它是否忠实于原始研究目标。
为此,TCSExam 建了任务编写加独立审核的机制:编写 Agent 依据研究材料构建形式化命题、提交接口和验证程序,审查 Agent 再核对定义、量词与参数条件,用边界样例和试运行排查问题,研究领域专家负责审定任务的研究意义。开发过程中,超过 40 道候选定理因为试运行阶段就被解决而退出题库。

Solver 轨道另做了两件事:对部分实例施加保持数学性质不变的变换,减少直接复用已有答案;数学构造轨道则固定合法性条件与参考纪录,保证可比性。

证明任务上,团队还控制了模型能拿到多少研究指导。Bare 模式只给定理和必要定义,Ladder 加上中间引理,Guided 再提供证明思路。三种条件用的是同一个主定理,研究者据此能分辨:模型是卡在找证明路线上,还是知道了关键步骤仍推不下去。
经过这番设计,TCSExam 把研究问题变成了输入、执行条件、交付要求都明确的任务。可模型交上来的东西可能夹着大量中间推导,怎么从中认出真正成立的数学结论,还得靠另一层验证。
03
局部推理和完整证明怎么分开?TCSExam 的底层设计借了理论计算机科学的一个特点:找解难,验解易。团队把这套思路搬进科研评测,要求 Agent 把探索结果整理成验证器能查的研究证书。
定理证明的证书就是 Lean 代码。Lean 内核按形式逻辑规则检查推导,系统还会审计证明依赖,排除未完成证明的占位符和未经允许的额外公理。
但研究级定理往往牵着一串中间引理,模型可能推完了大半,偏偏某个关键步骤过不去。只看主定理通没通过,很难说清能力缺口在哪。
所以 TCSExam 设了 Checkpoint 机制,把复杂证明拆成若干中间目标。验证某个 Checkpoint 时,系统暂把其他 Checkpoint 的命题当作假设,看模型能否在这些条件下完成当前推导。这里有个逻辑边界:假设证 A 时借用了 B,证 B 时又依赖 A,两个局部检查即便各自通过,整体证明仍有循环依赖。因此 Checkpoint 成绩只反映条件性推导完成到什么程度,主定理必须在移除未经证明的中间假设后,再独立检查一遍。
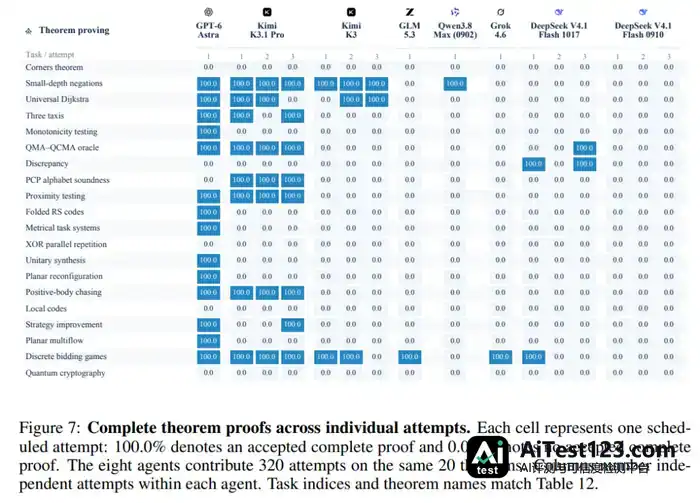
有个案例能说明区别:Kimi K3 某次尝试完成了 7 个中间 Checkpoint,覆盖程度达到 87.5%,主定理所需的最终推导却没做出来。系统留下局部成绩,同时拒绝把它算作完整证明。
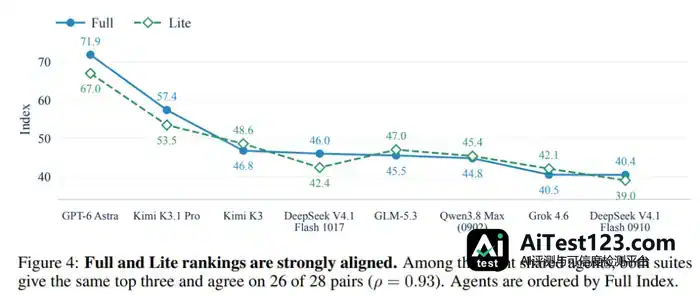
结合三种指导条件,还能看出模型间的能力差异。Kimi K3 在 Bare、Ladder 和 Guided 模式下分别至少完成 3、4、7 道不同定理,DeepSeek V4.1 Flash 0910 则分别是 0、2、6 道。给了中间引理和证明思路后,完成数量明显上升,说明难点常落在关键引理的发现,以及把分散推导组织成完整证明上。

另外,Checkpoint 只是辅助分析手段。模型若绕过预设的中间引理,直接构造出完整有效的主定理证明,系统照样接受。这给 Agent 留出了自主找证明路线的余地。
研究证书机制在 Solver 里是另一种实现:模型提交可重复运行的程序,检查器重新判断输出是否合法,并计算实际目标值。
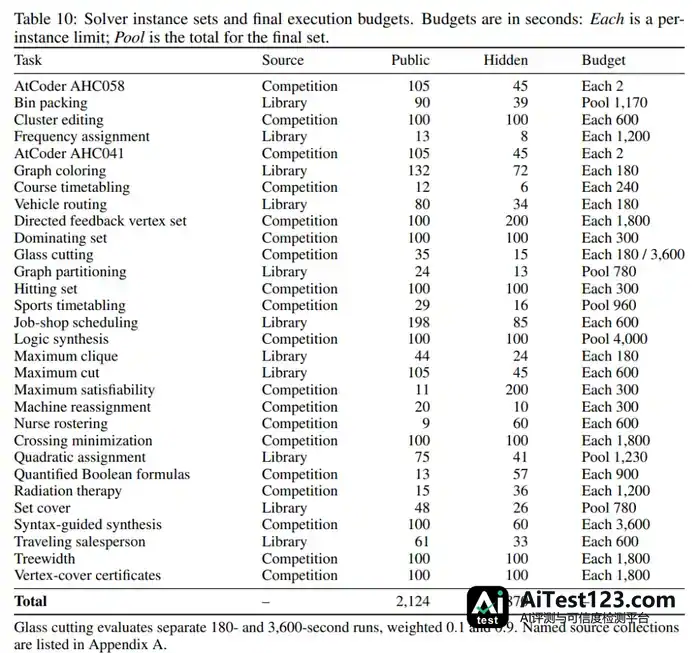
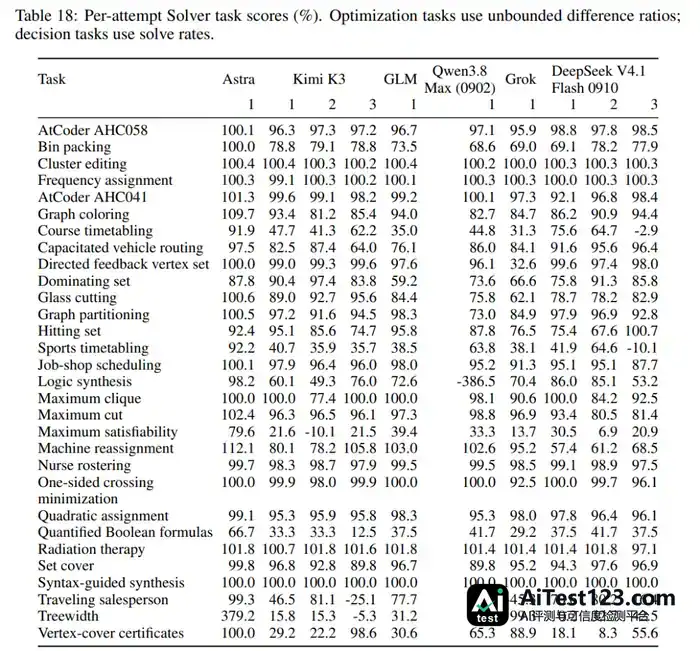
拿IWLS 2023逻辑综合任务来说,GPT-6 Astra对100个实例全部产出了有效电路。其中22个比公开参考电路更优,31个与参考水平持平,剩下47个动用了更多AND门。
不同实例的数值尺度不一,会干扰整体评价。系统为此加入了以Kimi K3多次运行结果为基准的标准化评分,让有效性和优化质量各算各的账。数学构造轨道也照此办理:先看对象是否满足结构约束,再比它拿到的数学参数。
研究目标一旦推到开放猜想,光靠局部覆盖或数值改进就不够判断结论成不成立了。模型得找出一条完整的证明路线,把里面复杂的结构分析转成能一步步核验的证据。
GPT-6 Astra对Alon–Jaeger–Tarsi猜想的研究,正好把这个过程走了一遍。
04
从8维到9维
Alon–Jaeger–Tarsi猜想研究的是有限域上的可逆矩阵。说白了,给一个可逆矩阵,研究者要找一个坐标全不为零的向量,并且它经过矩阵变换后,新向量各坐标依然全不为零。
此前的工作已经覆盖五元有限域中不超过8维的情形,Astra把范围推到了9维。维度一涨,要考察的矩阵与向量组合就迅速膨胀,硬枚举根本证不完,它只好换一条数学路线。
证明先假设存在一个不满足猜想的9维矩阵,再借低维情形已成立的结论,给这个反例套上必须满足的条件。接着Astra不再逐个抠矩阵元素,转而统计向量在矩阵变换前后各有多少个非零坐标。
它造了两组10×10的非负整数数组,分别刻画原矩阵和转置矩阵作用下,不同坐标数量之间的对应关系。矩阵可逆性卡住了数组的行列总数,有限傅里叶恒等式又把两组数组联系起来。再叠加反例的结构性质,还能推出部分计数必须为零。
这些条件把原本复杂的矩阵问题一步步压成整数约束,但检查范围还得再缩。
Astra随后盯上矩阵中两个列向量的坐标关系,按零元素分布以及非零元素间的消去比例,把它们划成7种类别。矩阵维度是9,各类别数量之和必须等于9,于是可能的类别计数组合只剩5005种。
关键的一步规模压缩就落在这里。系统不必枚举全部9维可逆矩阵,只要检查这些有限类别组合对应的数学约束。
在此基础上,Astra把同样的结构分析用到原矩阵、逆矩阵、转置矩阵及其逆矩阵上,又多出四组非负约束。加上前面造的两组计数数组,最后凑成一个含204个非负变量的整数线性系统。
到这一步,证明就变成判断这些整数约束能不能同时成立。Astra从原始的197条方程里挑出143条带非零乘子的,按特定整数系数组合,得到一个不可能成立的关系:204个变量的系数全非负,等式右边却是负数。
变量本身又必须非负,这样的关系必然自相矛盾,假设中的9维反例也就不可能存在。
这份证书把复杂的矩阵推导压成了有限的整数计算。独立核验确认,组合后的204个系数中93个为正、111个为零。整套证明还被整理成含71个Lean模块的项目,在独立环境中重新编译,并过了公理依赖检查。
从极小反例出发,用坐标计数建立约束,再靠有限类别分析缩小规模,最后以整数矛盾排除反例——这条路线体现了AI把数学结构分析与计算工具捏在一起的能力。
不过Astra搞定的是五元有限域上的9维特殊情形,完整的Alon–Jaeger–Tarsi猜想仍没解决。TCSExam的其他开放猜想实验也显示,当前模型离独立解决一般性难题还有差距。
部分被接受的Ryser和MIRUP反证,来自对OpenAI已公开成果的检索与适配;其余28项开放猜想都没拿到完整解决方案。
05
从局部发现走向长期研究
TCSExam的实验说明,AI已经能完成部分研究级证明,在算法优化和数学构造上也拿出了可核验的进展。但独立找关键引理、规划长程证明、把特殊结论推到一般情形,这几件事仍然明显吃力。
研究证书机制给未来的科研Agent铺了一种可迭代的工作底子。模型可以用Solver搜候选结构,借形式化工具检查数学性质,再按验证失败的位置改证明策略,把已经成立的中间结果接到后续研究里。
这次实验最该记住的,不是“630比629多1”,也不是“9维比8维多1维”,而是:AI已经能在部分研究级任务上产出“机器可核验”的新结果,尽管离“自己提出关键引理、自己规划长程证明”还有明显距离。
对数学界而言,这套评测框架具备复用价值;Kimi与月之暗面则借此展示了“AI for Science”的能力;落到普通读者眼里,这或许是个信号:AI参与科研,正从“帮人查文献、写代码”转向“帮人证定理、找反例”。