便宜得离谱!Meta甩出“最省钱模型”,1/3成本追平Claude Haiku 5.5
单项任务成本约为Claude Haiku 5.5的三分之一。

Meta在11月10日正式推出新模型Muse Ember,主攻复杂推理与智能体任务。按照Meta的说法,这是其至今体量最小、效率最高的一款模型,能跨应用执行工作流、连续调用工具、运行测试并修复代码。
Muse Ember支持100万Token上下文窗口,原生理解文本、图像、音频和视频,可处理大规模文档和多模态输入。

Meta创始人兼CEO马克·扎克伯格(Mark Zuckerberg)同日在社交平台X上公布了这一消息。他说:“Muse Ember是Meta目前最小的模型,在同类模型中能够以更低的成本提供更强的算力,专为Agent全天反复执行、消耗大量Token的工作打造。”
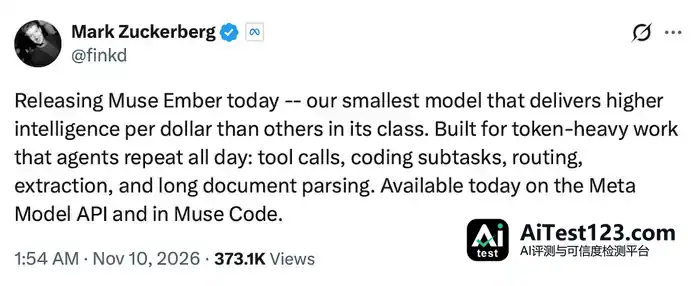
Muse Ember也是首个用Muse Wonder Full训练出来的模型。Muse Wonder Full于今年10月12日发布,隔了将近一个月,Meta就基于它做出了Muse Ember,继续用Wonder系列模型训练专用模型。
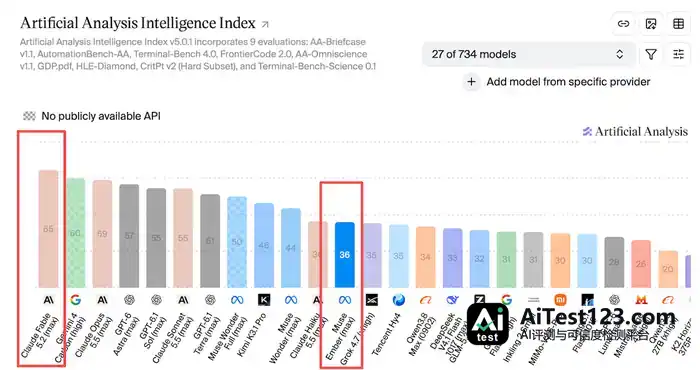
在第三方Artificial Analysis测评中,Muse Ember在最高推理强度下拿到35.8分,与 Claude Haiku 5.5的36.2分基本持平;但完成单项任务的花费只有约0.14美元(约合人民币0.94元),约为Claude Haiku 5.5的三分之一。同一天发布的Anthropic新模型Claude Fable 5.2则取得65分,比Muse Ember高出29分。
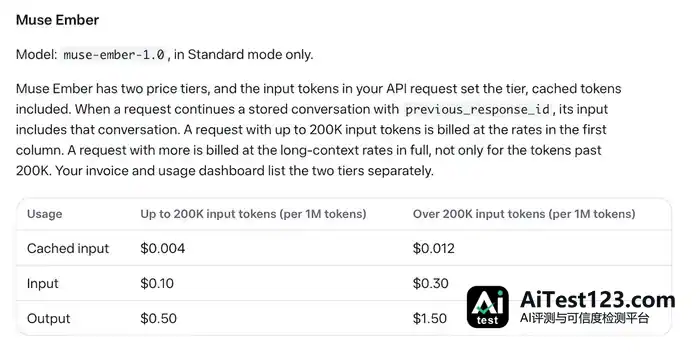
定价上,Muse Ember每百万输入Token收0.10美元(约合人民币0.67元),每百万缓存输入Token收0.004美元(约合人民币0.03元),每百万输出Token收0.50美元(约合人民币3.36元)。
目前Muse Ember已通过Meta Model API和Muse Code开放使用,同时支持Responses API。
一、网页生成实测表现亮眼,20多个网站平均2分钟完成
模型发布后,不少用户和开发者在社交平台X上聊起了Muse Ember本身和实际使用感受。
有用户提到,Muse Ember体量轻,却支持原生多模态输入和100万Token上下文窗口,还不会给GPU带来过重负担,这正是本地开发工具跑真实Agent工作流所需要的能力。

另一名用户觉得,比每Token价格更值得看的是“单项任务成本”。他举例说,一个便宜但得重试三次才能完成任务的模型,实际成本可能高过一个价格更贵、但一次就能做对的模型。他还表示,如果Muse Ember在真实Agent工作负载中确实能把成本压到同类模型的三分之一,用户采用才会真正被推动起来。
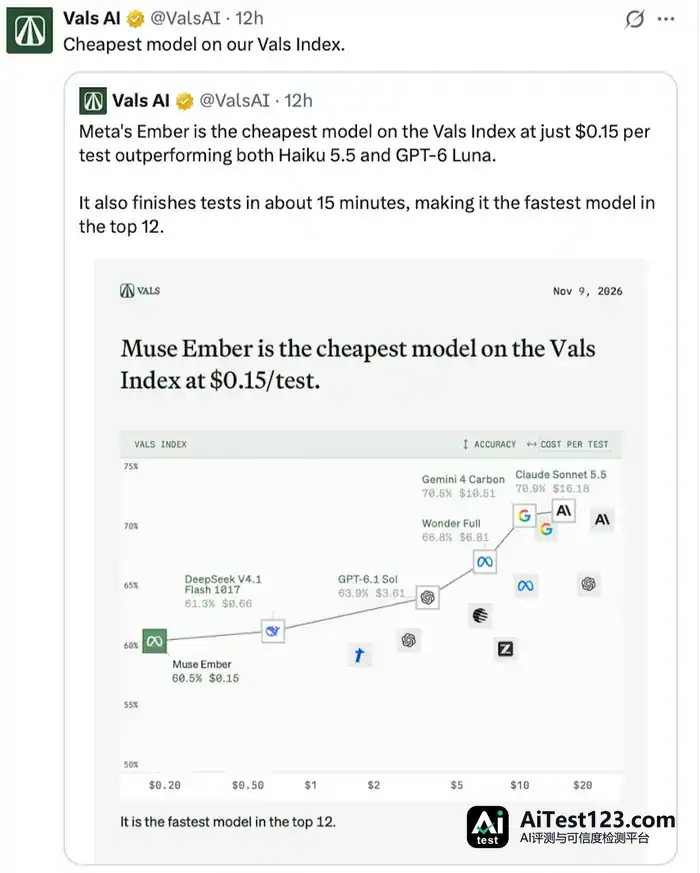
第三方评测机构Vals AI称,Muse Ember是Vals Index中单项测试成本最低的模型,每项测试只要0.15美元(约合人民币1.01元)。它在测试中取得60.5%的成绩,超过Claude Haiku 5.5和GPT-6 Luna。Muse Ember跑完测试约需15分钟,是榜单前12名模型里速度最快的。
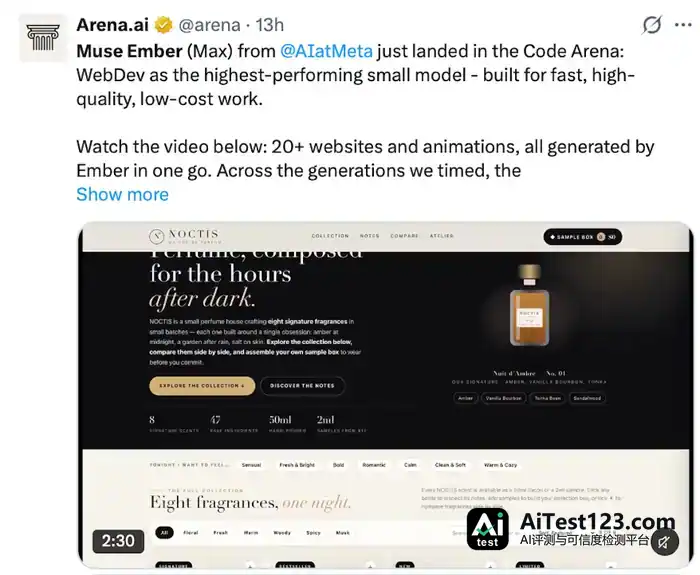
实际网页开发测试中,Arena.ai把Muse Ember接入Code Arena: WebDev,让模型一次性生成20多个网站和动画。Arena.ai表示,Muse Ember是目前该平台上表现最好的小模型,能以较快速度、较低成本生成高质量网页。在其计时的多轮生成任务中,模型平均每次生成耗时约2分钟。
Muse Ember 交出的成品里有个叫 NOCTIS 的香水品牌站点,产品陈列、香水分类、香调说明、产品对比、试香盒组合这些板块都做了出来。
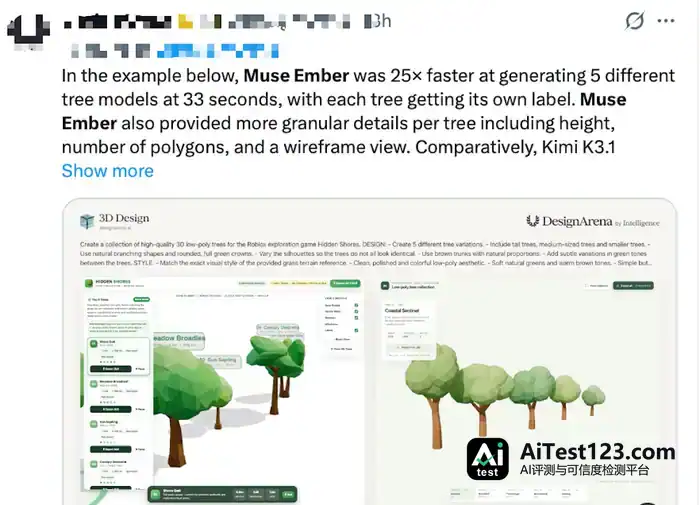
除了网页,Muse Ember 还被拉去测 3D 模型设计。一名开发者说,让它生成树木模型时,5 种不同的树只用 33 秒就出齐了,比用来对照的模型快 25 倍。出来的结果里,每棵树都单独打了标签,还附上树高、多边形数量这类细节,外加线框视图。
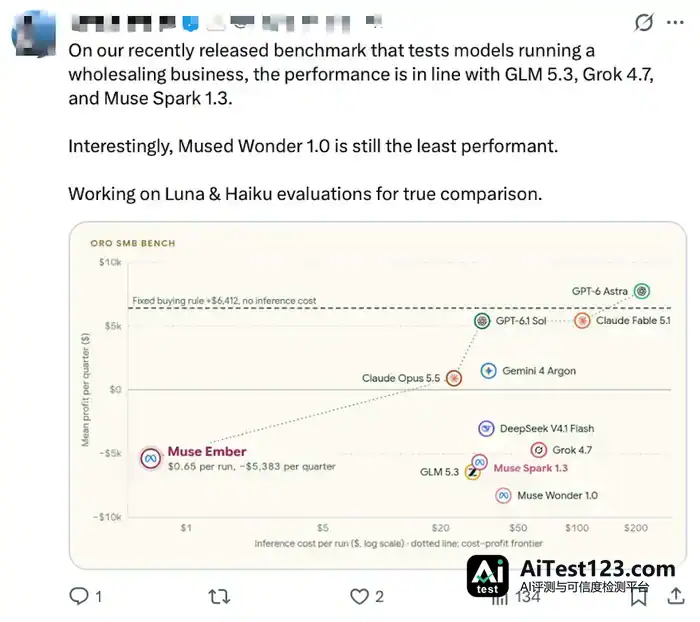
另一名开发者分享了Muse Ember在其近期发布的批发业务基准测试ORO SMB Bench中的表现。他称,Muse Ember在这项测试中的表现与GLM 5.3、Grok 4.7和Muse Spark 1.3相当。不过,Muse Wonder 1.0的表现仍然是其中最差的。他还提到,团队正在补充GPT-6 Luna和Claude Haiku 5.5的测试,以便进行真正的横向比较。
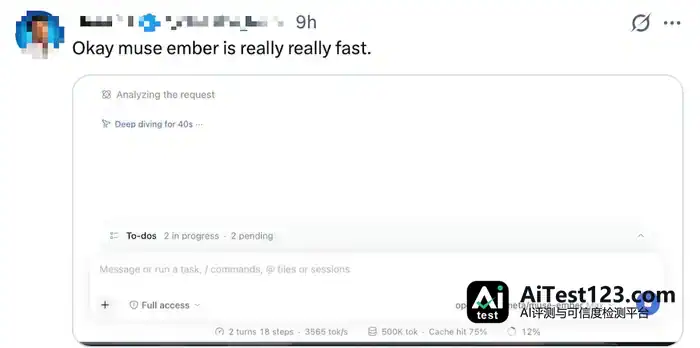
有用户也直接评价称:“Muse Ember真的非常快。”其分享的截图显示,通过OpenRouter调用Muse Ember时,一次运行完成了18个步骤,界面显示生成速度达到3565 Token/秒,缓存命中率为75%。
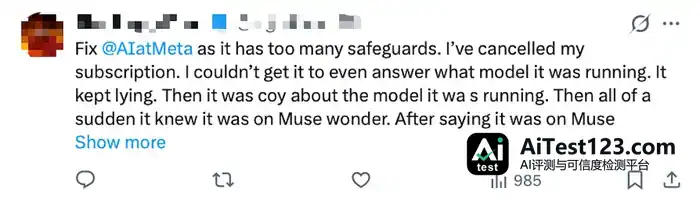
也有用户对Meta AI的产品体验表达了不满。他提到,Meta AI的安全限制设得太多,自己已经取消订阅。他说,连让Meta AI准确说出当前跑的是哪个模型都做不到,回答前后矛盾:先说运行的是Muse,接着又改口称是Muse Wonder。
二、单项任务成本低至0.14美元,Agent测试比肩Claude Haiku 5.5
Muse Ember瞄准的是AI Agent执行过程中大量反复出现的任务。Meta表示,Agent处理复杂工作时,要一遍遍调用工具、读取文件、运行代码、提取信息并修改结果。这些任务单次并不复杂,可在长工作流里会持续吃掉Token和算力。
这类高频任务正是Muse Ember的设计目标,工具调用、运行测试、有针对性的代码修复都能交给它。Meta称,在不同推理强度设置下,Muse Ember的单位成本智能水平基本都高于Claude Haiku 5.5和GPT-6 Luna。
在衡量模型综合智能水平的Artificial Analysis Intelligence Index v5中,最高推理强度下,Muse Ember与表现最好的Claude Haiku 5.5得分只差0.4分。
Muse Ember拿到35.8分,Claude Haiku 5.5为36.2分,可Muse Ember完成单项任务只花0.136美元(约合人民币0.91元),相当于后者单项任务成本的三分之一(约为0.411美元,约合人民币2.74元)。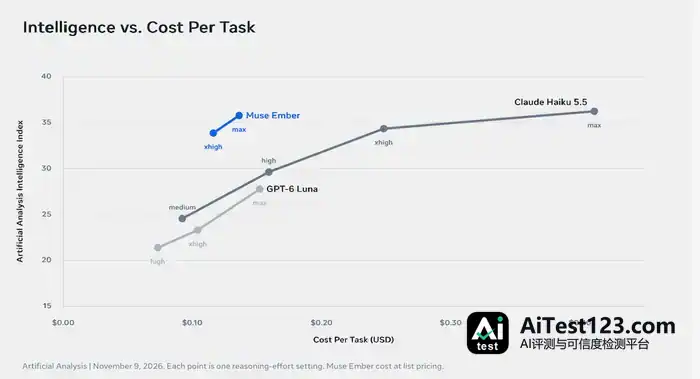
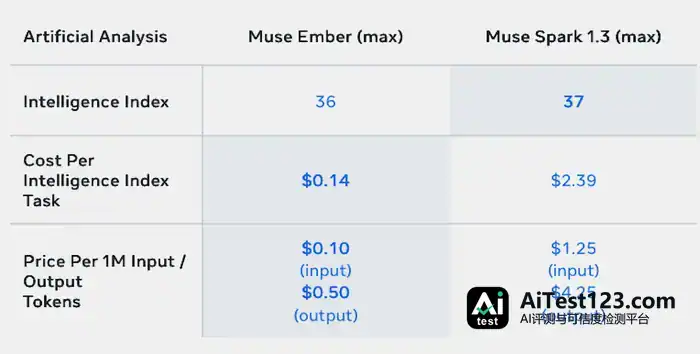
对比Meta自家的Muse Spark 1.3,Muse Ember的成本优势同样明显。
还是在测评集Artificial Analysis Intelligence Index v5中,Muse Ember得分36分,Muse Spark 1.3为37分。
两款模型完成单项任务的成本分别约为0.14美元(约合人民币0.94元)和2.39美元(约合人民币15.94元),Muse Ember的单项任务成本不到Muse Spark 1.3的5.9%。
Agent任务测试里,Muse Ember在AutomationBench-AA、Agents’ Last Exam等多项评测中均排名第一。
测评集AutomationBench-AA考察模型能否跑完端到端业务流程,Muse Ember得分37.8%,GPT-6 Luna为20.2%,Claude Haiku 5.5为13.9%。
测评集Agents’ Last Exam考察模型能否完成复杂工作任务,Muse Ember得分61.6%,GPT-6 Luna为57.1%,Claude Haiku 5.5为57.0%。
测评集Personal Superintelligence Index考察模型综合智能指数,Muse Ember得分46.8%,GPT-6 Luna为37.0%,Claude Haiku 5.5为36.1%。
编码能力上,Muse Ember多项测试也有竞争力,三项测试中两项排第一,不过在真实工程任务上仍有差距。
测评集Coding Agent Index考察模型在真实Agent框架中完成编码任务的能力,Muse Ember得分46分,Claude Haiku 5.5为37分,GPT-6 Luna为31分。
测试集Terminal-Bench 4.0考察模型通过终端环境完成Agent式编程任务的能力,Muse Ember得分40.9%,略高于Claude Haiku 5.5的39.2%,领先GPT-6 Luna的16.4%。
测试集Artificial Analysis的FrontierCode 2.0-AA考察模型能否完成真实工程任务,这一项Muse Ember不占优,仍落后于Claude Haiku 5.5。Claude Haiku 5.5得分最高,为34.9%;Muse Ember为27.2%;GPT-6 Luna最低,为25.2%。
多模态和电脑操作方面,Muse Ember的表现与GPT-6 Luna、Claude Haiku持平或更高。Meta称,该模型还能看着截图直接操作电脑,并识别画面中的细节。
测试集GDP.pdf-AA考察模型的长文档能力,Muse Ember与GPT-6 Luna均得分22.8%,Claude Haiku 5.5为20.8%。
Meta还用测试集OSWorld 2.1考察模型在真实桌面应用环境中操作电脑的能力。Muse Ember得分69.5%,略高于Claude Haiku 5.5的68.9%,领先GPT-6 Luna的50.5%。
在Meta内部用于检验图像细节识别与理解能力的PerceptionBench测试中,Muse Ember拿到80.6%,Claude Haiku 5.5为78.6%,GPT-6 Luna则是62.8%。
三、企业合作伙伴反馈积极,Muse Ember主打执行任务
企业应用层面,Meta拉来了网络安全服务商Cloudflare、AI搜索平台You.com等伙伴,让它们参与早期测试。
Cloudflare首席技术官戴恩·克内希特(Dane Knecht)表示,在该公司的测试里,Muse Ember能让部分任务的尾部延迟最多下降30%。
You.com推理负责人查克·波蒂纳(Chak Pothina)提到,其测试中的编码任务Muse Ember全部完成,P95延迟为2.2秒,速度约为部分领先开源模型的4至13倍,输出Token数量则少了36%至48%。
按Meta的划分,Muse Wonder管最难的问题,Muse Spark面向编程和Agent工作流,Muse Ember承担大规模、重复性的编码和Agent任务。Meta的说法是:“Muse Wonder负责规划,Muse Ember负责处理大量执行任务。”
它也是首个用Muse Wonder Full训练出来的模型。Meta早前讲过,会用Muse Wonder系列去开发更专门化的模型,再把能力推给更多用户,Muse Ember就是这条路线下的产物。
安全上,Meta称Muse Ember发布前已按Meta超级智能扩展框架(Superintelligence Scaling Framework)做过评估,范围包括化学与生物安全、网络安全、失控风险等类别。在已经评估的风险类别里,这款模型都没有触及框架设定的高风险阈值。
结语:大模型造小模型,Meta探索Agent时代的模型分工
Muse Ember的定位说明,Meta在把不同规模的模型在Agent工作流里的角色分得更细:复杂任务交给Muse Wonder Full这类大模型,高频调用和重复执行则交给更轻量的小模型。
由Muse Wonder Full训练而来的Muse Ember,在部分测试集上已经跑出优于通用大模型的成绩,执行速度和调用成本也压住了。
对需要持续调用模型的开发者和企业来说,Muse Ember给高频Agent任务添了一个更便宜的选择,小模型也由此成为大模型能力的一种补充。