ZONOS3-Mini开源:1亿参数跑边缘,实时语音克隆来了?

资讯 AI 应用前沿 全文 3303 字 · 约 9 分钟读完 配图 15 张 分类开源模型发布手机语音

Zyphra发布ZONOS3-Mini,这是一个仅含1亿激活参数的开源TTS模型。它支持43种语言的零样本语音克隆,能在手机和浏览器中实时运行。通过新的音频编码器和混合架构,它在保持高音质同时大幅降低延迟,并允许用户像调音一样精细控制语速、情感和口音。

所属频道 模型发布AI 硬件与终端开源生态

摆脱“机器味”:ZONOS3-Mini 来了

做语音合成(TTS)时,行业里长期卡在两头:一头追求极致的自然度和情感表现,可代价是模型体积大、算力开销高,本地设备根本没法实时跑起来;另一头为了速度牺牲音质,出来的声音平平淡淡,电子味很重,一听就是“机器音”。

Zyphra 新出的 ZONOS3-Mini 想把这个僵局撬开。它不只是一个在实验室里刷分的模型,而是一个真正奔着边缘计算去的开源项目,目标是让高质量语音克隆进浏览器、进手机。

ZONOS3-Mini

最抓眼球的是它的“瘦身”。ZONOS3-Mini 只有 1 亿个激活参数,总参数量 8 亿,对比前代 ZONOS2 那个 80 亿参数的 backbone,体量缩了一大截。可数字会骗人——它在多项基准测试里压过了 Fish Audio、Qwen TTS 等知名开源模型,某些指标上甚至逼近专有商业模型。另外,它支持 43 种语言,用户还能对声音做像素级的精细控制:调口音也好,改说话时的情绪张力也好,都不用重新训练模型。

速度快,靠的是什么?

ZONOS3-Mini 的速度优势不是靠简单剪枝换来的,根子在底层架构被重做了一遍。团队在音频表示、序列建模和说话人表征这三个关键环节上下了不少功夫。

1. 音频编码器换了更聪明的方案:ZAC-1

传统神经音频编解码器(比如 DAC)重建音质确实好,但帧率高达 86 Hz,自回归模型扛不住这么重的负担,生成延迟就上去了。Zyphra 为此专门训练并开源了 Zyphra Audio Codec 1 (ZAC-1)。

ZAC-1 把帧率压到 15 Hz,输出采样率仍有 44.1 kHz。它用的是双重编码策略:第一个码本负责量化语义特征,其余九个码本处理声学残差。这么设计,后面的 Transformer 骨干网建模起来轻松不少。数据能说明问题:在同样的数据约束下,基于 ZAC-1 训练的 TTS 模型,词错误率(WER)比基于 DAC 的模型低 10 倍,声学相似度也更高。

2. 混合架构:Gated DeltaNet + Latent MoE

ZONOS3-Mini 没有一味堆注意力机制,而是用了混合序列混合器。11 层网络里,9 层是 Gated DeltaNet (GDN)——一种循环结构,处理长序列擅长,计算效率也高;另外 2 层用全局多头注意力机制,专门抓长距离依赖。两者搭配,模型在 32,768 个位置的上下文窗口里都能高效工作,连续 10 分钟的音频也处理得下来。

模型还引入了潜在混合专家(Latent MoE)机制。每个令牌只激活 64 个专家中的 2 个,于是模型总参数容量保持 8 亿,每次推理却只动用 1 亿参数。这套稀疏激活策略,是它能在消费级硬件上实时推理的关键。

3. 双模说话人表征

为了让克隆出来的声音更像“本人”,ZONOS3-Mini 弃用了之前的 Qwen3-TTS 编码器,换成 MECT-B2 说话人验证模型。克隆模式有两种:

  • 上下文参考模式:喂一段最多 60 秒的参考音频,模型从中提取韵律特征,生成的语音自然、不僵硬。
  • 直接嵌入模式:使用 192 维的 MECT-B2 嵌入向量。这种方式更紧凑,适合做语音预设,也为后面的“机械可控性”打了底。

声音控制,像调音台一样

多数 TTS 模型只能做到“像某人说话”,ZONOS3-Mini 往前走了一步,能做到“让某人以某种方式说话”。这靠的是它的机械可控性(Mechanistic Controllability)设计。

ZONOS3-Mini TTS Pareto Frontier

借助激活 steering(Activation Steering)技术,用户在推理过程中就能直接干预模型内部状态,声音的各种属性随之调整,不用重新训练,也不用微调。
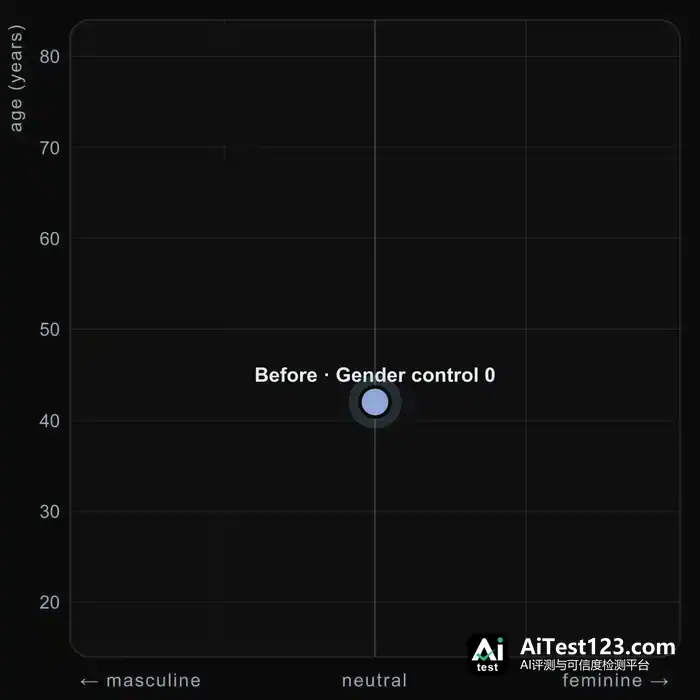
Gender control moving to gender -1

声音设计:定制你的角色

Emotion settings for each variant

声音的物理特征,可以像调均衡器那样去调:

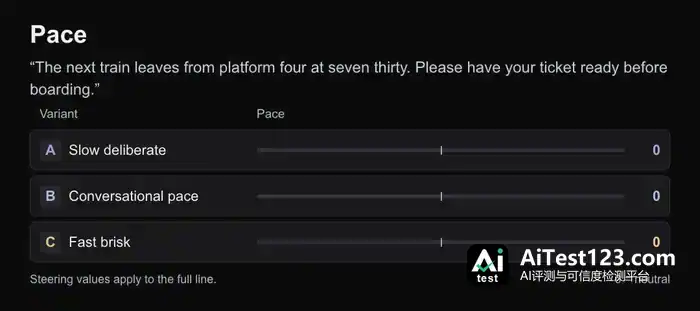
Pace settings for each variant

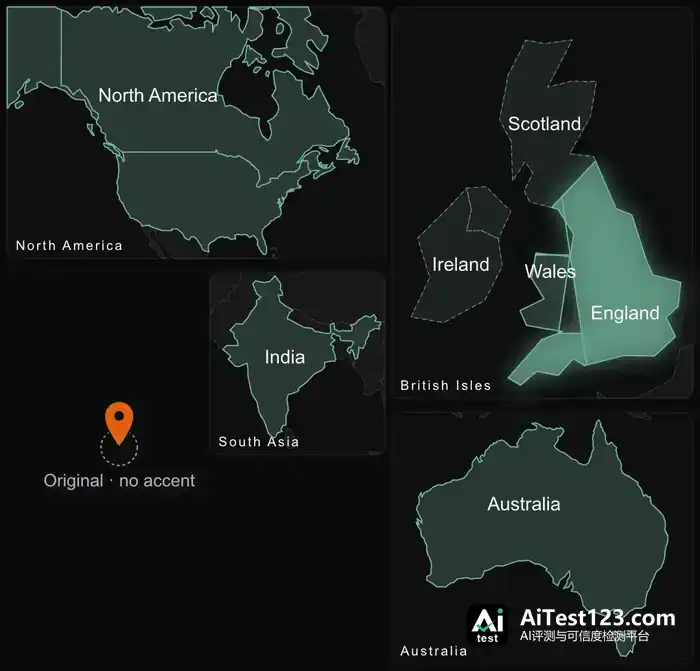
  • 口音切换:同一个说话人的音色不变,口音从美式英语切到英式南部口音,甚至澳大利亚口音都行。测试里发音变化很明显,身份特征却保持住了。
  • 年龄模拟:调一调年龄向量,同一个声音可以听上去像 25 岁的青年、45 岁的中年人或者 75 岁的老人。实现方式主要是改共鸣和音色纹理。
  • 性别呈现:在男性化、女性化和中性之间平滑过渡,靠的是调整共振峰和音高。
  • 音色纹理这一项里,把“柔和度”往上调就能做出气声效果,而“沙哑度”加大则添上粗糙的质感。两类控制都是连续变化的,因此可以做出很细微的混合。
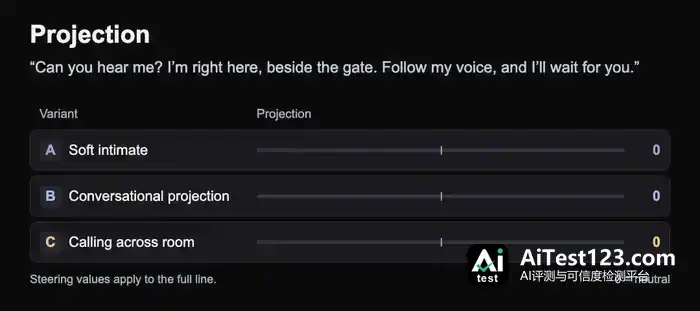
Projection settings for each variant

表达控制:注入情绪与节奏

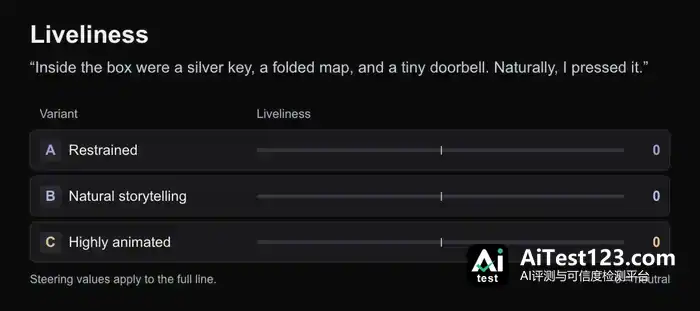
Liveliness settings for each variant

物理特征之外,说话方式本身也在 ZONOS3-Mini 的调节范围内:

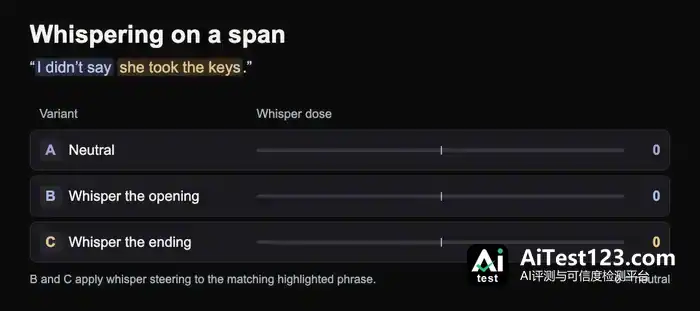
  • 局部耳语:句子中的某个片段,比如“我没说”,可以单独指定为耳语,其余部分照常保持正常音量。实现方式是监控对齐注意力头。
  • 情绪意图:同一句“你回来了。我不确定你会来。我整晚都在等。”,能演出温暖的释然,也能演出克制的愤怒,或者紧张的焦虑。办法是调整快乐、愤怒、恐惧这些情绪向量,模型便能抓住微妙的情感色彩。
  • 语速与投射:语速从缓慢刻意到快速轻快都能调,清晰度不会因此打折扣,平台号、出发时间这类关键信息依旧准确。投射控制则能造出从耳边低语到隔着房间喊话的距离感。
  • 生动性:音调变化与节奏兴趣一经调整,叙述就能从 restrained(克制)转向 highly animated(生动活泼)。

性能实测:在手机上也能动起来

理论再好,落地才是硬道理。ZONOS3-Mini 在多种硬件上的表现令人印象深刻:

  • Pixel 9 手机:在浏览器中运行,首字音频延迟(TTFA)低于 570 毫秒。
  • M3 MacBook Air:TTFA 低于 150 毫秒。
  • 单张 H100 GPU:中位 TTFA 仅为 80 毫秒,峰值吞吐量达到实时的 457 倍。

这意味着它不光能部署在服务器上提供低成本 API,也能完全跑在客户端,用户隐私因此得到保护。推理后端方面,Zyphra 提供了多种选择:SGLang-Omni、面向 Apple Silicon 的 MLX、C++/ggml(支持 CPU、CUDA、Metal、Vulkan),以及 WebGPU。

开源生态与评估基准

Zyphra 这次开源的内容相当全面:Apache 2.0 许可的模型权重、MIT 许可的运行时代码,还有全新的评估基准 ZTTS2-Eval。

ZTTS2-Eval 的覆盖范围包括 35 种语言的干净语音评估,以及 20 种语言的野外说话人克隆评估。为避开单一评估器带来的偏差,它把 Qwen3-ASR 与 Whisper Large v3 结合起来,并引入基于项目反应理论(IRT)的能力指数。在 ZTTS2-Eval 排行榜上,ZONOS3-Mini 位列开源加权模型第一,排在 Fish S2 Pro 和 MOSS TTS v1.5 之前。
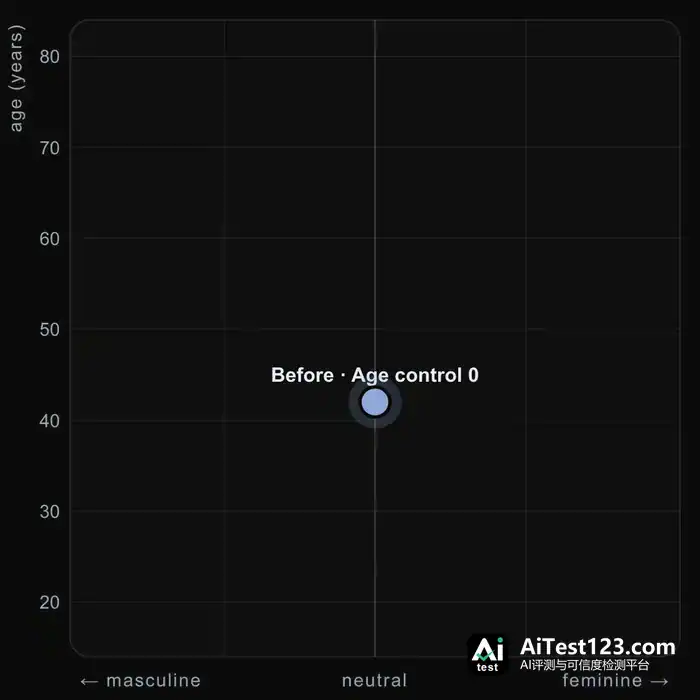
Age control moving younger to age -1.5

对开发者来说,上手门槛极低。零样本克隆可以直接在 Hugging Face Space 里体验,本地服务则用一行命令就能启动:
Age control moving older to age +1.5

sgl-omni serve --model-path Zyphra/ZONOS3-Mini --port 8000
Gender control moving to gender -1.5

之后就能走标准的 OpenAI 兼容接口来调用:

Whisper span settings for each variant

curl -X POST http://localhost:8000/v1/audio/speech \
  -H "Content-Type: application/json" \
  -d '{"input": "Hello from ZONOS3-Mini!"}' \
  --output output.wav
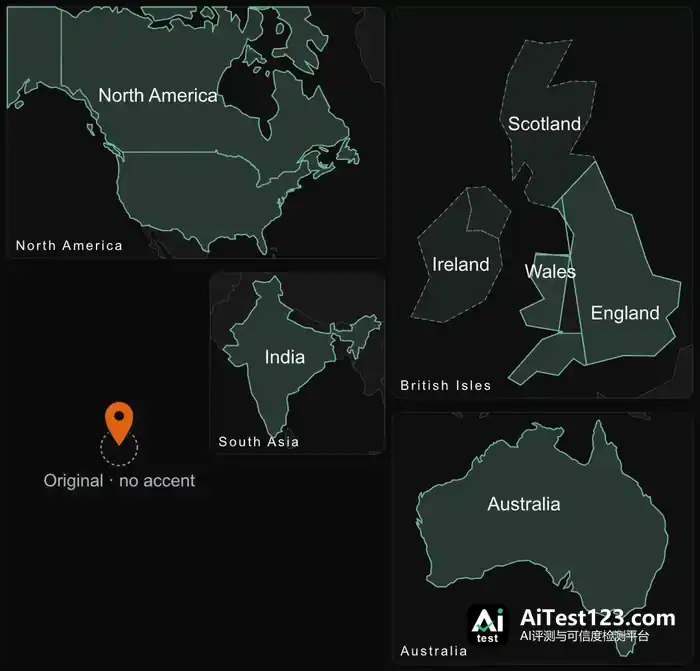
Accent map with the original voice marked, no accent steering applied

结语

Accent map steering toward England at british 1.5

ZONOS3-Mini 的出现,意味着 TTS 技术走到一个转折点:高质量语音合成不再是大模型的专利。高效的架构设计加上精细的控制机制,让实时、个性化、可控制的语音交互成为可能。游戏 NPC 的动态配音、有声书的个性化朗读、辅助沟通工具,这些场景里 ZONOS3-Mini 都拿得出一个强大且灵活的开源基座。

Accent map steering toward Australia at australian 1.5

WebGPU 逐渐铺开,本地 AI 推理能力也在跟上。照这个势头,用不了多久,应该会有更多应用把这么复杂的语音模型直接放到端侧跑,让私密、即时、表现力足的语音体验真正落到用户手上。

Age control at the neutral base voice

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. SOV-Transcribe-1:4亿参数如何破解真实场景语音识别难题?

    Salesforce发布了SOV-Transcribe-1,这是一个拥有40亿活跃参数的开源语音识别模型。它在英文转录准确率、关键实体识别以及口音适应性上表现突出,尤其在嘈杂环境和特定领域术语识别上优于同类开源模型。该模型支持通过指令调整输出风格,并允许开发者通过上下文偏置优化专有名词识别,适合构建企业级语音应用。

    来源 AI 应用前沿
  2. 文心5.5 Flash Preview发布:280B参数MoE,主打游戏与3D工作流

    百度发布文心5.5 Flash Preview,采用280B总参数、14B激活参数的MoE架构,支持1M超长上下文。该模型重点强化了游戏开发、3D建模和视频创作等Agent工作流能力,能端到端完成复杂任务。API已在千帆平台上线,权重预计11月25日前开源。相比同类模型,其在特定垂直场景的工程化落地能力更为突出。

    来源 AI 应用前沿
  3. 开源 3D 创作软件 Blender 招聘工程师,将适配鸿蒙 HarmonyOS

    IT之家 11 月 12 日消息,开源 3D 创作软件 Blender 在其官网招聘高级软件工程师,招聘要求显示将适配鸿蒙 HarmonyOS。 Blender 是一款免费且开源的跨平台全能型三维计算机图形(3D)创作套件,由总部位于荷兰阿姆斯特丹的 Blender 基金会(Blender Foundation)维护与

    来源 AI 行业观察
  4. 谷歌发布Gemini 4 Hydrogen:跑分超Argon,搜索免费用

    一觉醒来,谷歌又发 Gemini 4 模型了。11 月 12 日,谷歌正式发布 Gemini 4 Hydrogen,并同步推出了多模型智能调度系统 Orchestrator。这是一个 Flash 级别的大模型(也是 Gemini 3.8 Flash 的继任者),原生多模态,输入、思考和输出共享 100 万 token

    来源 腾讯网
  5. MiniMax H3 Image开源:原生4K直出,10秒生成

    编辑|泽南、杨文「GPT is cooked.」这两天,这句话在 AI 社区里反复出现。让人坐不住的是 MiniMax 刚发布的图像模型 MiniMax H3 Image。这是一个原生 4K 直出、10 秒级生成、支持 16 张参考图的模型,本周二刚刚开源,刷新了开源图像模型的 SOTA。从大家的第一波反应看,这个说法

    来源 腾讯网
  6. 李彦宏发布词元所:大模型交易平台上线月余,日均调用Token破7000亿

    李彦宏表示,当一个开发者或者一家企业,真正想把模型用起来的时候,往往会发现模型越多,选择越困难。同一款模型有的贵,有的便宜,来源五花八门,质量参差不齐,选来选去就是不放心,不敢用。词元所就是为了解决这个难题而生,宣称是一个中立、可信的大模型交易平台。

    来源 IT之家
  7. 百度李彦宏上线词元所:大模型交易平台主打中立可信

    IT之家 11 月 12 日现场消息,在今日的百度世界大会 2026 活动中,百度创始人李彦宏宣布推出一个全新的大模型服务平台 —— 词元所。 李彦宏表示,当一个开发者或者一家企业,真正想把模型用起来的时候,往往会发现模型越多,选择越困难。同一款模型有的贵,有的便宜,来源五花八门,质量参差不齐,选来选去就是不放心,不敢

    来源 AI 行业观察
  8. 谷歌Gemini 4 Hydrogen上线:速度翻倍,幻觉降5倍

    谷歌以一款面向普通用户和开发者的高效能模型,全面扩大Gemini 4系列的覆盖半径。继本周推出旗舰模型Carbon之后,谷歌周四发布Gemini 4 Hydrogen,以"为所有人带来前沿智能"为核心定位。该模型主打速度与执行效率,放弃沿用的"Flash"品牌命名,以Hydrogen取而代之。谷歌表示,Hydrogen

    来源 腾讯网
  9. IBM推LLMON标记语言:用结构化标签防住大模型提示注入

    IBM Granite团队推出LLMON,一种专为大语言模型设计的标记语言。它通过显式分离指令与数据,利用保留特殊令牌界定结构,显著降低提示注入攻击成功率。新版3B和8B预览模型在保持通用能力的同时,能精准识别执行块,忽略未绑定的干扰信息,为构建更安全的AI应用提供了新思路。

    来源 AI 应用前沿
  10. Claude Fable 5.2发布:写代码生成视频,5.75美元渲染4K短片

    Anthropic 新发布的 Claude Fable 5.2 展示了通过编写 Blender 和 JavaScript 代码生成视频的能力。开发者仅用一条提示词,就让模型自动建模、安排镜头并调用 GPU 渲染出 4K 短片,成本仅 5.75 美元。这种“代码生成视频”的方式在精确控制和可编辑性上优于传统像素生成模型,

    来源 AI 应用前沿
  11. TensorFlow 2 语音识别实战:从环境搭建到 CTC 的完整路径

    这本书不讲虚的,直接上手TensorFlow 2.1。从安装GPU驱动开始,讲清楚Keras API、ResNet残差块、LSTM时序处理,最后用MFCC和CTC算法跑通一个完整的中文语音转文字项目。适合想跳过理论推导、直接看代码怎么写的开发者,也适合需要补充底层原理的初学者。

    来源 AI 应用前沿
  12. 谷歌Gemini 4 Hydrogen:百万Token输入1.5美元,主攻日常编程

    IT之家 11 月 13 日消息,谷歌正式推出 Gemini 4 Hydrogen 模型,主打快速执行与高效运行,面向日常编码和智能体工作流场景,将 Gemini 4 系列能力全面下放至所有层级用户。 输入:每百万 Tokens 1.50 美元(IT之家注:现汇率约合 10.0 元人民币) 输出:每百万 Tokens

    来源 AI 行业观察
  13. 谷歌Gemini眼镜395美元起:隐私优先能否避开Glass老路?

    谷歌正式发布首款搭载Gemini AI的智能眼镜,起售价395美元。产品由谷歌联合三星、Gentle Monster和Warby Parker共同打造,主打隐私保护,试图避免Google Glass当年的覆辙。在Meta Ray-Ban智能眼镜打开市场后,谷歌携大模型能力重返可穿戴赛道,智能眼镜的AI助手之战正式打响。

    来源 AI 科技快讯
  14. 谷歌上线Gemini 4 Hydrogen:3.8 Flash退役,发布节奏变了

    谷歌正式发布Gemini 4 Hydrogen,一改Carbon与Argon缓慢谨慎的安全发布节奏,以更快速度推向市场,并取代服役已久的3.8 Flash。本文梳理此次发布的策略转变、模型定位与行业影响,分析谷歌在模型迭代速度与安全治理之间如何重新取舍,以及这一动作对整个大模型竞争格局可能带来的连锁反应。

    来源 AI 科技快讯
  15. Runway开源Praxis-1:270亿参数世界动作模型登顶RoboLab-120

    人工智能在具身智能领域的竞争迎来了又一个里程碑。近日,知名人工智能企业 Runway 宣布,其旗舰级世界动作模型 Praxis-1正式面向全球开发者和研究者开源,并采用友好的 Apache2.0许可,不仅开放了全部模型权重,还同步开源了推理和微调代码,全面支持商业用途。 顶尖性能:270亿参数 MoE 架构,登顶权威机

    来源 AI 开发者社区
  16. Phota Labs押注AI自动修图:随手拍的照片能变专业大片吗?

    又一家创业公司盯上了手机相册。TechCrunch报道,Phota Labs正尝试用AI把照片后期流程自动化——不是再做一个需要用户手动调参数的修图工具,而是让AI接手从构图到调色的全部工作,把随手拍的日常瞬间变成看起来像专业摄影师出品的照片。在生成式AI重塑图像创作的当下,这条赛道的想象空间与争议同样巨大。

    来源 AI 科技快讯
  17. Matrix-Game4.0上线Reactor:单张RTX5090跑480p、60FPS实时游戏

    昆仑万维宣布其10月发布并开源的Matrix-Game4.0正式上线实时世界模型平台Reactor,为开源后首次平台化开放,可在浏览器进入城堡、古埃及与城市赛车三个世界「边玩边生成」。Reactor总部位于旧金山,以统一SDK与API、全球分布式GPU网络支持几行代码接入,11月7日官宣上线。 Matrix-Game4

    来源 AI 开发者社区
  18. Claude Fable 5.2登顶两项评测,百度新模型以代码生成场景

    本期速报关注两大模型动态:Anthropic的Claude Fable 5.2在Web开发与智能体评测中表现强劲,但单次任务成本高达10美元以上;百度文心新模型展示通过纯代码生成《后室》场景并快速切换画风的能力,且计划开源。此外,AWS推出跨框架智能体评估系统UAEF,昆腾动力机器人进入物流规模化交付阶段,酒店洗衣机器

    来源 AI 应用前沿
  19. 苹果M1芯片功臣威廉姆斯:用手机芯片省电思路撑AI超算

    IT之家 11 月 13 日消息,在最新一期 Power On 访谈节目中,彭博社的马克 · 古尔曼(Mark Gurman)邀请苹果前 CPU 首席架构师杰拉德 · 威廉姆斯三世(Gerard Williams III)作客,探讨当前的 AI 浪潮。 IT之家查询公开资料,Williams 是一位深耕 CPU 架构数

    来源 AI 行业观察
  20. AlphaGenome 2发布:30分钟复现一年半实验,无需重训即可查致病细胞

    DNA突变究竟会在哪种细胞里惹出病?现在,AI也能帮我们查了! 现在,Google DeepMind发布了新一代DNA序列预测模型AlphaGenome 2。 它既能预测DNA突变会在哪类细胞中起作用、影响哪些基因,也能帮科学家们追查疾病根源、寻找更精准的药物靶点,为癌症、糖尿病等疾病的针对性治疗提供新方向。 而且,它

    来源 AI 行业观察
  21. Google智能眼镜开放预购:AI硬件迈入消费市场

    本期AI动态聚焦硬件与创作工具的落地。Google联合三星等品牌推出智能眼镜并开放预购,标志着AI可穿戴设备进入商业化新阶段。Runway新增文本转3D模型功能,Hugging Face发布相关微调指南。企业侧,Databricks Genie集成Slack,AWS完善多智能体互操作与安全控制。此外,百度昆仑芯M100

    来源 AI 应用前沿
向下滚动自动加载更多