

FreeLLMAPI聚合34家免费模型:一键接入635个端点
本文介绍如何安装和配置FreeLLMAPI,这是一个将Google、Groq等34家提供商的免费额度聚合为单一OpenAI兼容接口的工具。教程涵盖Docker及桌面版安装、密钥配置、智能路由原理及Python调用示例,帮助开发者在10分钟内利用每月约74亿免费token进行个人实验。
为什么需要 FreeLLMAPI
个人开发者或者学生想试一试最新的大语言模型(LLM),常常会卡在两个地方:各家厂商注册流程麻烦,免费额度又分散、有限。 Google AI Studio 给一点,Groq 给一点,Mistral 再给一点,单独看哪家都不多,而且某个服务一旦限流,代码就得跟着报错。
FreeLLMAPI 的做法不复杂:把这些零散的免费资源“打包”到一起。它接入了 34 家 AI 提供商,汇集 635 个免费模型端点,对外只暴露一个统一的/v1接口。按官方数据,这样叠加起来,每月大约能提供 74 亿免费 token 的推理能力。
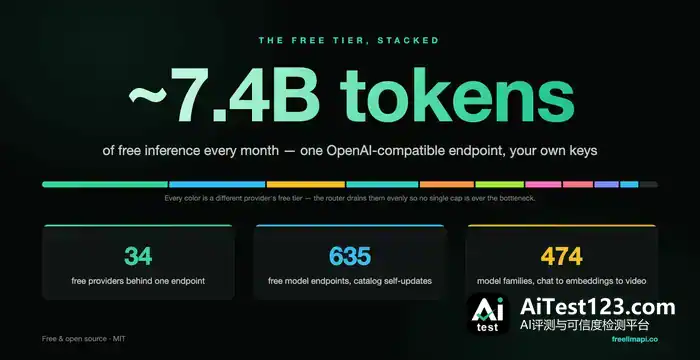
更实用的是“智能路由”。你发出请求后,如果首选提供商碰上流量高峰、返回 429 错误(限流),FreeLLMAPI 会自动切到下一个可用模型。对上层应用来说,这个切换是透明的,基本感觉不到中断。说白了,就是给免费服务加了一层“负载均衡”,让白嫖更稳一些。

不过项目明确标注了“个人实验用途”(Personal experimentation only)。免费层没有服务等级协议(SLA)保障,稳定性比不上付费 API,所以不适合直接拿去做生产环境的核心业务;拿来做原型开发、学习测试或者日常辅助,倒是完全够用。
三种安装方式:选最适合你的
FreeLLMAPI 给了三条部署路径,从极简到可控,按需挑。
方法一:一行命令(推荐 Docker 用户)
已经装好 Docker 的话,这是最省事的方式。在终端里执行:
curl -fsSL https://freellmapi.co/install.sh | bash脚本会自动做下面几件事:
- 在用户主目录创建
~/freellmapi文件夹。 - 生成加密密钥。
- 拉取最新镜像并启动容器。
这个命令是幂等的,重复执行只会更新到最新版本,不会覆盖你已有的配置数据,放心跑。
方法二:Docker Compose 源码部署(适合进阶用户)
想更清楚地掌控环境变量和配置文件,就走源码部署。先克隆仓库:
git clone https://gitcode.com/GitHub_Trending/fr/freellmapi
cd freellmapi然后生成一个随机的加密密钥,写进.env文件。Linux/macOS 下这样操作:
ENCRYPTION_KEY="$(openssl rand -hex 32)"
printf "ENCRYPTION_KEY=%s\nPORT=3001\n" "$ENCRYPTION_KEY" > .env
Windows PowerShell 用户要多绕一点弯子,才能生成随机字节:
$Bytes = New-Object Byte[] 32
[Security.Cryptography.RandomNumberGenerator]::Create().GetBytes($Bytes)
$ENCRYPTION_KEY = -join ($Bytes | ForEach-Object { "{0:x2}" -f $_ })
"ENCRYPTION_KEY=$ENCRYPTION_KEY`nPORT=3001" | Out-File -Encoding utf8 .env
最后启动服务:
docker compose up -d方法三:桌面应用(Windows/macOS 小白友好)
不想碰命令行,或者只想在本地电脑上快速试一下,桌面版最省心。下载安装包(Windows 为.exe,macOS 为.dmg),装好之后它会一直待在系统托盘里。
桌面版把路由器和仪表盘都做在了里面,账号密码不用配,登录是自动的。点一下托盘图标就能调出管理界面,请求统计也能实时看到。对不熟悉 Docker 网络配置的人来说,端口映射、环境变量这些麻烦事就省掉了。
首次配置:连接你的免费账户
装完之后,用浏览器访问http://localhost:3001(桌面版从托盘菜单里点“Open Dashboard”也行)。这一步很关键,能用到哪些模型,就看这里怎么填。
1. 添加提供商密钥
打开仪表盘的 Keys 页面,各个提供商的 API Key 都要在这里填进去。比如:
- Google AI Studio 的 Key
- Groq 的 Key
- Mistral AI 的 Key
- 或者别的任何支持 OpenAI 格式接口的服务商
只填一个 Key 也能跑起来。不过想用上“自动故障转移”,最好加两三个不同厂商的 Key。
2. 理解安全性
这么多 Key 填进去安不安全,不少用户心里打鼓。FreeLLMAPI 的处理办法是用 AES-256-GCM 算法加密这些密钥,存进本地 SQLite 数据库。只有处理请求的那一瞬间,密钥才会在内存里解密,网络传输和日志里都不会出现明文。当然,这工具是本地部署的,前提还是你的服务器或电脑本身别让别人非法访问。
3. 获取统一 API 密钥
提供商 Key 配好以后,Keys 页面顶部会出现一个长字符串,开头是freellmapi-这串东西就是你的“统一 API 密钥”。

往后你的代码和应用只认这一个 Key 就行,底层具体走的是哪家服务,不用再管。
发出第一个免费 AI 回复
配置完了,验证一下能不能跑通。
方式一:内置 Playground(最快验证)
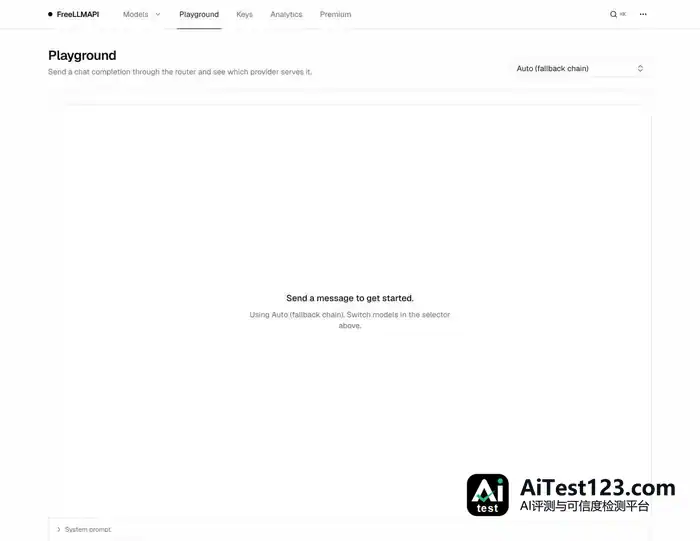
在仪表盘里找到 Playground 标签页,输入框里随便打一句话,比如“用一句话总结罗马帝国衰落的原因”,点发送。
一切正常的话,回复很快就到。留意回复下方的元数据,上面会写清楚:
- 这次实际是哪个提供商(Provider)响应的
- 本次请求具体调用了哪一个模型(Model)
- 这次调用花了多长时间(Latency)
想知道路由有没有真正起作用,看这两项最直接。
方式二:用代码接入(Python 示例)
对开发者来说,FreeLLMAPI 的价值在于能直接塞进现有项目里跑。它完全兼容 OpenAI API 标准,需要动的只有base_url 和 api_key 即可。
下面是一段 Pythonopenai 库的示例:
from openai import OpenAI
# 初始化客户端,指向本地 FreeLLMAPI 服务
client = OpenAI(
    base_url="http://localhost:3001/v1",
    api_key="freellmapi-your-unified-key", # 替换为你复制的统一Key
)
# 发送请求
resp = client.chat.completions.create(
    model="auto",  # 关键:设为 auto 让路由器自动选择最优模型
    messages=[
        {"role": "user", "content": "用一句话总结罗马帝国的衰落。"}
    ],
)
print(resp.choices[0].message.content)
这里有两点需要留意:
model="auto"这是 FreeLLMAPI 的一个特色参数。把它设成auto路由就会按实时评分(速度、可靠性、智能程度)挑出当下最合适的免费模型。当然,你也可以指定auto:fast(优先速度),或者auto:smart(优先智力),也可以直接把某个模型名写死,比如gemma-2-9b-it。- 响应头
X-Routed-Via另外,HTTP 响应头里会写明这次请求到底由哪家提供商处理,调试和统计时都用得上。
聊天补全之外,流式输出(Streaming)、工具调用(Function Calling)、Embedding 以及图像生成也都支持,接口的具体定义可以翻项目文档docs/api.md。
智能路由究竟怎么跑?
不少人关心,它说的“智能”落在什么地方。
请求到达 FreeLLMAPI 之后,路由器不会随意挑一个模型,而是按三个维度当场打分。
- 打分的依据分别是:速度,看历史响应延迟;能力,看模型参数量与基准测试成绩;可靠性,看最近的成功率。
评分靠前、密钥状态正常、又没撞上频率限制的模型,会被优先选中。请求一旦返回 429(Too Many Requests)或 5xx 服务器错误,系统会马上把该密钥暂时“冷却”,毫秒级转向链路上的下一个模型重试。
这样一来,免费服务的可用性被拉高了不少。免费层最怕的就是“突然不可用”,自动重试正好把这个问题接住了。
想看代码细节的话,核心逻辑在server/src/services/router.ts故障转移的重试循环则在server/src/lib/fallback-loop.ts 中。
监控与调试:每笔 Token 去向都能查
FreeLLMAPI 的仪表盘既能做配置后台,也是个好用的监控入口。
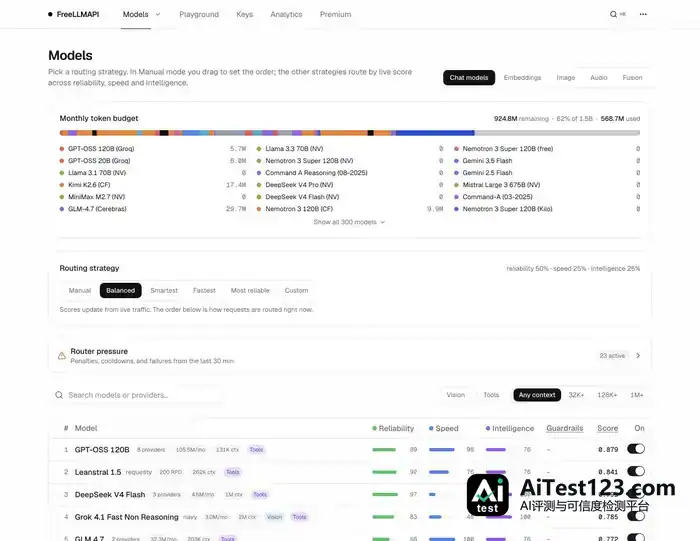
Models 页面会列出全部可用模型,排列顺序就是当前真实的路由顺序。每个模型旁边挂着实时的可靠性、速度与智能评分。整个模型池还剩多少月度 Token 预算,也能在这里看到。
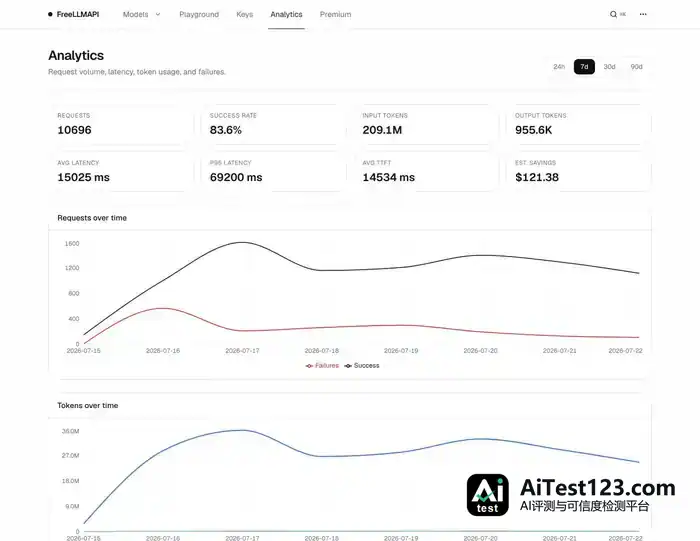
Analytics 页面给的是更宏观的视角:过去 24 小时到 90 天内的请求量、成功率、Token 进出总量、平均延迟都能查。数据还按提供商拆开,哪家贡献最多、哪家经常出问题,一目了然。
常见问题排查
用起来难免碰上些小障碍,下面是一些高频问题。
问:要设密码吗?答:桌面版不用,启动就自动登录。走 Docker 或源码部署的服务器版,首次启动时要填邮箱和密码。
问:密码忘了怎么办?答:登录页点“Forgot password?”,重置链接或验证码会直接打到服务器控制台日志里。重置码一般只有 15 分钟有效期。
问:局域网里其他设备能访问吗?答:默认可能只绑定 localhost。要让局域网访问,启动 Docker 时得设置环境变量。请只在可信网络环境下这么做,免得 API Key 暴露出去。HOST_BIND=0.0.0.0,例如:HOST_BIND=0.0.0.0 docker compose up -d
问:日志在哪看?答:Docker 用户执行就能实时查看。桌面版用户在系统托盘菜单里选“Open Logs Folder”即可。docker compose logs -f freellmapi
装好、配好、调用跑通之后,还有哪些进阶玩法可以试?
走完“安装-配置-调用”这一整套流程,下面这些方向可以接着往下玩。
一是让编程智能体接进来。Claude Code、Codex CLI、Aider、Cline 这些编程助手,都允许自定义 API 端点。照着
docs/clients.md里的说明去配置,就能让它们在本地免费跑起来。二是把本地模型加进去。本地如果跑着 Ollama、vLLM 或 LM Studio,可以在 Keys 页面把它们当作自定义端点添加。这样一来,FreeLLMAPI 就能同时调度云端的免费模型和本地私有模型,成本和隐私两头都能兼顾。
三是试试 Fusion 的多模型合成。这个功能挺有意思:向虚拟的
fusion模型发起请求时,系统会并行调用多个免费模型各出一版草稿,再交给一个“裁判模型”把草稿综合起来,给出质量更高的答案。代价是延迟会变长,不过碰上某些复杂任务,效果确实明显。
再提醒一句:FreeLLMAPI 是个不错的个人实验工具,接触前沿 AI 技术的门槛被它拉低了不少。但免费层不太稳定,如果要开发面向公众的商业产品,发布之前务必换成稳定的付费 API 方案。














