突发!DeepSeek开放全家桶API

资讯 网易科技 作者:网易 全文 2244 字 · 约 6 分钟读完 配图 7 张 分类DeepSeek深度求索Deepseek

sina qqZone renren ydCloud 0

所属频道 开源生态

DeepSeek开放全家桶API

周五晚上动手,D老师这次全摆上台面了。

DeepSeek刚刚宣布,全家桶应用API正式对外开放。

什么意思?

联网搜索、深度思考搜索、文件上传、链接阅读——这些在DeepSeek App里用惯了的功能,开发者现在通过API就能直接调用。不用打包,各有独立接口,可单独调用,也分开计费。

语音能力头一回被纳入开放范围,语音识别、语音合成等接口都在其中。

官方还撂下一句话,挺有意思:

开发者甚至可以1:1复刻出完整的DeepSeek App。

好家伙,自家产品都让人照着做了?
突发!DeepSeek开放全家桶API(配图 1)

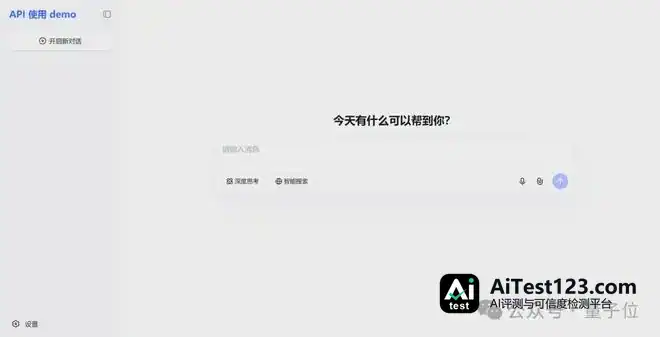
DeepSeek还自己先示范了一遍,开源了一套轻量级聊天前端Demo,能导入DeepSeek历史对话。

换句话说,搜索、文件解析、语音识别这些基础活,开发者不用再从零折腾,很快就能搭出一个功能接近DeepSeek App的产品。
突发!DeepSeek开放全家桶API(配图 2)

消息传开,评论区热闹得很。

有网友直接感慨:

什么叫1:1复刻出完整的DeepSeek App???人工智能之光!

全家桶应用API开放一览

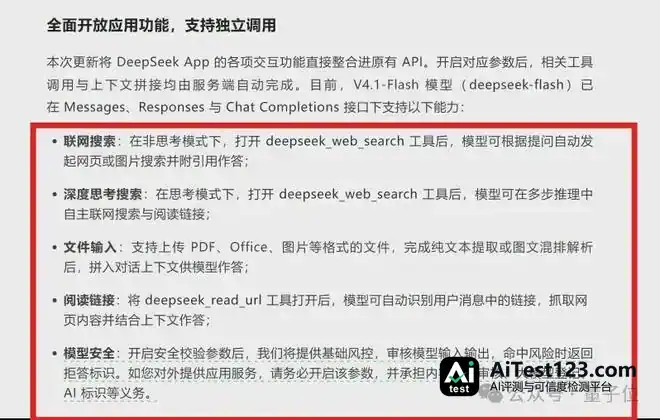
具体看,DeepSeek这轮放出的能力有这些:
突发!DeepSeek开放全家桶API(配图 3)

其中有两处变化,值得单独拎出来说。

先说联网搜索,这其实不是头一回开放。今年10月17日,DeepSeek就开放过自研Search和Fetch接口。

只是那会儿,工具调用和模型之间的衔接,不少活还得开发者自己处理。

比如用户问“最近AI圈发生了什么”,开发者得先让模型判断要不要搜,再调Search找网页、用Fetch读内容,最后把结果交回模型总结。

整套流程,全靠开发者自己写代码串起来。

现在省事多了。

开发者只要给模型打开联网搜索功能,什么时候搜、搜什么、读哪些网页、怎么根据搜索结果接着回答,DeepSeek都会自动完成。

再就是语音,这次终于有了官方独立接口。

此前DeepSeek App已支持语音交互,但公开的模型API并没提供同样完整的语音能力。

开发者如果想让DeepSeek助手既能听又能说,一般还得再对接语音识别和语音合成两套服务。

如今这两项能力都能直接走DeepSeek官方接口了。
突发!DeepSeek开放全家桶API(配图 4)

这些底层能力也不是非得整套一起用。

除了打包方案,DeepSeek还单独放出了Search、Fetch、OCR、ASR、TTS等接口,开发者想用哪个挑哪个,也能自行拼装。

V4.1-Flash模型眼下已在Messages、Responses和Chat Completions三类接口下支持相应的对话扩展功能。

说白了,D老师这回把自家App背后那套基础能力,当成积木一样全数交到了开发者手上。

那接下来的问题就是:

能力给得这么齐,价钱怎么算?

语音识别一小时不到4毛,DeepSeek这次还打五折

先看DeepSeek此次晒出的工具API价目表:

突发!DeepSeek开放全家桶API(配图 5)

最吸引眼球的自然是语音。

语音识别原价0.78元/小时,现在直接砍半,只收0.39元。

折算到每分钟约0.0065元,识别一小时录音,4毛钱都用不完。

语音合成同样打五折,原先每万字符3元,眼下为1.5元。

什么概念?

拿国外几家主流厂商的语音API价格来比一比:

OpenAI的GPT-Transcribe,识别一小时音频要0.27美元(约合人民币1.81元)。

价格更低的GPT-4o mini Transcribe也得0.18美元(约合人民币1.21元)。

Google Cloud的标准语音识别服务按0.016美元/分钟计,一小时为0.96美元(约合人民币6.43元)。

这么一比,DeepSeek眼下的0.39元,大约只相当于上述三款服务价格的1/4.6、1/3.1和1/16.5。
突发!DeepSeek开放全家桶API(配图 6)

搜索和网页抓取方面,仍是此前公布的每1000次成功调用5元。

文字识别OCR为每1000页1.5元,平均识别一页0.0015元。

这样看下来,DeepSeek这轮的定价思路并不难懂。

原有的搜索能力继续走低价,新开的语音接口则用五折优惠把使用门槛压下来。

对打算做语音助手、会议记录、文档处理这类应用的开发者而言,起码基础工具的调用成本已经被拉得相当低。

还是那个熟悉的DeepSeek。

另外还有一件事。

公告收尾处,藏了个挺耐人寻味的细节。

DeepSeek在公告最后是这么写的:

在它看来,眼下的对话产品,只能算比较初级的一种形态。

这话放在D老师身上,倒也不让人意外。

比起在C端产品上砸资源,DeepSeek的重心似乎一直压在模型研发这头。

App那边虽然攒下了海量用户,可形态上仍是个大家再熟悉不过的聊天助手。

现在倒好,能力一股脑全放出来,连照着自家App复刻的示例代码都备齐了,意思很像:

模型归我接着啃,应用怎么玩,你们自己琢磨去。

怎么说呢,这一手挺机灵。。。

想想移动互联网那几年,微信、抖音这类超级应用,几乎把人的社交、娱乐、获取信息的方式重新塑了一遍。

到了AI时代,模型越做越强,应用那头的形态却好像没跟上来。

从ChatGPT到DeepSeek,大家最顺手的用法还是老一套:开个聊天框,敲问题,等回复。

可AI的下一款超级应用,真就一定还是聊天框?

眼下没人答得上来。

那与其关起门自己猜,不如把工具摊开,让全球开发者一块儿试。

万一真有人搞出下一个爆款呢?

说到底,D老师搭台,有脑洞你就上。(doge)

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. DeepSeek前端代码现额度管理:Coding Plan要来了?

    IT之家 11 月 14 日消息,有开发者在 chat.deepseek.com 的前端代码中发现了一整套额度管理逻辑,提示文案包括“使用额度已达上限,请额度恢复后再试”。 此外,其代码还包含额度耗尽后的错误处理分支,以及“分享对话后继续聊”场景下对 quotas 数组中 is_exhausted 状态的检查。 根据开

    来源 AI 行业观察
  2. DeepSeek人才为何不创业:顶尖AI扎堆,出走多进大厂

    几乎从未见到DeepSeek走出的创业者。 但这里聚集着大批学历顶尖的年轻AI人才。即便此前有少数员工离开,他们大多数的选择也是加入其他大厂,而并非创业。与这份清冷形成反差,今年几乎是AI大厂人才出走最鼎盛一年,他们离职创业便动辄拿下几十亿估值。 “不诱于誉,不恐于诽,率道而行,端然正己。”DeepSeek今年4月发布

    来源 AI 行业观察
  3. NaiveAI开源模型Naive-N0.5-Flash,获Latent Space首期实测

    梦瑶 发自 凹非寺量子位 | 公众号 QbitAI国产大模型,又杀出一匹黑马!而且这回,还是被硅谷超火的硬核AI技术媒体Latent Space亲自实测出来的。就在11月10日,Latent Space推出全新模型测评栏目,专门做「不带立场」的新模型实测。而栏目首期,其就把目光投向了中国公司NaiveAI的开源模型Na

    来源 腾讯网
  4. AI模型明明算对了,却停不下来反复检查:这个“疑心病”该怎么治

    你有没有过这种经历:一道数学题,你其实在心里已经算出答案了,但还是不放心,又拿起笔重新验算一遍,甚至反复算了三四次,哪怕前几次结果一模一样。现在的AI推理模型,比如Qwen3、DeepSeek-R1这类能够“思考”的大模型,正患上一种类似的毛病。它们在给出答案之前会写一长串思考过程,专业上叫**思维链**思维链:模型在

    来源 腾讯网
  5. 门罗风投报告:美国企业开源模型支出89%流向中国模型

    硅谷知名风险投资机构门罗风投(Menlo Ventures)发布的《2026年企业AI现状报告》显示,美国企业用于开源模型的支出中,89%付给了中国模型。前三名中,Kimi占61%,DeepSeek占15%,GLM占11%。 市场很愿意接受一套简洁叙事:依靠性能与定价,国产大模型抢走海外开发者预算。 但同一份报告里还有

    来源 AI 行业观察
  6. 豆包工作开放第三方模型接入:Kimi K3.1Pro等可选,按倍率计费

    豆包工作11月12日更新,接入多款第三方大模型并推出限时特惠计划。用户在豆包2.1Lite与Pro两款自研模型之外,新增可选Kimi K3.1Pro、GLM5.3、DeepSeek V4.1Flash等模型,选择范围由自研体系扩至外部主流阵容。 因模型使用成本不同,豆包工作在模型选择页面标注各模型的额度消耗倍率,系数越

    来源 AI 开发者社区
  7. DeepSeek-V4等6款模型:Blackwell指纹涉12000块GPU

    2026年11月12日发布的法证报告显示,DeepSeek-V4、Kimi K3等六款中国模型权重初始化痕迹指向NVIDIA Blackwell GPU,涉及约12000块算力资源。此前同实验室旧版模型均匹配Hopper特征。报道从权重可验证硬件痕迹出发,拆解取证机制,分析对评测透明度与管控交叉领域的影响,并给出战略层

    来源 AI 科技快讯
  8. 六款国产AI模型现Blackwell硬件痕迹:约12000块受管制GPU

    2026年11月12日发布的法证报告显示,DeepSeek-V4、Kimi K3等六款中国模型权重初始化痕迹指向NVIDIA Blackwell GPU,涉及约12000块算力资源。此前同实验室旧版模型均匹配Hopper特征。报道从权重可验证硬件痕迹出发,拆解取证机制,分析对评测透明度与管控交叉领域的影响,并给出战略层

    来源 AI 行业观察
  9. 马斯克裁掉xAI多模态团队,同时又挂出同方向招聘

    硅谷这么大瓜,也没耽误马斯克又把麾下一个部门整窝端了。 量子位获悉,老马近期裁撤了xAI的整个multimodal团队,团队约70人无一幸免。 多模态不做了? 但几乎同时,xAI官方招聘立刻上新了“Model Engineer, Multimodal Understanding”岗位,base地在加州Palo Alto

    来源 AI 行业观察
  10. 知驿科技获数千万种子轮融资:AI编程工具11月上线

    北京商报讯(记者 魏蔚 鲁芹)11月13日,知驿科技宣布完成数千万元种子轮融资,本轮融资由卓源亚洲领投。资金将主要用于产品研发、团队建设与市场拓展,加快首款产品上线与验证。据悉,知驿科技首款产品计划于11月中旬正式公开上线。目前,该产品已完成与Claude Code、Codex、Kimi Code、DeepSeek H

    来源 腾讯网
  11. 英伟达两封内部信:克雷斯安抚军心,琼斯确认治理新架构

    【TechWeb】33年创始人时代落幕后的第一夜,英伟达新任领导层用两封内部信,给出了两种截然不同的答卷:一封管情绪,一封管秩序。 据Business Insider获取的备忘录显示,临时CEO科莱特·克雷斯与公司首任董事会主席哈维·琼斯在黄仁勋辞职后第一时间致信全体员工。前者以"亲爱的NVIDIANs"开头,用"我相

    来源 AI 行业观察
  12. 亚马逊云科技推出Continuum:漏洞修复提速,CyberGym-E2E成功率89.0%

    Amazon Continuum:把“发现—排序—验证—修复”跑通今年10月,亚马逊云科技宣布针对代码漏洞的Amazon Continuum正式可用,该服务能够以机器速度发现、优先级排序、验证并修复安全风险。在发现阶段,Continuum分析代码库并形成候选漏洞发现,记录支持每个候选的源代码证据。江学森介绍,Conti

    来源 TechWeb
  13. 亚马逊云科技Continuum:AI攻防提速下漏洞修复如何跑通

    Amazon Continuum:把“发现—排序—验证—修复”跑通今年10月,亚马逊云科技宣布针对代码漏洞的Amazon Continuum正式可用,该服务能够以机器速度发现、优先级排序、验证并修复安全风险。在发现阶段,Continuum分析代码库并形成候选漏洞发现,记录支持每个候选的源代码证据。江学森介绍,Conti

    来源 TechWeb
向下滚动自动加载更多