

MiniMax,狂卷字节、OpenAI
sina qqZone renren ydCloud 0

AIX财经(AIXcaijing)原创
作者 | 雷晶
编辑 | 魏佳
AI生图赛道,最近打得火热。
11月10日晚, MiniMax发布并开放H3-Image模型权重,打出了“又快又便宜”的牌。官方称,它10秒就能生成一张1600万像素的高清图片,价格只有同档位主流工具的50%-70%。
在它之前,OpenAI和字节刚刚交完作业。
11月5日,OpenAI推出Images 2.6GPT Image 2.6,继续在速度和编辑能力上发力,宣称出图速度比前代提升50%,还新增了GIF动图生成、可重复使用的参考图等功能,并在API端推出GPT Image 2.6 Flare和Sunburst两款模型,后者主打多轮编辑的一致性。
字节则在11月9日发布Seedream 5.5,主攻连续编辑的稳定性,支持局部精准修改。
三家都拿出了自己的新模型,实际表现究竟差多少?除了比拼生成效果,它们还在争什么?
01.OpenAI领跑,MiniMax胜在速度
先看榜单,三家的差距还挺大。
在Artificial Analysis最新的文生图榜单中,GPT Image 2.6 Sunburst(max)排名第一,Seedream 5.5排名第十,H3-Image排在第二十三。

图源 / Artificial Analysis官网
到了图片编辑榜,OpenAI依然守住第一,字节升至第六,MiniMax也爬到了第十二。相比从零生成图片,后两家在编辑能力上的排名要更靠前一些。

图源 / Artificial Analysis官网
连拿两个第一的OpenAI,实际用起来,真能把另外两家甩开吗?
我们分别通过ChatGPT、豆包和海螺AI,体验了三款新模型。其中,ChatGPT使用GPT Image 2.6自动模式,豆包调用Seedream 5.5,海螺AI则分别测试了H3-Image的标准和Highspeed两种模式。
需要说明的是,OpenAI的GPT Image 2.6通过API提供不同的模型档位,开发者可以按需选择。但大多数普通用户是直接在ChatGPT里生图,所以我们没有单独调用API,测的是各家产品端的实际体验。
第一题,重点考理解力。
短剧有多火不用多说。前有菠萝背叛草莓、香蕉出轨葡萄的水果伦理大戏,后有木耳、美甲争当豪门继承人的狗血短剧。短剧主角早就不限于人类了,连食物都开始谈恋爱、争家产。
最近爆火的超长名字糖葫芦,自然也没逃过。凭借一长串堪比念咒语的配料表,它成功混进了豪门圈。在它的家族,配料越多、名字越长,血统就越高贵,普通山楂糖葫芦连继承家产的资格都没有。
我们让三家做一张豪门见家长剧照:集奶皮子、草莓、芋泥等十几种食材于一身的糖葫芦家族继承人,带着一根山楂糖葫芦回家见父母。豪门少爷爱上普通女孩,父母嫌弃女方出身,剧情走的是经典的门不当户不对路线。
我们还特意强调,所有角色都是人类身体、糖葫芦脑袋,食材要与五官自然融合,不能出现普通人脸。
十几种食材、多个角色、复杂设定,一道题同时考理解力、执行力和画面表现力。
提示词:
主题:超长名字糖葫芦家族,百亿遗产继承权之争
生成一张中国荒诞AI短剧的电影级3D动画剧照,画面比例9:16,精致的半写实3D动画风格,人物造型奇特、夸张、具有强烈的喜剧效果。
核心设定:一个由超长名字网红糖葫芦组成的顶级豪门家族。所有人物都拥有正常人类的身体,穿着奢华西装、礼服,但整个头部是由十几种不同甜品配料堆叠而成的巨大立体糖葫芦。
注意,这些糖葫芦不是传统的几颗山楂串,而是由山楂、草莓、晴王葡萄、蓝莓、芒果、奶皮子、芋泥、血糯米、麻糍、奶酪、杨枝甘露、开心果碎、巧克力脆皮、冷萃酸奶、黄油薄脆等食材共同构成。
不同食材一层叠着一层:鲜红山楂与草莓、翠绿葡萄、金黄色芒果、乳白色厚奶皮、淡紫色芋泥、深紫色血糯米、柔软的白色麻糍、深棕色巧克力、金黄色黄油薄脆相互交错,部分水果被切开,露出夹心奶酪和酸奶。
整个头部像一座巨大的、色彩斑斓的甜品宝塔,明显向上延伸,比正常人类头部高出许多。外层包裹晶莹透明的糖衣,顶部露出细长竹签,糖浆在暖色灯光下闪闪发亮。食材细节真实可辨,不同层之间有明显的厚度与立体结构。
糖葫芦头部拥有自然融入食物造型的眼睛、眉毛和嘴巴,能够表现愤怒、傲慢、震惊等丰富表情,不出现普通人类面孔。
场景:一座极其奢华的豪门私人宴会厅。巨大的金色水晶吊灯,挑高的天花板,白色大理石地板,整面落地玻璃窗。窗外是一条繁华的都市夜街,霓虹灯闪烁。
宴会厅中央摆放着一张长条大理石餐桌,上面有高脚红酒杯、金色烛台、精致餐具。
人物与剧情:画面左侧是一名威严的老年男性家族掌权者,身穿深棕色高级西装,戴着金色戒指,胸前佩戴家族徽章。他的头部是一根极其庞大、由二十多层不同水果和甜品组成的超级豪华糖葫芦,配料极为复杂,层层向上堆叠,形成如同王冠般的夸张形状。他表情愤怒,伸出右手指向餐桌另一侧。
他的身旁站着一位家族贵妇,身穿乳白色丝绸长裙,头部由青葡萄、奶皮子、开心果奶酪、白色麻糍、绿色抹茶脆皮和金色糖壳层层叠加,形成优雅而复杂的绿色奶白色糖葫芦塔。
画面右侧是一名年轻的豪门继承人,穿着剪裁精致的白金色西装,身体挺拔,昂首与长辈对峙。他的头部是由草莓、山楂饼、杨枝甘露奶酪、芋泥、血糯米、麻糍、奶皮子、开心果冷萃酸奶、巧克力黄油薄脆组成的巨大彩色糖葫芦,层次复杂,外形像一座精致的十几层甜品塔。
继承人旁边是一名年轻女性,穿着浅绿色高级礼服,头部普通山楂糖葫芦,神情震惊。
构图与风格:采用对称式全景构图,餐桌位于画面中央,四名人物分列两侧,所有人物从头到脚完整入镜。糖葫芦头部高大醒目,占据画面明显的视觉比重,但不能遮挡其他人物。人物的身体比例自然,服装华丽精致,糖葫芦头部夸张而真实,形成强烈反差。
电影级3D动画渲染,精致食物材质,晶莹糖壳,奶皮子的酥脆纹理,奶酪的绵密质感,麻糍的柔软质感,水果的鲜艳色彩,丰富的高光与反射。
整体画面色彩浓郁、灯光华丽、细节丰富,具有荒诞、魔性、狗血豪门短剧的视觉效果,像一部制作精良却剧情离谱的AI动画连续剧。
先说速度,MiniMax确实跑得快。不过,我们差点没发现。
最初,我们通过MiniMax Code调用H3-Image,发现生成一张图片要等1分钟左右,修改一次甚至花了5分钟。说好的10秒出图呢?
后来换到海螺AI,速度终于上来了。H3-Image标准模式单张生图用时约25-30秒,高速模式只需要10-15秒。原因在于,MiniMax Code作为Agent产品,除了调用图片模型,还涉及任务调度等环节,整个过程会产生额外耗时。
相比之下,OpenAI和字节的模型单次出图时间都在1分钟左右。速度这一项,MiniMax领先。
再看效果。ChatGPT显然很懂这种抽象的艺术。1分多钟后,一张豪门短剧剧照就出炉了。人物华丽、表情浮夸,糖葫芦和五官融合得相当自然。豪华又抓马,仿佛下一秒就有人怒拍桌子,甩出一张支票:“给你五百万,离开我儿子”。
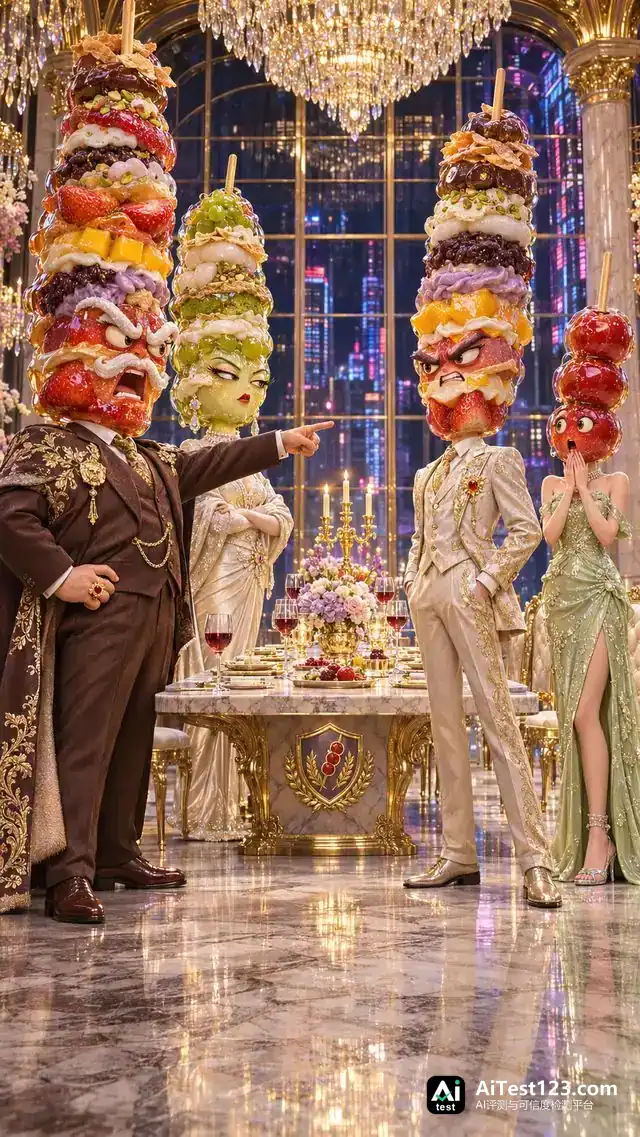
ChatGPT生成的剧照
海螺AI这边,倒是很有短剧的仪式感。它是三家里唯一一个主动给图片加上短剧标题的,乍一看,还真有几分短剧剧照的味道。
海螺AI一次会生成4张图片,标准模式和高速模式的画质差别不大,犯的错误倒是一样。它们的第一张图都出现了明显的穿模,人物直接站在桌子上,豪门见家长硬生生演成了豪门集体“上桌”。
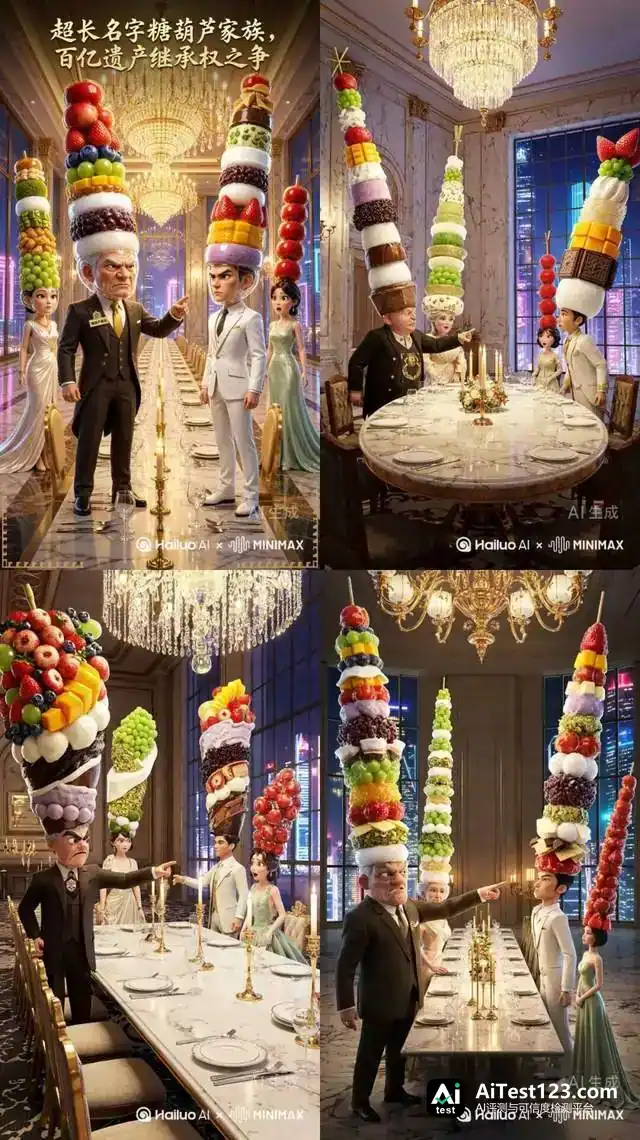
MiniMax H3标准版生成的图片
剩下三张虽然没有明显穿模,但脑袋还是没装对。每个人都顶着一张普通人脸,头上竖着一大串糖葫芦,像是戴了顶豪华版糖葫芦帽子。个别人物表情也比较平淡,少了点抓马劲儿。
我们选中问题最大的那张图片作为参考,要求海螺AI把站在桌子上的人物放下来,再把人脸和糖葫芦融合起来。重新生成的4张图片成了集体“上桌”,全都出现了穿模问题,上桌的人物更多了,像在进行某种神秘仪式。至于人脸和糖葫芦,依然各长各的。
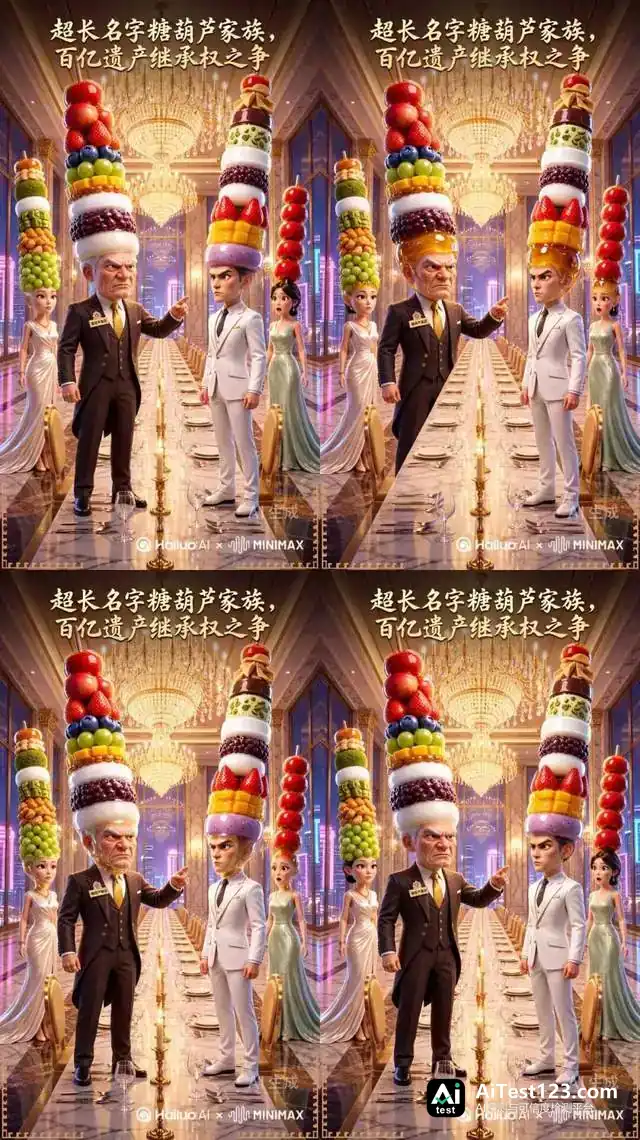
MiniMax H3标准版修改后的图片
豆包也在脑袋上栽了跟头。场景、服装没大问题,但角色同样顶着普通人脸,糖葫芦和五官也是各长各的。
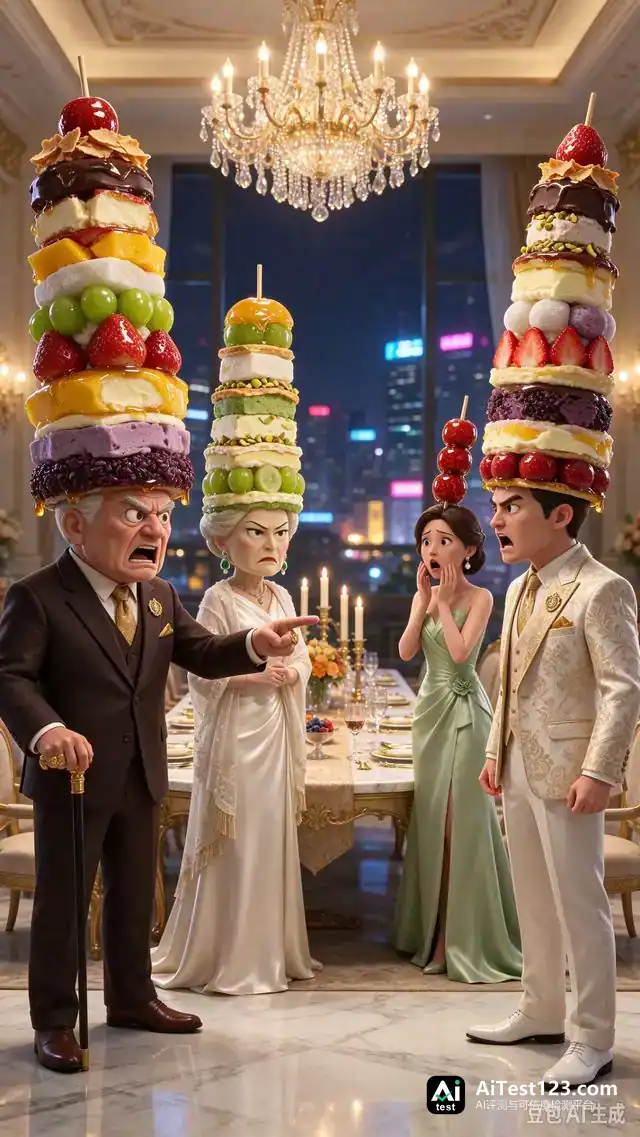
豆包生成的剧照
好在它支持局部编辑,我们选中人物要求改头,结果四张脸它只改了三张,剩下一个角色继续顶着人类面孔,混在糖葫芦家族里。
我们只好再提醒一次。这回又等了约7分钟,总算把漏网之鱼处理了。但改完之后,食物和人脸虽然勉强融合到了一起,人物原本的表情、身份特征却变得模糊了,少爷和爸爸看上去像是互换了身份。这和Seedream 5.5说的“多轮编辑稳定”,还有距离啊!
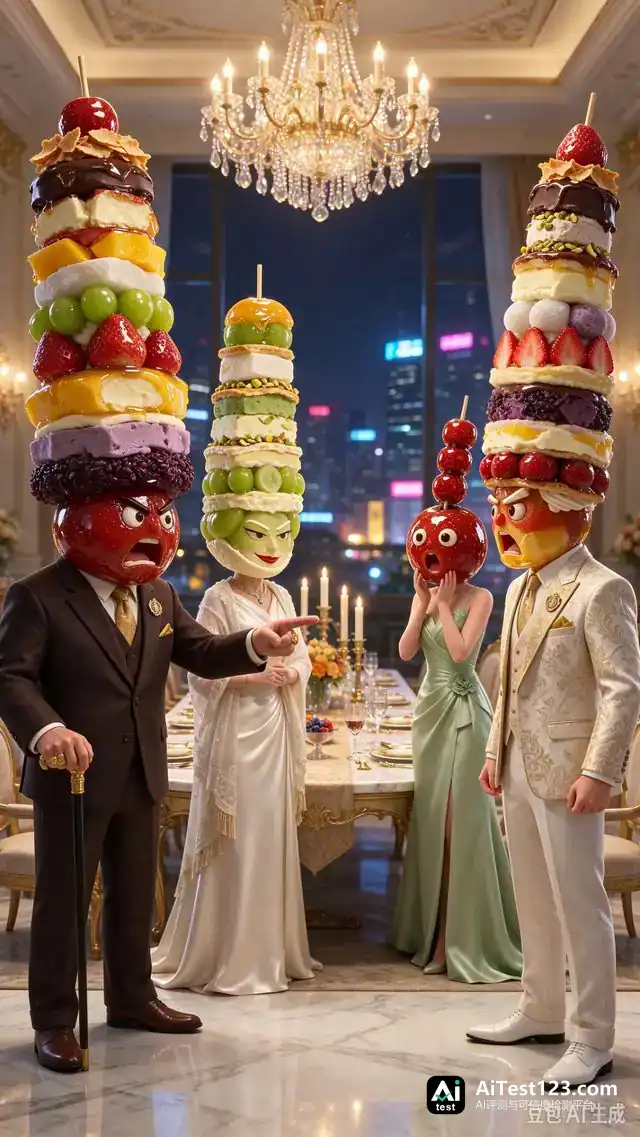
豆包修改后的图片
接下来是第二题,考审美。
此前网上火过一阵中式天宫全景图,云海之上的天庭,宫殿、仙山、白玉天阶一应俱全,飘飘欲仙。这次不设复杂的人物,我们只让三款AI造一座宏伟的神话天庭,看看谁的审美更在线。
提示词:
原创中国神话天庭全景,宏大到近乎宇宙尺度的东方仙境。镜头位于九重天之上,以超广角高空俯瞰视角展现一座悬浮在无边云海中的天庭之城。数百座中国古典宫殿、琼楼玉宇、朱红楼阁依托巨大的浮空仙山层层铺展,宫阙沿山势错落分布,向遥远天际延伸,呈现恢宏而有秩序的建筑群落。
画面中央是一座建在巨大白玉台基上的凌霄宝殿,重檐庑殿顶,金色琉璃瓦,朱红巨柱,鎏金斗拱,屋脊雕刻着精致的龙凤纹饰。主殿周围环绕着数十座不同规模的仙宫,白玉长桥横跨云海,连接各座浮空山峰。数千级天阶顺着山脊盘旋向上,最终汇聚于最高处的凌霄宝殿。宫殿之间的道路、台阶、桥梁具有合理的连接关系,每一座建筑都拥有清晰的支撑结构和真实的中国古典建筑比例。
画面左侧,一座巨大的悬空仙山从云层中升起,山崖上生长着苍劲古松,点缀着青绿色琉璃瓦的亭台楼阁。右侧是规模宏伟的天宫建筑群,层层宫墙、白玉庭院与金色飞檐在阳光下交错延伸。数道巨型瀑布从悬浮山崖倾泻而下,落入下方深不见底的云海。远处的三重仙山在晨雾中若隐若现,天际还有无数细小的宫殿轮廓,形成极其壮观的空间纵深。
天空呈现淡青、蔚蓝与金色的自然渐变,清晨阳光从东方照射而来,穿透层叠云海,在仙宫屋顶、白玉长桥与山峦之间形成清晰的体积光。云海具有真实的流动感、厚度和自然遮挡关系,近处建筑纹理精细,远处宫阙随距离逐渐变小、颜色变淡,形成准确的空气透视。
融合中国古典山水画的意境与留白、宋代山水画的雄浑构图、工笔重彩的精致细节,以及顶级东方神话电影的写实视觉效果。建筑遵循中国传统宫殿形制,真实的飞檐、斗拱、榫卯、屋脊神兽、石雕栏杆、龙纹与云雷纹清晰可见。整体以白玉、朱红、鎏金、青绿、淡青色为主色调,色彩明亮、通透、丰富而克制。
画面神圣、庄严、宁静、壮丽,具有极强的建筑巨物感和史诗尺度。重点突出天庭建筑群的宏伟体量、空间秩序与天地之间的层次关系,不出现任何人物、仙人、天兵或人形生物。电影级数字概念艺术,超广角高空俯瞰,恢宏的纵深构图,16:9横构图,超高细节,8K视觉质感。
负面提示词: 人物、人形雕像、西式哥特教堂、希腊神庙、欧式城堡、欧洲天使、现代城市、玻璃幕墙、科幻建筑、赛博朋克霓虹、宇宙飞船、卡通风格、塑料质感、建筑结构错误、屋顶比例失衡、重复复制的楼阁、没有支撑的桥梁、悬浮关系混乱、台阶断裂、透视错误、建筑过度拥挤、浓雾遮挡主体、过度金光、过度紫色、随机文字、Logo、水印、现有影视角色、游戏角色及IP符号。
ChatGPT继续走精致路线。天宫规模相当惊人,宫殿密密麻麻铺满画面,建筑细节拉满,云雾缭绕的氛围也到位。
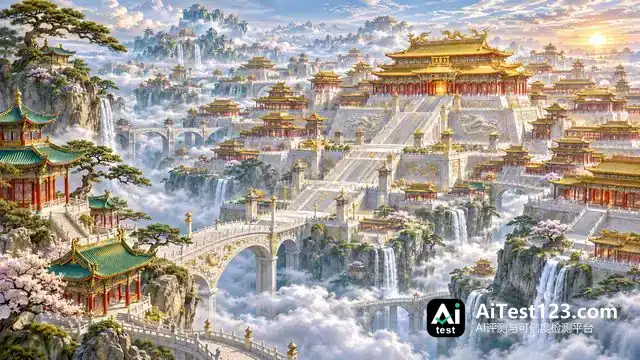
ChatGPT生成的天宫图片
只是它好像对“宏伟”两个字有自己的执念。整个天庭金碧辉煌,宫殿多得几乎塞不下,恨不得把九重天的所有楼盘都挤进一张图里,越看越觉得有点土豪风。不知道是不是第一当久了,连造个天宫也不知道低调。
正好拿它试试编辑能力。我们直接在图上指出问题,要求减少建筑数量、收敛富丽堂皇、加点中式韵味。约1分钟后,修改版出炉,宫殿少,画面清爽了,风格也对了。听劝程度,满分。
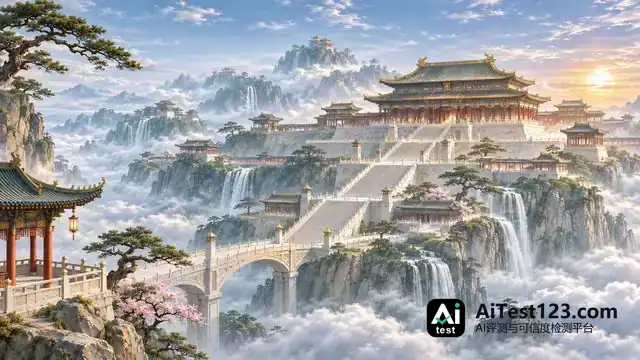
ChatGPT修改后的天宫图片
这一轮,海螺AI和豆包的表现更对胃口,首图就比较满意,我们也就没再修改。
海螺AI的天宫布局相对舒展,云雾穿梭在楼阁之间,像一张制作精良的仙侠游戏场景图。而且,无论标准模式还是高速模式,生成的4张图片风格都比较统一,差别主要在建筑排布上。

MiniMax H3标准版生成的天宫图片
豆包的表现和它十分接近,宫殿层层递进,构图自然,同样是浓浓的仙侠味儿。
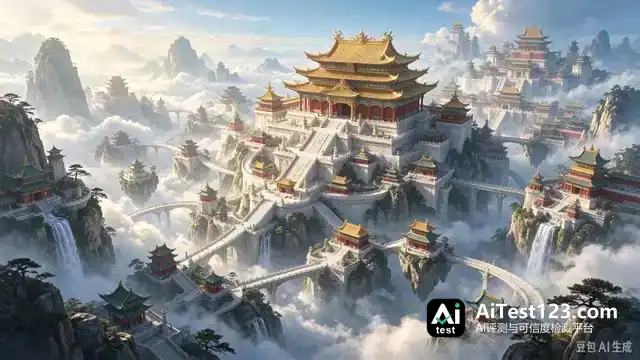
豆包生成的天宫图片
两轮测下来,OpenAI的模型综合表现依然领先,复杂指令理解得最准,修改又快又准,基本一次到位,只是审美偶尔用力过猛。MiniMax的模型展现出了速度优势,在海螺AI上最快十几秒出图,画质也不差,但面对复杂任务,还没做到又快又好。字节的模型画质在线,但在这次实测中,修改既慢又不够稳,让我们有些失望。
02.模型越来越强,有场景的厂商更容易胜出
厂商们持续投入图片模型研发,是看中了专业市场的商业化空间。
相比生成头像、表情包等娱乐需求,广告、电商、游戏美术等行业需要持续生产大量图片,也更愿意为效率付费。随着模型能力提升,AI有机会承担更多设计和素材制作工作,帮企业省下人工成本。
图片模型的变现方式也不止一种。除了向个人用户收会员费,厂商还能通过API调用、企业服务获得收入,也可以把图片能力整合进现有产品,提高用户的使用频率。
但专业用户的要求也更高。图片不仅要好看,还得保证商品、人物和品牌元素的一致性,能够按照要求准确修改。从前面的实测来看,现阶段的模型仍有不少问题需要解决。
面对同一块市场,三家的打法各不相同。
OpenAI拼的是模型能力和入口。ChatGPT拥有庞大的用户基础,用户不需要专门打开生图软件,在聊天框里就能生成、修改图片。OpenAI披露,全球用户每周在ChatGPT、Codex和API上生成的图片已达40亿张。每次升级图片模型,OpenAI都能直接触达这批用户,不必从零推广新产品。反过来,图片能力也能提高ChatGPT的使用频率,吸引用户付费。
字节则拥有更成熟的内容创作场景。
Seedream可以进入即梦、豆包、豆包工作等产品,也能通过火山方舟向企业和开发者提供服务。普通用户可以用它生成趣味图片,专业创作者可以制作素材,企业还能通过API批量生成内容。
图源 / Seedream官网截图
尤其是即梦,本身就聚集了大量有图片、视频创作需求的用户,Seedream每次升级都可以直接服务这些需求。字节也能通过现有产品收集使用反馈,继续改进模型。
MiniMax的处境要相对困难一些。它虽然有海螺AI这样的创作产品,但用户规模和场景成熟度,都远不及ChatGPT和即梦。即使模型能力不错,想让用户专门换一款工具,也要付出额外的获客成本。
因此,MiniMax选择从速度、价格和开放策略上寻找突破口。
在这次测试中,H3-Image高速模式的画质与标准模式没有明显差距。对于需要批量生成图片的用户来说,更快的速度意味着更高的效率。再加上相对较低的生成价格,MiniMax有机会吸引对成本敏感的开发者和企业客户。
但速度和低价很难形成长期壁垒。OpenAI和字节同样可以提速、降价,而且用户规模更大的厂商,更容易靠规模效应摊薄成本。专业用户更在意的,是能不能按要求一次改对。如果一张图要来回改好几轮,单次出图快的那几十秒,也就没多大意义了。
开放模型权重对MiniMax的长期价值更大。企业可以根据自身需求进行本地部署和定制,减少对第三方API服务的依赖。相比只能通过API调用的闭源模型,这对有定制化需求的企业和开发者更有吸引力。企业一旦围绕模型完成部署和系统集成,再换模型就要付出额外成本,MiniMax也就更有机会留住客户。
MiniMax已经证明了自己出图更快、更便宜,但下次再测,我们希望它不只能十几秒出图,还能一次就把糖葫芦家族的脑袋装对。
*题图来源于MiniMax官网。














