

百度世界大会2026:ERNIE 5.5 Flash Preview亮相,孙天祥首秀
sina qqZone renren ydCloud 0
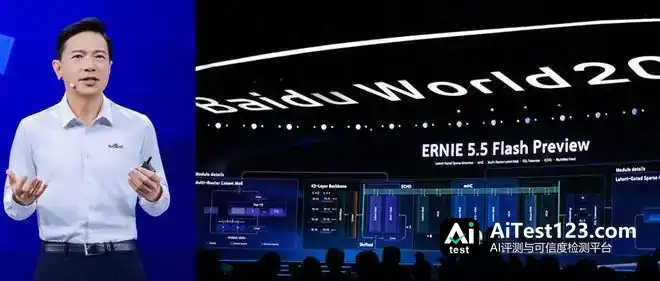
智东西11月12日报道,百度世界大会2026上,百度集中发布了一批基础模型、应用与云基础设施更新。
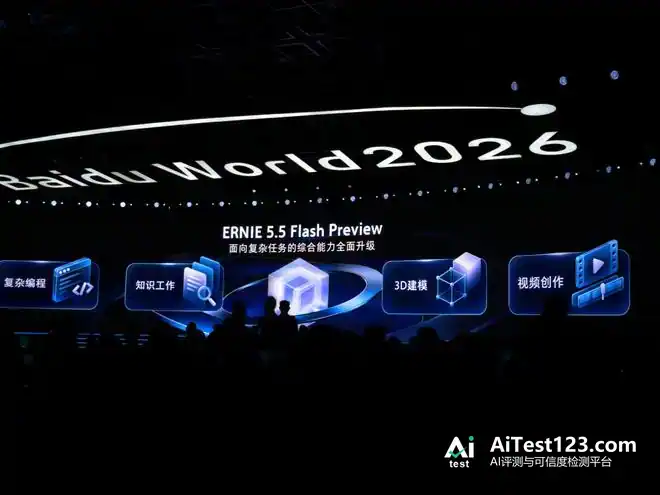
基础模型这边,百度正式推出2800亿参数的ERNIE 5.5 Flash Preview,另有两款文心应用模型同台登场。今年7月加入百度、现为百度基础模型研发部(BMU)负责人的孙天祥首次公开亮相。他说,新发布的ERNIE 5.5 Flash Preview在编程、知识工作、设计创作等能力上做了重点优化。
应用侧,百度搭子、百度库库、百度伐谋、百度一镜等产品均迎来升级。百度的数字人平台百度一镜做了一段数字人希加加与李彦宏对话的视频,希加加在片中提出想替代李彦宏。百度一镜的产品经理透露,短片里的李彦宏既有数字人也有真人。
百度还上线了大模型交易所词元所,把大模型汇聚起来供开发者调用。平台上线一个月,日均调用次数超过5000万,日均调用token超过7000亿个。
云基础设施方面,百度天池1024卡超节点发布,明年推向市场;昆仑芯更新了路线图,M架构芯片今年、明年推向市场,N架构芯片则要等到2028年。
百度创始人、董事长兼CEO李彦宏表示,2016年到2026年这十年,人工智能技术形成了独立的技术栈,百度的“芯云模体”四层架构正是在这十年间逐步成形的。
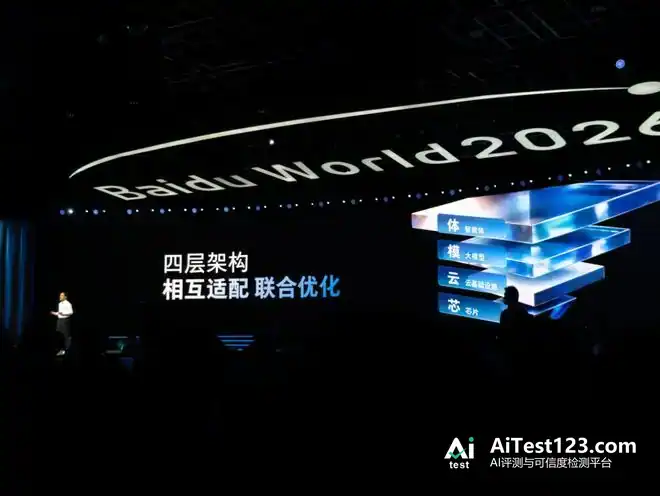
百度内部智能体已经相当活跃。过去一年,智能体数量从0.5万个增至3.7万个,涨了6倍;有效工作任务数从每周8.4万个增至每周超过100万个,涨了11倍;此外还有超4300个Work Space、超2万个组织Skill。

在李彦宏看来,AI的下一幕是智能组织,智能组织相当于AI时代的新厂房,企业得让智能体、数字员工进入业务。
他由此首次提出组织进化的三原则:一是打破岗位边界,释放组织活力;二是沉淀隐性知识,构建组织智能;三是设计流程闭环,推动组织进化。他同时提到,岗位不会消失,但会收敛,未来大致分成两类:创造未来的人(builder)和连接世界的人(seller)。Builder负责创造新东西,Seller管人与人之间的沟通和连接。
联想集团董事长兼CEO杨元庆也来到现场与李彦宏对话。杨元庆说,2024年开始是联想的第五个时代,AI正在变革联想的各项业务。
谈到智能组织,杨元庆认为企业要有总体规划,什么能做、什么不能做,得有边界。他还说,新技术出现时要鼓励大家去实践;他与世界五百强的CIO交流时发现,大家觉得面对一项革命性技术,初期可以先不要太在意投入产出比。
一、95后基础模型负责人亮相,文心最新模型2800亿参数
95后的百度基础模型研发部(BMU)负责人孙天祥,介绍了文心基础模型的新进展。
新发布的ERNIE 5.5 Flash Preview总参数280B,激活参数14B,支持百万上下文。孙天祥说,该模型重点优化了编程、知识工作、设计创作等能力。
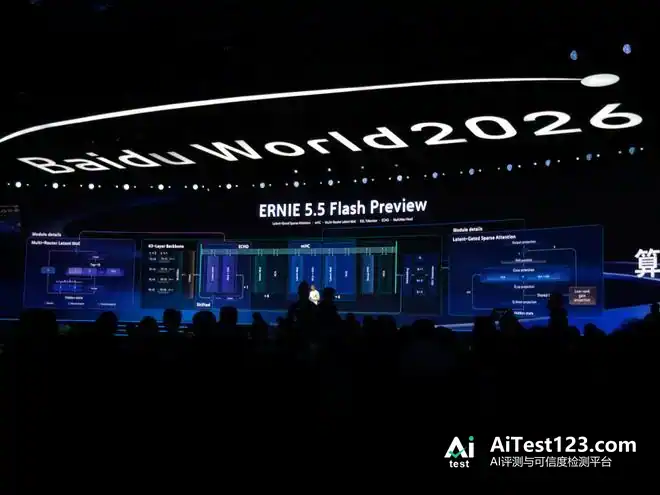
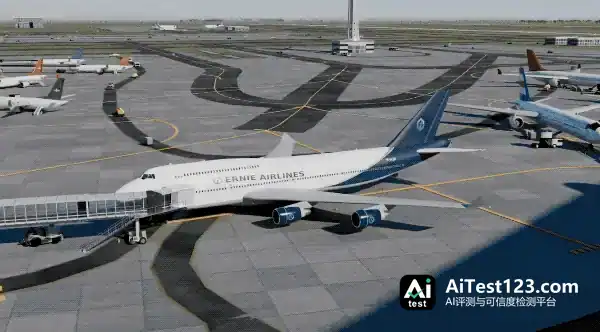
3D建模能力上,ERNIE 5.5 Flash Preview能驱动两个Agent,用Blender Python API分别做出机场和飞机。
鹈鹕骑车这个案例中,ERNIE 5.5 Flash Preview用Python从零写出了一部116秒的2D动画短片:一只白鹈鹕骑着自行车,从公元前4000年的撒哈拉岩画一路骑进大模型时代的代码编辑器,穿越20种艺术风格。
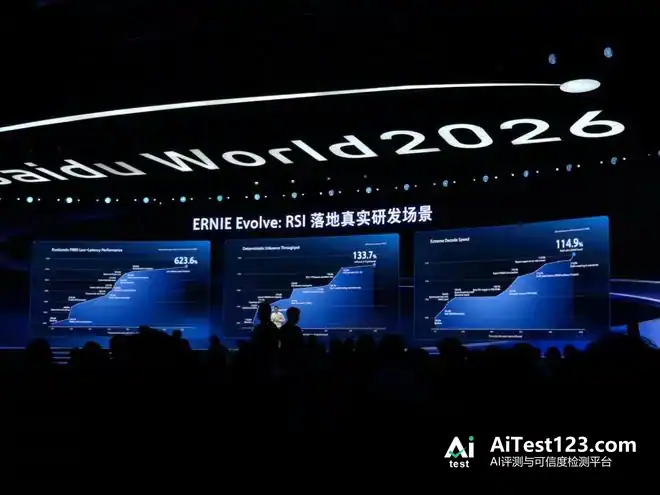
11月10日,百度发布了自动研究系统RENIE Evolve,让RSI在真实研发场景中落地。
确定性推理吞吐优化中,ERNIE Evolve花3天时间,围绕确定性采样、确定性开关及算子并行策略探索了3个方向,把吞吐提升到基线的133.7%;极致解码速度优化中,ERNIE Evolve累计探索7个研究方向,推理性能最终累计提升至基线的114.9%。
二、两大文心应用模型发布,800亿参数闪度思考模型+微表情大模型
李彦宏称,大模型产业正沿两条路径发展,一条向上突破、推高智能上限,一条向下扎根。百度一方面持续投入,研发下一代更前沿的基础大模型,另一方面坚持“模体并行、协同进化”理念,让大模型为应用而优化。
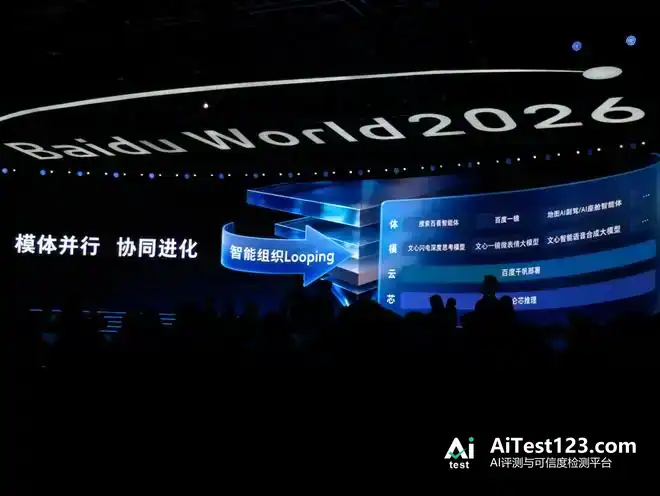
两款文心应用模型正式发布:文心闪电深度思考模型与文心一镜微表情大模型,同步上线百度智能云千帆平台,面向企业客户及合作伙伴开放API服务。
文心闪电深度思考模型有8000亿参数,能理解复杂需求、调用工具,后续版本会支持文本、视觉、语音输入。该模型此前是为了服务百度搜索。
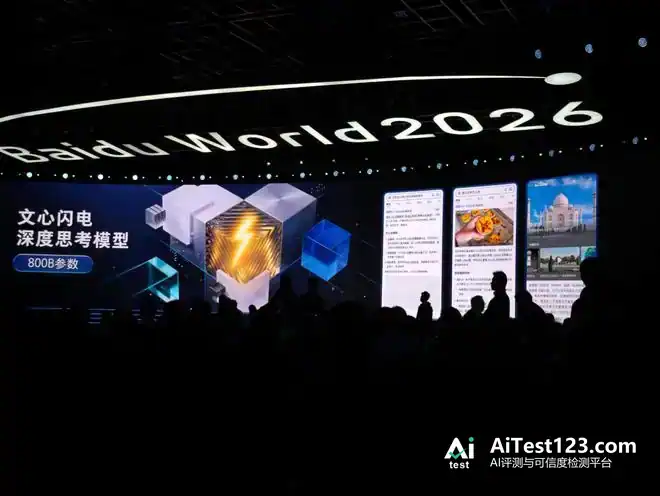
这背后,百度独创了基于反馈式KV压缩的稀疏注意力技术BSA,以及快慢思考模型Looping。
借助BSA注意力机制,该模型在昆仑芯上的ROI较同类芯片高出50%,推理引擎成本则下降了30%。
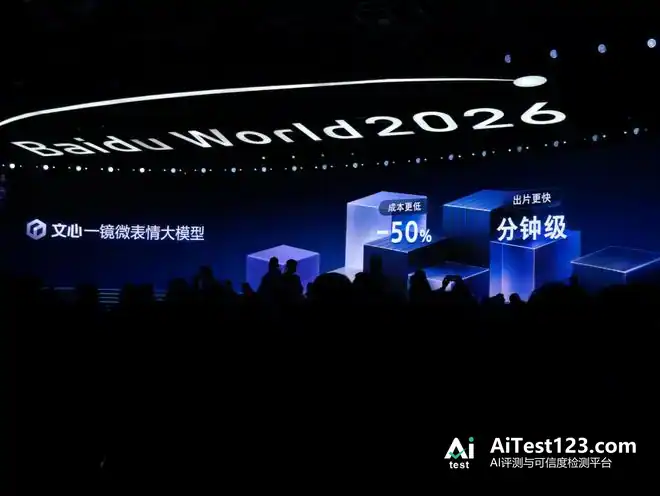
文心一镜微表情大模型是另一款应用模型。它把文本、视觉、语音三种模态统一建模,既能由4000字长文本生成视频,也能用高表现力的长语音来驱动。
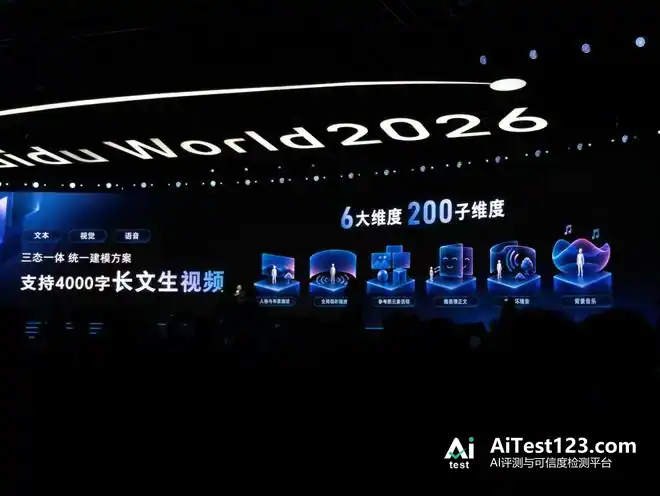
数字人配音要更自然,百度为此做了篇章级配音技术,整部剧的音频可以一次性生成。
价格上,该模型比业内低50%。生成按分钟计,1分钟的视频1分钟就能出片。
三、通用智能体产品矩阵全面升级,视频生成成本低至0.2元/秒
百度搭子、百度库库、百度一镜、百度伐谋均迎来全面升级。
百度搭子定位通用办公智能体。按百度披露的数据,上个季度其用户量爆发式增长;最近半年迭代超过100次,90%的代码和超50%的对外传播物料都由搭子自己生成。
接下来它要走出个人办公提效,转向组织生产力的提升。
作为智能组织的一个入口,百度搭子打通了百度生态的全系能力——用户能通过它调用百度一镜生成数字人视频,也能调用库库创作内容。
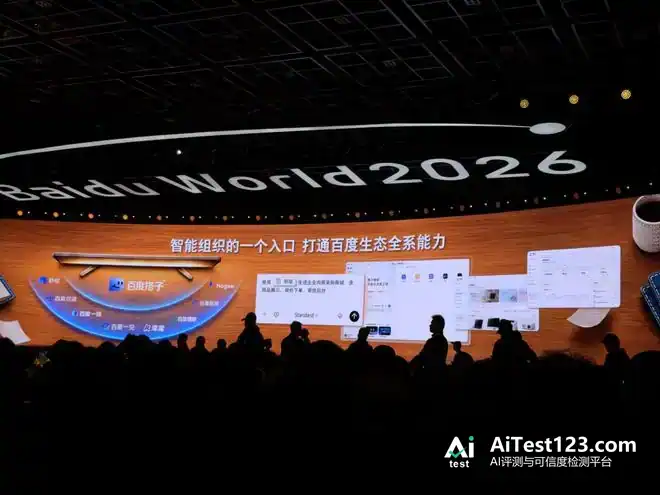
百度还把百度搭子API开放出来,可接入DA、ERP等业务系统。在覆盖七类工作场景、近100个案例的评测中,遇到跨多个系统、操作超过15步的复杂长程任务,它的一次验收通过率由67.6%升到88.2%。
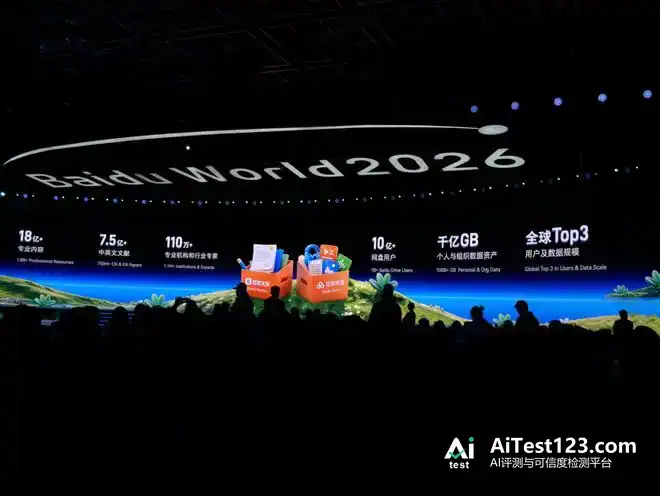
再来看百度的文档与创作平台库库。依靠数据、架构、模型协同进化,它能承接更复杂的任务。背靠百度文库和百度网盘,库库手里有18亿专业知识、7.5亿中英文文献和110万专家。
比如拿网盘里的经营数据做报告,库库产出的报告会引用专业数据、标注数据来源,图表也很丰富。
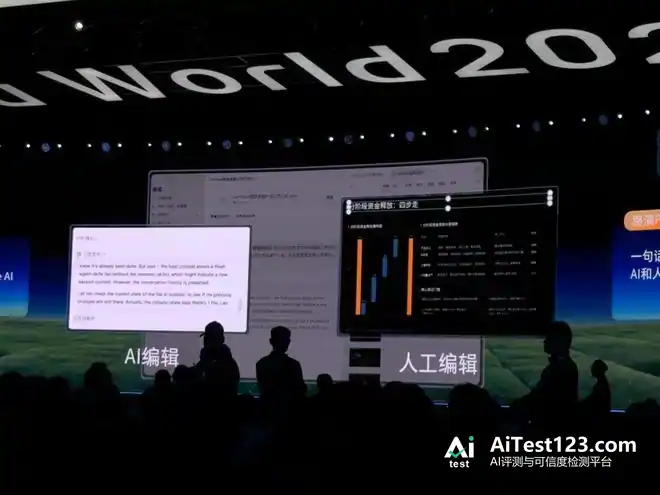
它还能顺着分析结论往下走:做投资路演PPT、搭专业产品官网、定制个性域名。数据在手机和电脑之间实时同步,用户在手机上就能指挥电脑那头的库库干活。
百度一镜是数字人平台。百度升级了数字人实时互动技术,数字人说话时会同步做出点头、挠头这类实时动作。
眼下数字人Agent已能替企业承接业务。数字人演员搭载文心一镜数字人微表情模型,每秒可生成8-9种微表情。
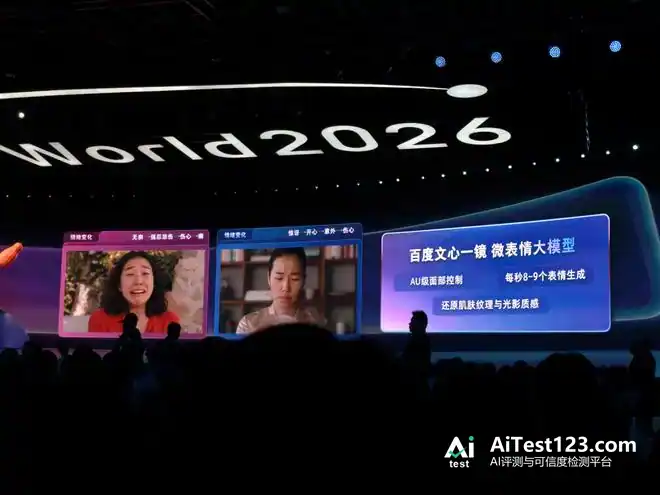
现场百度放了一段数字人演员拍摄的可口可乐广告。片子由百度文心一镜的视频生成模型完成,这种质量的视频成本为0.2元/秒。
百度同时推出短漫剧Studio,把创意、剧本、分镜到成片串成一条一站式链路,用户可据此按题材和情节智能设计景别、运镜与表演。
面向产业研发的核心智能体是百度伐谋。发布至今,其客户已覆盖国内41个工业大类中60%以上的门类。
该工具已升至3.0版本。百度伐谋产品经理表示,百度伐谋要对客户的最终业务结果负责,覆盖企业生成运营、创新研发和经营策略。
大型清洁能源央企中广核借助百度伐谋,在百万级作业条目上开展应用,总工期缩短2个月,人力投入下降29%。
百度还推出大模型交易所词元所,用意是汇聚好模型,让企业和个人更方便地找到可信的token。
词元所会验证模型并持续监测质量。验真指筛选供应商真实性,核验资质与来源,并测试模型性能、可用性和容量;征信指持续监测模型质量参数,平台定期抽检,涵盖服务质量兑现度、商业履约和安全合规。
上线1个月,词元所入驻供应资源超过100个,日均调用次数超5000万,日均调用token超7000亿个。
四、已交付超30个昆仑芯集群,发布百度天池1024卡超节点
智能云跟过去的云计算不一样。要支撑智能体把任务做完,它得拿出算力、模型和运行环境,还得把企业的系统、工具、数据都接进来。
百度集团执行副总裁、百度智能云事业群总裁沈抖给出的数字是:过去一年百度日活跃人数涨了6倍,有效任务数涨了11倍。与之对应,百度智能云沙箱总量增长315倍,沙箱并发量增长60倍。
企业用的智能体大致分三类:通用智能体、专业智能体、定制智能体。前两类拿来就能用,也能接自己的数据。可要让智能体把特定场景的任务干好、把企业的优势用足,就得靠定制智能体。百度搭子开发平台能帮客户做这件事:动态编排子智能体,实时拆解任务、协同执行,任务背景留得住、经验攒得下,还支持skill开发和安装。
蓝海黑石每周都得采购原材料。他们用百度搭子定制了采购执行、采购决策、需求推演几个智能体。以前这项采购工作每周要10个人投入100工时,现在2个人不到1个小时就干完了。
智能体进企业的越来越多,企业也就需要一套基础设施,让这些智能体跑得安全、靠得住、上得了规模。
百度智能云的千帆Agent Infra就是干这个的,给智能体提供稳定安全的运行环境,底下的算力由百度百舸AI Infra撑着。
千帆Agent Infra提供两类服务:一类是千帆MaaS服务,另一类就是前面提到的词元所。
智能体的弹性是脉冲式的。针对这个特点,Agent Infra的沙箱能力做到百万级并发,百毫秒级千并发沙箱热启动。
百度百舸AI Infra的强化学习能力也提升了:分钟级拉起200多万个沙箱,模型RL吞吐5.2万tokens/秒,训推差异低至万分之一。
这些能力背后要有硬件。新一代昆仑芯M100已经上市,基于昆仑芯的天池超节点已在全国多地完成部署,累计为客户交付超30个昆仑芯集群。
百度今天发布天池1024卡超节点,明年推向市场。
该超节点用上光引擎技术,全光互联让1024卡高效协同计算,推理性能提升3倍;G1.5显存加速柜则用来提升缓存服务器的带宽。缓存命中的多轮对话场景下,首Token等待时间缩短90%。
一套1024卡超节点能支持5万亿参数模型训练。百度还在加速建设吉瓦级AIDC,让这些超节点和集群更快为企业提供算力服务。
五、昆仑芯路线图更新,N架构芯片2028年推向市场
李彦宏判断,眼下AI算力需求是训练和推理并重,推理这块国产AI芯片适配性强、有竞争力。
算力需求本身也在变:存储能力越来越吃重,场景分工在细化,算法与半导体周期失衡,逼着架构层面做系统级创新。昆仑芯研发副总裁漆维说,将来任何一个任务都能按需从全网调取计算、存储、处理器资源,再以微秒级网络延迟把它们连成一颗新的AI计算超级大脑。
漆维表示,昆仑芯会保持高强度研发投入,力争每年都推出性能与投资成本兼顾的产品。路线图显示,今年和明年基于M架构的两颗芯片要推向市场:M100主打性价比,M300在计算、存储、互联上全面升级。昆仑芯用开源大模型做了测评,低毫秒时延下M300单卡吞吐比T800提升6倍,6ms延时下提升10倍。
到2028年,昆仑芯要把基于N架构的多颗芯片推向市场,匹配不同场景。
结语:AI竞争重心转向,要帮企业跑通智能体落地
从百度这一轮更新看,它正沿着让智能体规模化跑起来这条路走。业界需要低成本、高密度的算力底座,这次发布的天池1024卡超节点、昆仑芯M/N架构芯片路线图,就是为海量智能体并发运行、长周期任务调度、持续的知识库检索推理备好的硬件底座。
AI的竞争已经不止于大模型。单靠模型优势不再是企业的护城河,能不能帮企业稳妥完成组织流程改造、可控地试错迭代,才是拉开差距的关键。








