

Fractile融资7亿美元:目标把AI推理速度提到100倍
AI的推理计算将在未来几年内成为AI最重要的计算需求,已经逐渐成为共识。 推理计算,拆解开来有两个重要维度,成本和时间。 其中提升推理速度带来的好处,在AI逐渐Agent化的时代,重要性凸显。 具体来说,在相同成本下提升推理速度,能让那些耗时长、推理强度高的Agent任务在更短时间内完成,从而提高整个系统的效率。 Fr
AI推理计算将在未来几年成为AI最重要的计算需求,这一点已逐渐成为共识。
拆开看,推理计算有两个重要维度:成本和时间。
到了AI逐渐Agent化的时代,提升推理速度带来的好处更显重要。
具体来说,成本不变而推理速度提升,那些耗时长、推理强度高的Agent任务就能在更短时间内完成,整个系统的效率也随之提高。
Fractile是一家全栈AI推理公司,想从零构建AI的底层推理技术,打破推理计算在“成本与延迟”之间的帕累托前沿限制。
它初步定下的目标,是把AI推理速度提到现有硬件的100倍,同时把成本压到十分之一。
近日据媒体报道,Fractile完成新一轮约7亿美元融资,Lightspeed和Redpoint领投,Thrive Capital参与投资,估值由此前的10亿美元升至65亿美元。
2026年5月,它刚拿到2.2亿美元的B轮融资,由Accel、Factorial Funds以及Founders Fund联合领投,Conviction、Gigascale、O1A、Felicis、Buckley Ventures和8VC等机构也参与其中。
更早之前,Intel前CEO Pat Gelsinger也投资了这家公司。
另据彭博社报道,Anthropic已向Fractile下达一份价值2.5亿美元的初步芯片订单。
Agent运行速度卡在内存带宽上,Fractile选择押注“存内计算”
如今的先进AI系统有个典型特征:推理阶段投入的算力规模,与模型性能之间存在正相关关系。
Agent时代到来,再加上这个特征,很多科学和数学上的推导与突破,便能在AI辅助下完成,或者由AI独立完成。
这类高价值任务,消耗的token往往达到数千万甚至上亿。可现在的顶级模型体量庞大,推理计算资源又短缺,推理速度通常只有30-40token/s,做完这种长程任务可能要数周,算上中间反馈和调整的时间还要更久。
这样一来,卡住前沿模型能力释放的关键,就落在了从下达指令到产出结果所花的时间上。放到产业层面看,推理计算一边是 AI 行业的收入来源,一边又是其规模扩张绕不开的最大限制。
AI推理的技术栈里,整个计算过程高度受限于内存性能,尤其是内存带宽。一旦突破这一限制,把前沿模型的生成速度从30-40token/s提到1200token/s,以往耗时一个月的工作就能压缩到1天之内。
AI推理硬件领域的公司,通常面临两条技术路径。第一条是专用化,盯住极其特定的工作负载,打造专门适配这些需求的芯片。问题是AI领域的模型架构演进极快,芯片的设计、验证、流片制造与测试却要耗费漫长的时间,这条路充满不确定性。
第二条是从根本上改变计算操作的执行方式,用新的底层模块重新设计芯片架构,再在此基础上搭建可大规模扩展的系统。
Fractile选的正是这条路径。其研发工作贯穿了从基础AI研究、晶圆代工工艺创新到芯片微架构的全栈技术链条。
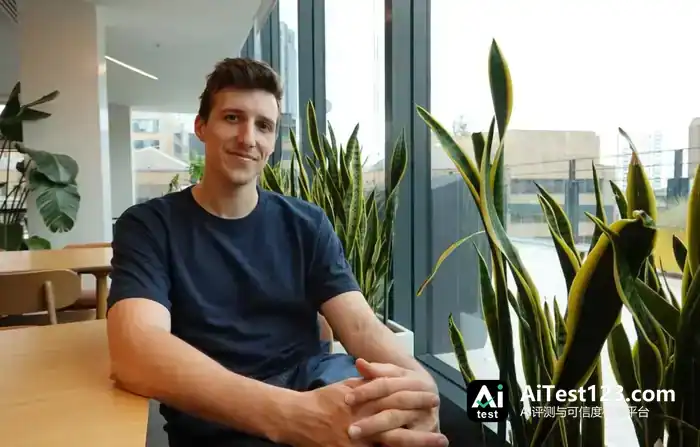
Fractile创始人Walter Goodwin,图片来源:Fractile
Fractile由Walter Goodwin在2022年创立,当时他只有26岁,刚从牛津大学AI与机器人学博士毕业。
读博那几年,他的研究重心是用预训练的视觉与语言模型,做出能适应新任务的通用机器人。干着干着,他慢慢形成了一个判断:AI 会从一大堆专用模型收敛到少数大型通用模型;随之而来的疑问是,这些模型一旦要被大规模、高频次调用,现有硬件撑不撑得住推理这一环。
目前,Fractile的核心高管主要来自NVIDIA、Graphcore、Imagination、Intel和Meta等企业。
具体分工上,前NVIDIA移动业务副总裁Pete Hughes负责硬件,来自Graphcore的原首席处理器架构师Alan Alexander和芯片副总裁Phil Horsfield分别负责架构与芯片。原Imagination软件工程副总裁Chris Smith管理软件团队,前Meta连接业务副总裁Dan Rabinovitsj和前英特尔代工服务(IFS)负责人Stuart Pann则分别主管系统工程与供应链。
关于底层芯片,Fractile还没有把细节全部摊开,但已经能确认其走的是存内计算(in-memory compute)路线。模型参数不必在内存和处理器芯片之间反复搬运,计算操作直接嵌进内存里完成。
好处有两层:GPU眼下最头疼的内存瓶颈(内存带宽尤甚)可以被绕开,功耗也跟着大幅下降。
做存内计算的公司不止它一家,不过多数把芯片放在低功耗边缘设备上。敢把这项技术往数据中心级负载上推的企业,Fractile算极少数之一。
具体到内存方案,Fractile中途改过一次方向——从SRAM转向DRAM。
早期它的芯片和Groq、Cerebras的思路相近,以SRAM为主。SRAM能和逻辑电路做在同一块硅片上,计算单元与存放模型权重、KV缓存的存储单元之间带宽极高,足以撑起每秒数千个token的生成速度。
问题出在模型参数往数万亿规模走、上下文越拉越长之后,这套架构就渐渐顶不住了。
Fractile的判断是,高速推理真正能带来质变的场景是支撑长时间运行的Agent。现有高速推理芯片带宽虽高,内存容量却偏小,部署时没法独立跑长上下文注意力机制,碰上这类计算还得退回GPU。放到数据中心规模上看,推理的经济性归根结底取决于每GB内存的成本。
于是Fractile不再死磕SRAM,转而与内存供应商、晶圆代工厂深度合作,把DRAM直接三维堆叠到处理器逻辑芯片上方,用低成本DRAM换来远超传统HBM的带宽。GPU那种大容量、低成本DRAM的可扩展性,就此和Groq、Cerebras的速度优势拼到了一起。
芯片研发环节,Fractile也把AI拉了进来,靠递归自我改进(RSI)压缩周期。
传统布局布线工具跑一次动辄好几天。他们的做法是双线并行:一边用模糊布局这类近似算法加快前期测试,一边在启动昂贵的版图实验之前,先砸大量推理算力让模型把方案推演透彻,少做无用功。多个备选方案得以同时推进,从捕捉模型趋势到敲定量产的时间差被缩短。
商业化量产芯片目前还没正式推出。转向DRAM堆叠方案后,模拟与测试结果显示其推理速度可达现有GPU的10到25倍,成本优势仍保持在十分之一。按计划,该计算平台2027年下半年开始量产爬坡。
AI推理的产业竞争不再只是造一颗芯片
训练模型比的是有限时间里能算多少,过去主要看峰值算力。推理不一样,Agent场景尤其如此,更在意单个任务多久能完成。
Agent的流程是推理、调用工具、拿到结果再接着推理,前一步的延迟会一路往后累加。到了Decode阶段,每生成一个token都要反复读取模型权重和不断变大的KV缓存,数据送不过来,计算单元再强也只能干等。
过去20年,芯片浮点算力涨了约100万倍,内存带宽却只涨了约40倍。把长期落后的内存带宽补上来,达到同等智能水平所需的算力消耗反而会减少,模型整体吞吐量能成倍往上走。长上下文和长链条任务越来越多,竞争重点也就从单纯堆算力,转向提高内存带宽、减少数据搬运、压低单token延迟。
眼下几条主流路线其实都在解同一道题:内存容量要够大,数据读取速度要够高,怎么两头兼顾。
NVIDIA拿到Groq技术授权后走的是异构路线。Vera Rubin GPU配合HBM负责Prefill、存大容量KV缓存并计算Attention;Groq 3 LPX把模型权重放进高速片上SRAM,承担对延迟更敏感的FFN和MoE计算。一次推理由两种芯片合力完成。
Cerebras的做法是把大量SRAM和计算核心直接做到晶圆级芯片上,用巨大的片上带宽减少数据进出芯片。Fractile则站在存内计算之上,从早先的SRAM方案转向低成本DRAM与逻辑芯片的紧密堆叠。
国内也有入局者,寅谱计算走的是计算与存储协同路线,把AI SSD与近存计算芯片结合起来,用成本更低的存储资源减轻显存与内存压力,解决I/O瓶颈。
这些路线背后要权衡的东西始终没变:带宽、容量、成本、灵活性。
推理正在长成一套独立的基础设施产业,衡量标准从峰值算力换成了响应速度、单位推理成本、能耗和持续服务能力。
Agent、长上下文和各类模型的涌现,让一套通用GPU系统很难再覆盖所有场景,芯片、内存、网络和软件开始按不同工作负载重新搭配。大模型公司和云厂商会更深地介入芯片设计,硬件厂商则往机架、网络和软件栈延伸,产业竞争的单位正从单颗芯片扩大到整套推理系统。
这种变化落到产业链上,会带出几类新的机会。
芯片侧,针对特定推理任务优化的处理器会继续冒出来,围绕内存、先进封装和互连也会长出新公司。基础设施侧,需要新的软件把不同芯片、不同内存和机群组织起来,提高利用率、压低推理成本。服务侧,独立推理云可能更多,面向特定模型和行业的算力平台同样有机会。
把眼光放远一些,推理速度往上走、成本继续往下掉之后,眼下那些卡在速度不够快、或者花费太高压根跑不起来的Agent和实时AI产品,也会慢慢变得能做生意。















