Jeff Dean谈Discovery Loop:AI能加速科学,但不会无限自我改进
在斯坦福HAI的闭幕主题演讲中,Jeff Dean介绍了他离开Google后参与创立的新公司Discovery Loop。它的使命是构建能自动解决机器学习、科学和工程重要问题的AI系统:提出实验、运行实验、评估结果、决定下一步,并让每一轮实验反哺下一轮。随后,李飞飞与Jeff Dean围绕“自我改进”与“递归自我改进”
在斯坦福HAI的闭幕主题演讲上,Jeff Dean讲了他离开Google后参与创立的新公司Discovery  Loop。这家公司的使命,是造出能自动解决机器学习、科学和工程重要问题的AI系统:提出实验、跑实验、评估结果、定下一步,让每一轮实验都为下一轮提供信息。演讲之后,李飞飞与Jeff Dean聊了几个话题:自我改进和递归自我改进差在哪,AI解数学难题带来的冲击,Transformer的起点,技术预测哪些对了哪些错了,还有这一代年轻人面对AI时的焦虑。
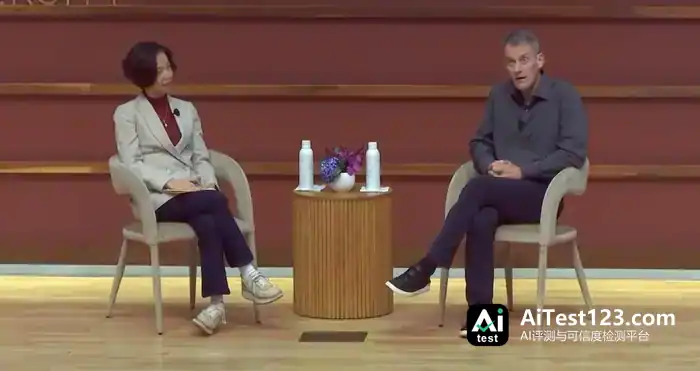
以下是他们的对话实录:
李飞飞:先说说Discovery Loop。为什么现在要成立这样一家公司?
Jeff Dean:我们想做出能自行完成机器学习、科学和工程中重要问题的AI系统。他相信,这最终会让世界多出许多新发现。不少学科都跑着同一套循环:先提出实验,再实施并运行,接着看结果、做测量,然后定下一步,多数时候就是再做一次实验。这类实验循环,正是我们想自动化的对象。假如迭代时间能压短,实验可以自动提出、大批运行,每次评估都学到东西、让后面的实验做得更好,实验的质量和数量又一起上去,突破性结果就有可能出来。
李飞飞:为什么把它做成一家独立的公益性公司?
Jeff Dean:在他看来,技术只要做对了,给世界带来的正面影响会大得惊人;可这种影响要真的发生,得靠所有人都去推动。公司因此注册成公益性公司,公共使命有两条:开发能解决重要社会问题的技术,让技术的好处被广泛拿到手,把人们的生活改善。
李飞飞:团队呢?
Jeff Dean:我有三位很棒的联合创始人:Quoc Le、Sanjay Ghemawat和Oriol Vinyals。我们彼此合作了大约14到30年,喜欢一起解决难题。我们参与过Google搜索、广告系统、Gmail、新闻、翻译、大规模机器学习基础设施、TPU、模型蒸馏、MoE、神经架构搜索,也参与过AlphaChip、AlphaFold、神经天气预报等项目。我们还管理过大规模团队:我管理过Google Brain到600人,后来Google Research和AI团队约4400人。但后来我发现自己花很多时间在Q2运营支出会议上,就决定换一种方式。我们也很自豪,很多团队成员后来参与创办了Anthropic、OpenAI、Physical Intelligence等。
李飞飞:为什么是现在?是什么技术条件成熟了?
Jeff Dean:这10到15年里,硬件层面提升很大,TPU、GPU和更专用的硬件都在往前走;软件抽象也做得更好,映射到硬件上更高效;模型架构一路从word2vec、seq2seq、Transformer改到MoE;训练算法同样在进步,蒸馏就能产出高质量的小模型;推理算法也没落下,推理时多给计算、用思维链、多试几次再检查,结果会更好。可光有好的基础模型不够。还得有agent加模型,能真正把工具用起来、把复杂任务办成,尤其要擅长创造:不是把做过的事再做一遍,而是把许多洞见拼起来,提出真正新的东西,再去验证它管不管用。agent和模型还该从以往的实验和经验里学,比如解决过5000个问题之后,能从最相关的那些问题里吸取东西。
李飞飞:传统实验循环的瓶颈在哪里?
Jeff Dean:传统循环的每个阶段都压着大量人工。问题一大,还得拆成子问题,而拆本身就很麻烦;每个子问题都有很多人做实验、试不同路子,协调开销不小,资源冲突、系统效应也跟着冒出来。更麻烦的是,大项目一旦开跑,早期那套拆法就很难再动。他们设想的是:少量领域专家,配上能自动拆出有意思的子问题、再自动把这些子问题解决掉的系统;人可以引导拆分、点出重要的子问题,让小团队去啃影响大的部分。前提是基础设施得对:成千上万个自动实验,系统要能判断跑这个实验和跑那个实验各值多少,用强化学习或进化算法自动做决策,让早期决策能被更灵活地回头重看,每个早期实验都能给未来的实验提供信息。
李飞飞:公司成立以来做了什么?
Jeff Dean:前三周做了400场面试,很多在University Avenue的Cafe Venetia,找优秀的人;找办公空间,现在在旧的Zibibbo餐厅;搭了自己的agent harness,用于所有开发和自动化。它有协作功能:你可以和模型对话、让它解决问题,也可以邀请队友一起和模型、agent协作,别人可以评论或向agent提设计方案。我们搭的是agent-first基础设施,目标扩展到数万、数十万agent做事,而不是几百个人做事。我们大约有20个自动改进循环在运行,评估如何让实验迭代更有效、更快,如何从之前结果中学习。
李飞飞:你们先聚焦哪些领域?
Jeff Dean:先盯住那些整个循环都能在数字形式里跑完的科学和工程问题,这类最容易加速。物理过程会把循环拖慢,有些领域得用混合办法。眼下的重点是机器学习研究、机器学习工程本身,还有硬件设计。这三块他们有专长,也能带动别的东西。比如医疗健康,要是有系统能自动搞定机器学习工程任务,就可以把它指向健康、材料科学这类问题,要一个针对特定任务的模型。这算自我改进,但不是递归自我改进。医疗是长期的重要方向,只是现阶段先做数字循环最成熟的那几块。
李飞飞:那就把“自我改进”和“递归自我改进”说清楚。很多人把它们混着用。
Jeff Dean:所谓自我改进系统,就是你给系统一个目标,通常带可衡量的指标,比如模型准确率;系统去试不同的模型架构,把准确率提上来。很多机器学习算法都能这么干,可这本身并不递归。举个例子,给它大量MRI数据和结果,让它开发一个解释MRI图像的模型,系统会自动试各种方法,看准确率有没有涨。但那个“下一步该试什么”的基础系统,并没有被改进。递归自我改进说的是:你能不能拿这种自我改进的办法,去改进那个负责提改进建议的基础系统本身。

李飞飞:但RSI被炒得很厉害,好像可以无限加速。物理限制在哪里?
Jeff Dean 说,人提升模型能力的办法,是让有本事的科研人员和 ML 工程师扎堆做大量小规模实验,看哪些想法管用、哪些不管用,再把管用的塞进下一代模型。Gemini 2 接着 Gemini 1 就是这么来的。自动化能把这个过程踩快一点:人跑一个实验,凌晨 2 点结束,可能到早上 8 点才去看结果;自动系统看结果、定下一步会更快,在整个大项目层面也可能做出更好的决策。可要造出更好的基础模型,训练和实验一样都少不了,得跑计算、看结果、存数据,再让另一个模型看了结果去决定下一步。这事儿快不到没边,物理过程摆在那儿。自动化会提高改进的速度,但循环不会无限加速。把它当成一个务实的工程系统来看,就没那么吓人,也更好懂。
李飞飞追问:人本身算自我改进系统,还是 RSI 系统?她拿学做煎蛋打比方。
Jeff Dean 认为人两样都是。一辈子学到很多东西,这是自我改进;人也学会了“如何学习”。学会如何学习,才能更快学到更多,前提是你清楚哪些知识、哪种信息呈现方式最容易被自己掌握。这更接近递归自我改进。递归自学习和递归自我改进,也可能跟进化算法扯上关系。
李飞飞提到,最近几周 AI 在数学上动静很大,从 Navier-Stokes 相关的工作到更多刚发布的论文。数学是百年、千年人类智慧的顶点,数学家不光看技术解法,也看美感。她问 Jeff Dean 怎么看这种冲击。
Jeff Dean 回应,模型加上能高度并行调用模型的 agent 系统,确实能啃下非常难的未解数学问题,这也让人看到眼下什么是可能的。很多人心里不舒服,是因为这些证明往往是 500 页 Lean 代码,机器能检查,但没人真正理解通往结果的那条优雅简单路径。知道问题被证明或证伪是好事,可数学家常常在解题过程中发展出优雅技术,这些技术会生出新的数学,用到别的问题上。优雅解法往往带来可复用的巧妙技术,而在很长的机器生成证明里,人们未必看得到这种清晰优雅的技术。不过,知道某件事可解,在很多领域会让人更努力,知道自己能做到,然后可能换个不同、更优雅的方式做到。所以一边是这么多问题同时被解决确实令人不安,另一边这已经成为可能,人们要琢磨怎么用这种能力做更多数学。
李飞飞抛出一道突击测验:2017年6月12日有什么意义?
Jeff Dean 反问,那是 Transformer 论文上 arXiv 的日子吗?
李飞飞说对,A+。她又问,你6月12日读了吗?
Jeff Dean 答没有,大概是6月10日读的。
李飞飞请他从这个起点回看近十年,说说个人最重要的技术时刻是什么,哪些预测对了,哪些错了。
Jeff Dean 点了几件事。Transformer 显然是更高效的模型架构:把经历过的所有状态都存下来并对其做 attention,而不是拿一个小向量不断更新、忘掉之前的状态。这让模型用少得多的计算学到更多。蒸馏也很关键,他和 Jeff Hinton、Oriol 做的工作2016年被 NeurIPS 拒了,说不太可能有影响,他们放到 arXiv,后来引用很多。它让你用大模型当老师,教轻量学生模型,做出推理高效的模型。MoE 也被证明很好。他预测错的一点是:本以为 MoE 会走向更狂野、更异质、更像有机神经网络的架构,有神经活动列、偶尔的大跨连接;实际 MoE 仍很规整,专家大小相同、马上汇合。神经架构搜索出来的模型看起来比人设计的更有机,比如连到上面17层、做奇怪连接,但他们还没走到他预想的那种野生态。另一个没充分预见的是编程能力:它成了模型解决多种问题的关键解锁器。他们在 Gemini 里重视它,但没想到如此深刻。
李飞飞说,在 HAI 必须谈“H”。AI 的社会影响、就业、心理焦虑、人类灭绝讨论、对齐,她问 Jeff Dean 最担心什么。
在 Jeff Dean 看来,这项技术极其强大、适用面极广,社会生活的几乎每个角落都会被它触及——数学、编程、生成图像、自动驾驶,无一例外。过去的技术革命,波及范围往往比较窄;这一次却同时冲击许多领域。兴奋也好,忧虑、恐惧也罢,各种情绪都在。他曾参与撰写《塑造AI对数十亿人的影响》,书中考察了就业与经济、AI for science、错误信息与虚假信息、媒体等七个方向,也与不少领域专家做过交流。他自己最放不下的,是怎么在各个领域尽量把 AI 带来的上行收益拿到手,同时把下行伤害压到最低。这可不只是技术层面的问题,监管者、政策制定者和普通公民同样置身其中。所有人都得琢磨怎么驾驭新技术,让它服务所有人,而不是以可以预见的方式伤到人。比方说,当人们的工作受到冲击时,得有一条好路子帮他们适应世界的新需求,拿到有报酬的工作,过上繁荣的生活。这事牵涉面很广,需要很多人一起出力。
李飞飞抛出最后一个问题。这一代大学生很焦虑,连斯坦福学生也担心工作和经济未来。她问,作为 AI 先驱,你想对台下既焦虑又怀有希望的学生说什么?
Jeff Dean 表示,这种焦虑他完全能理解:世界变得太快,要为飞速变化的未来做规划,本来就很难。他给出的总体建议是:先试着弄清楚哪些新技术正在冒头、或者很快就会出现,然后确保自己学会把这种技术用在你最有热情的事情上。那件事可能是当医生,可能是写作,也可能是更高效地写软件。AI 能辅助这些事、给这些事添一把力,但人的因素始终在场:我们 collectively 想做什么,终究要由人来定。你该想明白自己要做什么,然后尽其所能做到最好——这就意味着,把眼下能用的工具全都用上。哪怕到了 AI 时代,人类的激情依然恒久。
李飞飞:谢谢Jeff。
Jeff Dean:谢谢。
结 语
这场对话的关键,并不在“AI 会不会取代科学家”,而在于 AI 正将科学发现本身转化为一个能够工程化的循环。Discovery Loop 的野心,是让少数领域专家依托自动化实验循环,去啃下那些过去要靠大量人力才能推进的大问题。不过 Jeff Dean 也划出了一条清醒的界线:自动化会带来加速,但不会无止境地加速;递归自我改进值得研究,却不该被炒成没有物理成本的魔法。对科研机构和创业者而言,真正的机会不在追逐“RSI”这个口号,而在把某一领域的实验循环数字化、自动化、可迭代。至于年轻学生,他的建议朴素却管用:搞懂新技术,做你热爱的事,把所有工具都用上。