

CoRL 2026获奖名单揭晓:伯克利SuperMimic摘最佳论文,广工校友一作
伯克利华人博士、李飞飞学生拿到大结果。

机器人前瞻(公众号:robot_pro) 作者 | 钟宸、周加琦 编辑 | 漠影
机器人前瞻11月12日消息,机器人学习领域的顶级会议CoRL 2026今天公布了获奖名单。
本届CoRL的投稿量刷新了纪录。官方数据显示,CoRL 2026收到的有效投稿共2094篇,去年是737篇,增幅约184.1%;录用论文687篇,录用率32.8%。最终进入候选名单的论文有6篇。
最佳论文奖(Best Conference Paper Award)颁给了加州大学伯克利分校的一项人形机器人运动学习研究。
最佳学生论文奖则花落英伟达、斯坦福等机构合作的一项机器人长上下文策略学习研究。
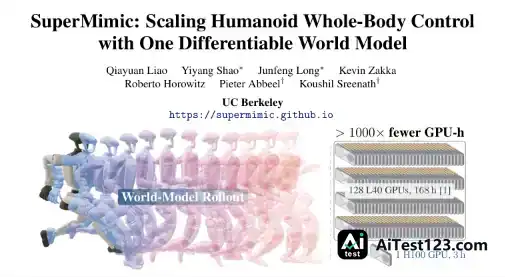
伯克利的SuperMimic研究构建了一种人形机器人全身控制策略,训练依托可微世界模型,GPU计算时间可缩减1000倍以上。单张GPU训练3小时,成绩就超过了用128张GPU训练7天的基线模型,相关方法已在宇树G1上做了真机验证。
论文一作廖洽源(Qiayuan Liao)是加州大学伯克利分校的博士生。广东工业大学机电工程学院的信息显示,他本科读的是该校机械电子工程专业,之后获全额奖学金赴伯克利攻读博士。
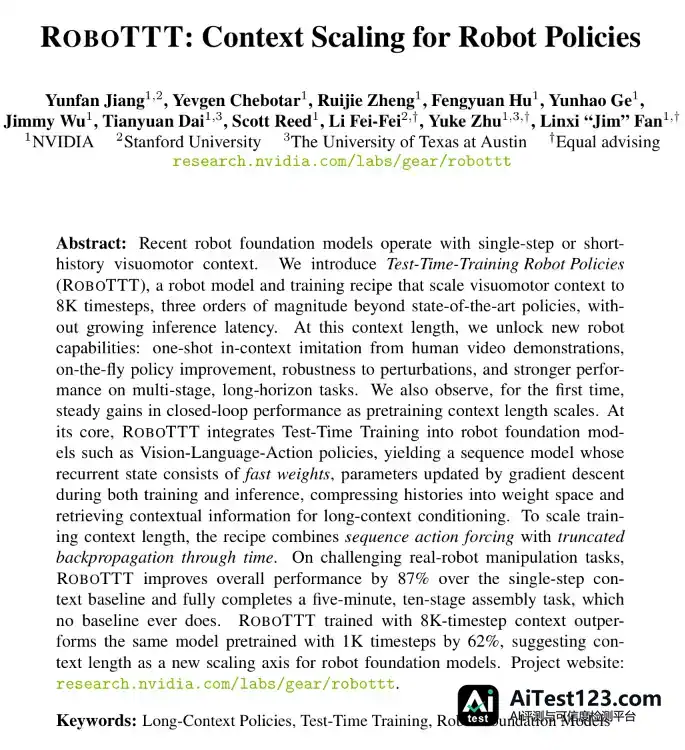
拿下最佳学生论文奖的另一项工作是RoboTTT。它给出的机器人策略学习方法基于测试时训练,上下文被拉长到8000个时间步,机器人因而能借助更长的历史信息处理复杂操作任务。
该论文一作Yunfan Jiang是斯坦福大学计算机科学博士生。其余作者中还有斯坦福大学教授李飞飞、英伟达GEAR团队负责人Jim Fan和朱玉可等人。
一、训练算力省下超1000倍,伯克利团队摘得最佳论文奖
最佳论文奖(Best Conference Paper Award)授予了加州大学伯克利分校的论文《SuperMimic:用一个可微分世界模型扩展人形机器人全身控制(SuperMimic: Scaling Humanoid Whole-Body Control with One Differentiable World Model)》。
论文给出的方法,把训练人形机器人全身控制所耗的算力压低了1000倍以上。
在129514段人体动作构成的基准测试上,SuperMimic只用1张GPU训练3小时,就胜过了此前的最强方法——用128张GPU训练7天的SONIC。
更关键的一点是,训练好的策略能直接部署到宇树G1上。SuperMimic公开的演示视频里,宇树G1流畅完成了后空翻、爬行、跳舞等高难度动作;它也能跟着跟踪器模仿人类动作,响应延迟不高,虽然偶尔踉跄,但做出来的动作与人类动作差别并不明显。
论文作者的说法是,这项工作“移除了算力这一人形机器人全身运控scaling的瓶颈”。
眼下,让灵巧的人形机器人学会大量人类动作,主流做法是在物理仿真器里用强化学习反复试错,跟踪海量动作捕捉数据。代价却极高:动作库扩大一分,算力开销就跟着线性上涨一分。
SuperMimic的起点来自一个很朴素的观察:对人形机器人而言,来自人类的参考动作虽然各不相同,却共享同一套混合刚体动力学。
研究团队据此用标准刚体仿真器(standard rigid-body simulator)记录的状态转移数据,拟合出一个所有动作共用的可微分世界模型(differentiable world model),再让世界模型和跟踪策略在同一循环中一起训练。
策略会在世界模型里做32步的想象推演(imagined rollouts),再借时间反向传播(BPTT,backpropagation-through-time)直接取得解析梯度(analytic policy gradients)。梯度不经过仿真器本身,所以带非平滑接触的仿真器同样能用。

这样的设计带来两处效率提升:按实际使用的批次大小(over the batch sizes used in practice)计,世界模型的想象推演比直接跑仿真快10倍以上,并行环境数拉满到64k时差距拉大到62倍;解析梯度则让策略达到同等训练回报所需的想象步数,比PPO少约64倍。
落到结果上,单张GPU跑3小时后,SuperMimic在129,514个动作的基准上只失败25个,SONIC则失败179个;用两张GPU训练9.8小时,失败数进一步降到零。
还有一点,SuperMimic并非靠堆数据取胜:它训练用的动作数据只有264.56小时,比SONIC的611小时少了约56.7%。
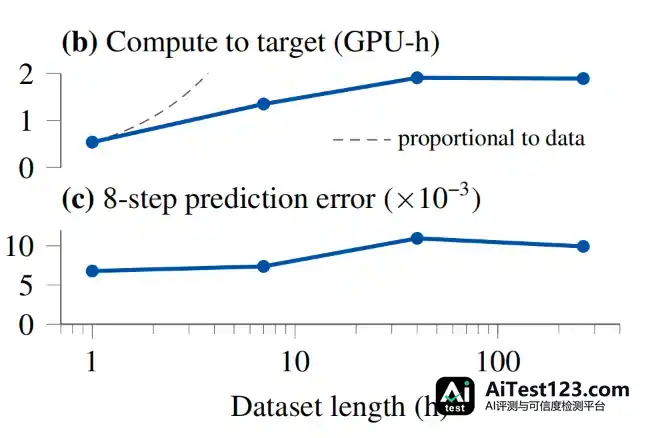
训练数据从1小时加到264小时,达到目标回报(target return)所需的GPU计算时长涨幅并不大,世界模型的8步预测误差也一直落在0.007到0.011之间。
团队甚至说,现在测“动作跟踪的scaling laws”,成本已经低到一张GPU就能扛。
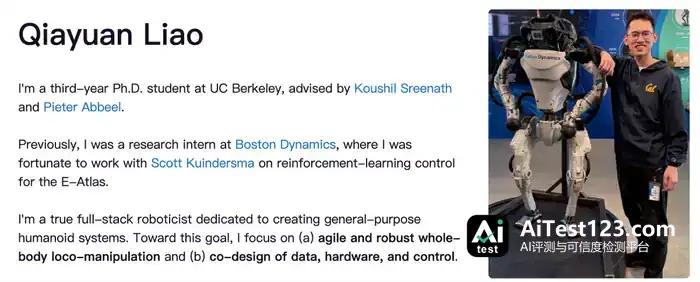
SuperMimic的7位作者都来自加州大学伯克利分校,第一作者廖洽源(Qiayuan Liao)是该校博士生。他此前在波士顿动力做过研究实习生,与Scott Kuindersma合作研究E-Atlas机器人的强化学习控制,还曾主导或参与Workhorse、BeyondMimic等项目;他参与开发的开源机器人学习框架MuJoCo Playground拿到过RSS 2025最佳演示论文奖。指导作者之一Pieter Abbeel是深度强化学习领域的大牛,任伯克利机器人学习实验室主任、伯克利人工智能(BAIR)实验室联合主任,也是Covariant的联合创始人。
转发这篇论文时,Pieter Abbeel直言:“人形全身运控训练的游戏规则改变了。”

二、机器人学会利用长期记忆,英伟达、斯坦福研究团队拿下最佳学生论文奖
本届CoRL最佳学生论文奖由英伟达、斯坦福大学和德克萨斯大学奥斯汀分校的联合研究团队获得,论文名为《RoboTTT:机器人策略的上下文扩展(RoboTTT: Context Scaling for Robot Policies)》,今年7月16日首次公开。
眼下多数机器人策略模型做决策时,只能用到单个时间步或较短的历史信息,此前的操作经历难以被充分利用,执行长时间、多阶段任务时这一短板更加突出。RoboTTT的解法是在模型推理过程中更新内部的快速权重,把历史交互信息持续压缩进模型参数,不必额外增加缓存的历史数据。
RoboTTT能处理长达8000个时间步的视觉运动上下文,按30Hz控制频率计算相当于4分半的交互历史,上下文长度比现有机器人策略模型提升约三个数量级。训练稳定性方面,团队用序列动作强制(Sequence Action Forcing)来保证,内存开销则靠截断时间反向传播(TBPTT)控制。
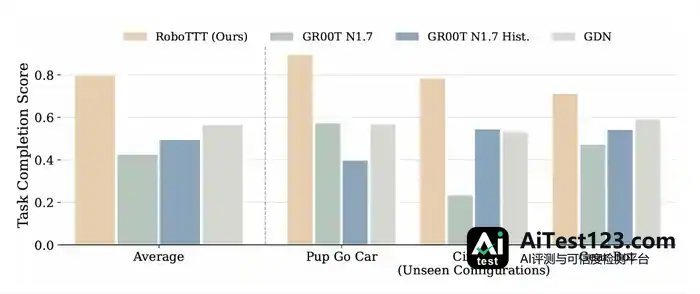
真机测试设置了三项长时间、灵巧装配任务:车辆模型组装、遥控机器人组装和电路组装。对比对象是GR00T N1.7、GR00T N1.7 Hist.及GDN三种基线模型。
三项任务中,RoboTTT平均完成率79%,另外三个模型分别为42%、49%和56%,且RoboTTT在所有任务上都拿到了最高完成率。
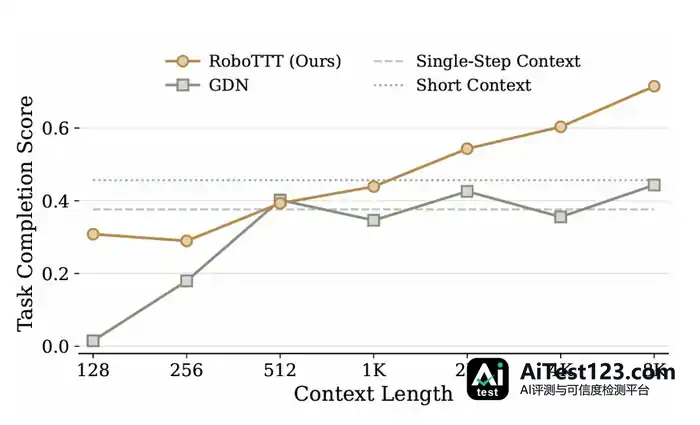
团队还考察了上下文长度对性能的影响:预训练上下文从128个时间步扩展到8000个时间步,RoboTTT的任务完成率由30.8%升到71.5%,也没有出现明显的性能饱和迹象。
论文第一作者Yunfan Jiang是斯坦福大学计算机科学博士生,师从李飞飞,同时在英伟达GEAR团队做机器人研究。他本科毕业于爱丁堡大学,之后在斯坦福拿到硕士学位,研究方向主要是机器人学习、强化学习。
▲Yunfan Jiang(图源:英伟达)
Yunfan Jiang此前参与的研究,曾获NeurIPS 2022杰出数据集和基准论文奖(Outstanding Datasets and Benchmarks Papers)以及ICRA 2024最佳论文奖。
结语:一个省算力,一个扩记忆,CoRL把奖给了“效率”
本届CoRL投稿量涨幅达184%,机器人学习领域正成为AI行业的又一“香饽饽”。过去几年,具身智能这一细分领域也基本延续了AI行业的共识:数据越多、算力越大、模型越强。但本届CoRL的获奖论文给出的答案略有不同。
训练提速的另一面:SuperMimic 能压缩成本,是因为它假定所有动作共享同一套动力学,并拿可微分世界模型把学习开销分摊到整个动作库,128 卡 7 天的活因此缩到单卡 3 小时;RoboTTT 则把上下文做到 8000 个时间步,做法不是加大缓存,而是在测试时训练,让历史信息被压进模型参数里。
算力与数据焦虑弥漫的当下,这两个奖至少说明,扩大训练规模之外还有另一条值得走的路:从算法设计、物理规律里挤效率。
















