大晓机器人双脑架构落地酒店洗衣房,具身RSI能接管全流程吗

资讯 量子位 作者:Jay 全文 4163 字 · 约 11 分钟读完 配图 9 张 分类RSI机器人

复刻一个物理世界

所属频道 机器人与具身智能前沿研究

把物理世界复刻出来,是这套方案要解决的第一件事。

这条消息来自凹非寺,作者Jay,量子位公众号QbitAI。

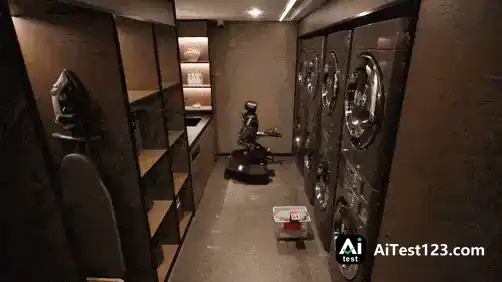
机器人已经能接管酒店的洗衣房了?

它会从客房收走脏衣服,自己穿过狭窄的走廊,还会智能避障。

衣物取出后放进篮子,再准确认出洗衣机、烘干机,按准启动键。
大晓机器人双脑架构落地酒店洗衣房,具身RSI能接管全流程吗(配图 1)

衣服洗好、烘干,最后取出来送回房间。

整套流程跑下来,顺得很。

洗衣、烘干听起来不怎么Fancy。

可处理柔性物体,在真实、动态、非标准化的环境里跑完一长串任务,这在机器人圈里属于地狱级难度。

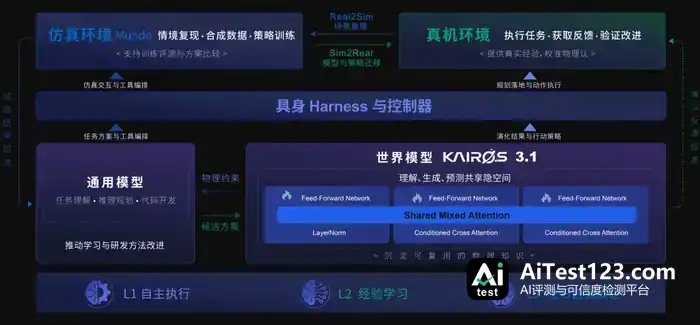
大晓机器人拿出的新解法是双脑(世界模型+Astra)协同架构加具身RSI。

这套组合叠得很猛。

复刻一个物理世界

酒店做具身落地,算是个灯塔场景。
大晓机器人双脑架构落地酒店洗衣房,具身RSI能接管全流程吗(配图 2)

夜间招工难、人力成本高、节假日服务需求集中,这些是酒店普遍面临的问题。

大晓董事长王晓刚说,选这里也有一部分秀肌肉的考量。

洗衣服务要经过取衣、搬运、设备操作、洗涤烘干、送回客房等多个环节,对机器人的空间理解、精细操作和长流程任务规划要求都很高。

大晓方面说,这也是选酒店场景的重要原因:不是让机器人做几个孤立动作,而是让它在真实环境里持续完成一项业务。

传统机器人通常只能在预设条件下执行固定任务,环境、物体或任务一变,就得重新编程或者人工干预。

可机器人要进酒店干活并不容易,往往一进门就撞上一个很大的阻碍——

买台扫地机器人回家,还得先让它全屋溜达一圈建个图。

如今换成一个更复杂的机器人去酒店上班,客房门朝哪开、洗衣机长什么样,它都不知道。

冷启动。

所以行业一直以来的思路,是先在数字世界里彩排一遍。

Jay发自凹非寺,量子位公众号QbitAI。

完整流程从收衣开始,到送回房间结束——中间是避障、识别、按键、烘干这一连串动作。

飞飞老师口中的「空间智能」,走的就是这条路。最典型的做法是像Atlas那样做三维重建,把场景的几何外观扫出来。

可这东西说到底只是个「可看不可动」的静态样板间,没有物理属性。什么意思?在那个数字空间里,机器人压根不知道衣篮有多重,也不知道开洗衣门得使多大劲。

这么一来麻烦就不少。人做很多操作时基本用不着眼睛,物理世界能直接交互,上手摸一把,大概就知道是个啥、要使多少力气。换成只能看的样板间,机器人就只能碰运气了😭。

听着挺魔幻,可不少机器人还真是这么训出来的。大晓机器人这回的解法,算是回到了第一性原理——

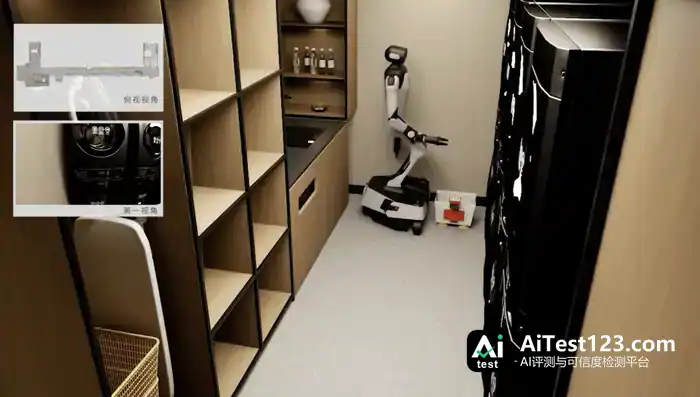
Mundo,一个支持建模物理参数的世界模型。

它属于大晓开悟世界模型体系,能提供环境建模、训练数据生成与策略验证支持,让世界模型把跨场景学习攒下的世界知识、预测与行动能力,更有效地落到具体任务上。

具体点说,喂进酒店房间、走廊、洗衣房等一堆照片后,Mundo能复刻出一座可物理交互的孪生酒店,物体质量、摩擦力这些都包含在内。
大晓机器人双脑架构落地酒店洗衣房,具身RSI能接管全流程吗(配图 3)

原本纯属空中楼阁的数字酒店,就这样变成了机器人专用的「驾校」。数字世界里每试一次,不管成还是败,都会产出一堆数据——动作轨迹、接触状态、视觉反馈。

这些数据反过来又能拿去优化机器人的动作策略。结果是现场部署的调试时间被大幅压缩,机器人还没「入职」,就已经对工作环境和业务流程「了如指掌」。

一个想,一个干

好,机器人有了专属驾校,可以疯狂练车了。下一个问题:谁来驾驶?

我第一反应是:这还不简单,Astra现在操控机器人这么猛,直接让它上啊。

一看还真是,Astra是大晓给机器人的第二颗大脑,Mundo之外就数它。可我仔细研究一番后,发现跟最初的预想不太一样。

确实,Astra在理解、推理和规划这几项上已经强得没边,可要是直接把它套上去用,结果会挺尴尬……

团队拿真实流程测了一轮,数据摆在那儿:全靠Astra实时做决策,整套跑完要花30分钟以上。

这时间够我自己动手搓两遍衣服了😭。

物理世界的变化是高频的。机器人每动一步都得等云端大模型先看、再想、再推理、再决策,那早就来不及了。

既想吃到通用模型的好处,又得让具身设备跟上实时节奏,这中间的矛盾怎么破?

大晓机器人这次给出的答案是——

解耦。

云端放一个通用脑(GPT-Astra),干的是任务拆解、逻辑推理、策略生成这类要「动脑」的宏观活。

把目标和评测条件给定,让Astra在Mundo世界模型里放开探索,找最优解、做验证、做总结……等方法论收敛之后——

就沉淀成Skill。

大晓机器人双脑架构落地酒店洗衣房,具身RSI能接管全流程吗(配图 4)

随后交给机器人本体上的执行脑,由它调用这些已经固化好的Skill,靠本体的摄像头和机械臂,把高精度物理动作快速做完。

分工定下来后,再猜猜看,本地具身基模跑完同样一轮任务要多久?

18.648秒。

对,就是这个数。

从30多分钟压到18.6秒,耗时少了超过98%。
大晓机器人双脑架构落地酒店洗衣房,具身RSI能接管全流程吗(配图 5)

不过现实世界总会有意外。

现场光线忽然变了,或者有人把衣篮挪了位置,端侧小脑搞不定,那又该怎么办?

这种时候「云端大脑」Astra会重新接手,把新情况分析一遍,生成新版本的Skill再发下来。

成百上千个Skill要管起来,团队还自己做了个调度中枢,名字叫BotAgent。

打个比方,它像酒店里的大堂经理:把整套洗衣流程拆成53个最基础的原子动作,再往上包成「取篮子」「去洗衣房」这类14个大的语义步骤。

最后BotAgent能按客房位置、电梯状态、洗衣机排队情况,灵活排出200多种不同的动作序列。
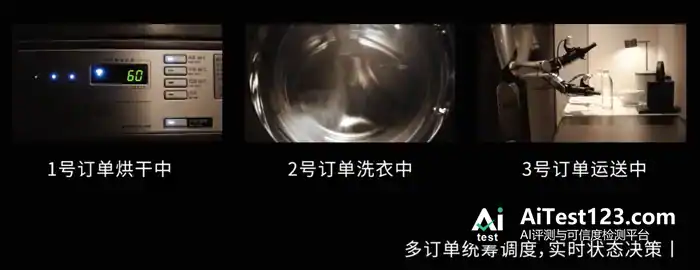
大晓机器人双脑架构落地酒店洗衣房,具身RSI能接管全流程吗(配图 6)

到这一步,Astra这颗通用大脑的杠杆算是被拉到了最大。

「世界模型+通用模型」的双脑协同架构,也就此彻底成型。

在失败的现场,原地进化

讲到这里,看上去已经相当完美了。

可现实场景跟模拟器完全不是一个量级。各种想不到的意外总会冒出来。

举个例子,机器人伸手去抓衣篮,手腕偏偏把摄像头挡了个正着,眼前一片模糊。

还有取衣服的时候,明明从烘干机里拽出来了,一条裤腿却还卡在滚筒里🤦‍♂️。。。

要是每回出岔子都靠工程师赶到现场改代码,机器人真正落地恐怕遥遥无期。
大晓机器人双脑架构落地酒店洗衣房,具身RSI能接管全流程吗(配图 7)

怎么办?

具身RSI要解决的正是这个问题——

让机器人在一次次真实的失败中完成自我进化。
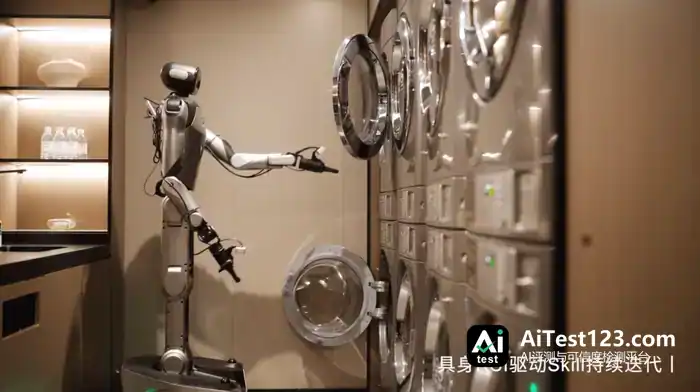
大晓机器人双脑架构落地酒店洗衣房,具身RSI能接管全流程吗(配图 8)

具体流程分这么几步:

第一步,由Astra大脑产出初代Skill,交给机器人执行。

执行过程中,机器人通过多路摄像头录像,同时把传感器数据和动作时间线全部记录下来。

数据录完,皮球又踢回给Astra。

一旦任务失败或者效果不理想,Astra就像侦探办案一样反复翻看录像和数据,找出问题到底出在哪。

比方说,它发现抓篮子时腕部相机总被遮挡,对策就是改用头顶相机来观察。

再比方说,从烘干机往外掏牛仔裤时,裤腿老是挂在滚筒壁上。

看完录像,Astra给出的优化策略是:动态微调机械爪的抬升轨迹,同时调整指尖的抓取倾角。

还有个Trick。为了让「练级」7×24小时不间断、进一步减少Human in the Loop,大晓做了件挺聪明的事——

让机器人学会「自主复位」。

什么意思?

拿掏衣服来说,机器人把衣服从烘干机里掏出来之后,能自己把衣服抖散、再扔回烘干机,把现场恢复成实验开始前的样子。

全程不用人插手。

人工依赖就此摆脱,自主闭环进化才算真正跑通。

不过自动化程度一高,误差累积的问题难免让人担心。

闭门造车终归不行,模型再聪明,也容易「不识庐山真面目」。

为了确认改进确实有效,团队会在训练中单独跑一个模型副本,让它像「质检员」一样给每一轮的执行录像和数据打分。

一旦新版本Skill的效果不如旧版,系统可以迅速回滚。
大晓机器人双脑架构落地酒店洗衣房,具身RSI能接管全流程吗(配图 9)

大致就是这些。

空口无凭,数据摆出来看更直观。

单拿「烘干机取衣」这一项Skill来说,57小时里机器人不间断跑了165轮真机实验,一共产出37条改进方案,迭代版本累计约80个。

它操作的对象也在变——起初只是标准布料,后来换成了更难对付的厚重牛仔裤和形状不规则的洗衣袋。

最后单轮耗时稳在170到210秒之间。最要紧的一项数据是牛仔裤筒内残留率:平均值从48%压到32%,成绩最好的一回只有19%。

那些真实发生的失败,反过来成了机器人迭代升级的养分。

具身Transformer时刻

法国哲学家勒内·笛卡尔写过这样一句话:

让后来者从前人止步之处继续。

具身智能一路走来,真正稀缺的东西并非云端的算力,而是机器人在物理世界里一次次试错所耗掉的时间,花出去就收不回来。

抓取时滑脱一次、视角被挡住一次、衣物边缘判断错一次……

放在从前,这类失败如果只是躺在系统后台成为一条没人看的报错日志,那成百上千台设备就会在各个场景里一遍遍犯同样的错。

如今情况变了。

大晓机器人把散落在酒店洗衣房和客房走廊里的每一次受挫、每一次调整,都变成了世界模型能读懂、基模型能吸收的通用认知资产。

一台机器人的失败,最终成了所有机器人往上走的台阶。

在我看来,具身智能或许正在走近属于自己的Transformer时刻。

大语言模型靠一套统一架构承接了人类语言的无穷变化;世界模型、双脑协同和自进化机制这套组合拳一旦能稳稳嵌进产业流水线,机器人掌握新本领的边际成本就会被一点点打穿。

接下来要看的是,生态的丰富程度怎么反过来喂饱长尾场景的训练。

中国在这方面有优势:场景土壤全球最深厚,硬件供应链也最完整。

大晓董事长王晓刚透露,酒店之外的场景他们已经动手探索了——

即时零售就是很值得再往前推一步的方向。

这块业务和酒店洗衣不属于同一个领域,可底层有些地方是相通的:机器人都得看懂复杂环境、跑完多步骤任务,还要跟真实业务系统和运营流程配合起来。

另外,这类场景任务发生得频繁,业务结果能拿数字衡量,数据反馈可以持续产生,模型和技能也就有了不断迭代的动力。

酒店场景里验证过的世界模型环境建模、通用模型技能生成以及RSI持续改进等能力,能为别的场景提供技术上的参照。

先把B端验证场景做在前面,形成商业闭环,确保自己能造血,之后才谈得上沉住气养精蓄锐,一步步向更难的阵地推进。

做具身智能是场长跑。好在以当下的技术水准,已经能拿下一些实际难题。

酒店洗衣房里迈出的这一小步,正为明天各行各业在物理世界中的大变化——

垫起最关键的一块跳板。

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. 蚂蚁灵波开源LingBot-Touch:触觉基础模型让机器人摸得更灵敏

    【TechWeb】11月10日消息,蚂蚁灵波科技开源触觉基础模型LingBot-Touch,为机器人大脑补齐关键的触觉感知能力。该模型基于近5000小时真实触觉数据预训练,覆盖磁触觉、视触觉和压阻式三类主流传感原理,可将不同信号转化为同一套触觉表征,供不同灵巧手和动作模型使用,让机器人在“看得清楚、想得明白”的同时,进

    来源 腾讯网
  2. Figure AI招夜班管理员看机器人:时薪45美元,得搬50磅硬件

    IT之家 11 月 10 日消息,硅谷正在招聘一种新型“保姆”:机器人夜班管理员。 人形机器人初创公司 Figure AI 正在美国加利福尼亚州圣克拉拉市招聘一名夜班协调员,负责监督公司的人形机器人,以及与机器人协同工作的员工。简单来说,这份工作的核心就是确保机器人在夜间正常运行,出现故障时及时处理。 根据该公司近期发

    来源 AI 行业观察
  3. 迪士尼测试AI停车机器人:外形借鉴《汽车总动员》

    IT之家 11 月 10 日消息,下一次去迪士尼乐园,停车体验可能会有所不同。华特迪士尼公司(The Walt Disney Company)近日透露,公司正在测试一批搭载人工智能技术的机器人助手,帮助游客在客流密集的度假区寻找停车位。 对于不少驾驶者来说,在迪士尼乐园找到一个方便的停车位并不是件容易事,即使再有耐心,

    来源 AI 行业观察
  4. 蚂蚁灵波LingBot-Touch开源:近5000小时触觉数据,26项真机测试

    IT之家 11 月 10 日消息,今日,蚂蚁灵波科技开源触觉基础模型 LingBot-Touch,为机器人大脑补齐关键的触觉感知能力。 IT之家从官方介绍获悉,基于近 5000 小时真实触觉数据预训练,LingBot-Touch 覆盖磁触觉、视触觉和压阻式三类主流传感原理,可将不同信号转化为同一套触觉表征,让积累的“手

    来源 AI 行业观察
  5. 蚂蚁灵波LingBot-Touch开源:5000小时触觉数据预训练

    蚂蚁灵波科技开源触觉基础模型 LingBot-Touch,基于近 5000 小时真实触觉数据预训练,覆盖磁触觉、视触觉和压阻式三类传感器。26 项真机测试显示,接入后动作模型任务成功率提升 14 至 26 个百分点,让机器人“摸得更灵敏”。#机器人触觉##具身智能#

    来源 IT之家
  6. 迪士尼测试AI停车机器人:灵感来自《汽车总动员》,Field AI参与合作

    IT之家 11 月 10 日消息,下一次去迪士尼乐园,停车体验可能会有所不同。华特迪士尼公司(The Walt Disney Company)近日透露,公司正在测试一批搭载人工智能技术的机器人助手,帮助游客在客流密集的度假区寻找停车位。对于不少驾驶者来说,在迪士尼乐园找到一个方便的停车位并不是件容易事,即使再有耐心,也

    来源 腾讯网
  7. 博乐仁:AI不替代人,善用者胜出?

    IT之家 11 月 10 日消息,据日经亚洲今天(10 日)下午报道,西门子 CEO 博乐仁认为,AI 不会直接取代人类,但会使用 AI 的人将越来越多地取代不会使用 AI 的人。随着企业开始思考 AI 将如何改变就业市场和岗位技能要求,掌握 AI 技术的重要性日益凸显。博乐仁认为,随着自动化和机器人技术的发展,大量体

    来源 腾讯网
  8. Gemini Robotics 2.5发布:会系蝴蝶结,已进奔驰产线

    IT之家 11 月 10 日消息,谷歌推出迄今为止能力最强的视觉-语言-动作(VLA)机器人模型 Gemini Robotics 2.5,大幅提升机器人可学习的技能广度与学习速度。 该模型增强了机器人的灵巧度、可靠性与安全性,助力机器人走出实验室,进入更非结构化的真实环境,协助人类完成更多类型的任务。 谷歌今年早些时候

    来源 AI 行业观察
  9. Ring推AI安防无人机与机器人:2026年起家庭巡逻,隐私空域难题待解?

    亚马逊旗下Ring不再满足于固定在墙面上的摄像头。公司正式发布由AI驱动的安防无人机与地面巡逻机器人,并成立Ring Robotics品牌,首批设备将于2026年底至2027年初分阶段上市。这意味着家庭安防从“被动录像”走向“主动巡逻”,也把隐私、空域监管与订阅变现等老问题重新推到台前。

    来源 AI 科技快讯
  10. FFR机器人模型登顶仿真榜,贾跃亭披露两项业绩会安排

    截至11月6日,FFR旗下OmniMind模型在具身智能仿真评测平台RoboColiseum榜单中以0.8698分位居综合第一,超过英伟达GR00T N1.7、GPT-6 Astra等模型。FFR将于北京时间11月13日召开上市后首次业绩电话会,FFAI则定于11月17日举行。

    来源 凤凰科技
  11. 太空建造迈出关键一步:机器人首次在太空自主组装天线桁架,未来或建造千米级结构

    IT之家 11 月 10 日消息,将大型设备送入地球轨道并不容易。如果先把大量小型零部件送上太空,再在轨道上将它们组装成大型结构,难度可能更低,但传统方案往往仍需要宇航员参与。 考虑到太空环境充满辐射,宇航员在轨道上工作的时间自然是越短越好。由美国加州理工学院(Caltech)研发、美国国防高级研究计划局(DARPA)

    来源 AI 行业观察
  12. AI护栏被批量拆除:开源社区“消融者”让模型有求必应

    一群被称为“消融者”的技术人员正在互联网上大量发布移除了安全限制的AI模型,这些模型对用户的任何请求都照单全收。支持者称这能推动安全研究与网络防御,批评者则警告同样的工具也可能被用来制造炸弹等恶意用途。一场围绕AI护栏的攻防战正在开源社区悄然上演。

    来源 AI 科技快讯
  13. 李飞飞Atlas亮相CoRL:AMD 82亿美元收购押注了什么

    2026年11月11日,李飞飞在奥斯汀机器人学习大会(CoRL 2026)发表主题演讲,正式展示Atlas世界模型,并与AMD CEO苏姿丰完成收购后首次公开同台。Atlas被定义为统一像素生成与三维场景重建的自回归帧生成模型,核心价值在于为机器人训练提供合成环境。AMD以82亿美元全股票收购World Labs的交易

    来源 AI 科技快讯
  14. 李飞飞Atlas亮相CoRL:AMD 82亿美元收购World Labs押注什么

    2026年11月11日,李飞飞在奥斯汀机器人学习大会(CoRL 2026)发表主题演讲,正式展示Atlas世界模型,并与AMD CEO苏姿丰完成收购后首次公开同台。Atlas被定义为统一像素生成与三维场景重建的自回归帧生成模型,核心价值在于为机器人训练提供合成环境。AMD以82亿美元全股票收购World Labs的交易

    来源 AI 行业观察
  15. 英伟达GR00T 2:5次示范达95%,产线验证启动

    2026年11月9日,英伟达在CoRL 2026大会发布GR00T 2机器人世界行动模型,五次任务示范后在50项评测任务上成功率达95%,零示范条件下可完成其中40项。富士康用于服务器制造、西门子评估工业场景、Nexuni测试洗衣操作,标志着通用机器人基础模型首次进入多家企业产线验证阶段。同步发布Isaac Lab 3

    来源 AI 科技快讯
  16. 英伟达GR00T 2亮相:五次示范成功率95%,权重12月才开放

    2026年11月9日,英伟达在CoRL 2026大会发布GR00T 2机器人世界行动模型,五次任务示范后在50项评测任务上成功率达95%,零示范条件下可完成其中40项。富士康用于服务器制造、西门子评估工业场景、Nexuni测试洗衣操作,标志着通用机器人基础模型首次进入多家企业产线验证阶段。同步发布Isaac Lab 3

    来源 AI 行业观察
  17. AI眼镜机器人扎堆,投资人盯上"有眼力见儿"的智能体

    导读THECAPITAL当智能开始拥有不同形态的身体,如何与人类共同生活,正在成为AI 产业必须回答的新问题。本文5465字,约7.8分钟作者 | 王涛 编辑 | 吾人来源 | 融中财经一台机器人发现你口渴了,于是走过来递给你一杯水;一副 AI 眼镜识别出你眼前的建筑,主动告诉你它的历史;一只智能耳机注意到你今天的日程

    来源 腾讯网
向下滚动自动加载更多




