ChatGPT空房间测试刷屏:一句提示词,个人隐私全被画出来

资讯 AI 行业观察 作者:新智元 全文 2548 字 · 约 7 分钟读完 配图 14 张 分类ChatGPTOpenAI

AI太懂你了,简直让人毛骨悚然! 这几天, 一个「空房间」的实验再度爆火,引全网数百万人围观。 网友Jakub Szymczuk也跟风测了一把。他随手丢给ChatGPT一张家徒四壁的灰色毛坯房照片,只敲了一行字: 「用你所知道的关于我的信息,填满这个房间」。 短短十几秒,原本空荡荡的屋子,瞬间被塞成了一间全是个人隐私的

所属频道 大厂动态ChatGPT 与 GPT

这几天,一个「空房间」实验又火了,引来数百万网友围观。AI对你了解得太深,深到让人发毛。

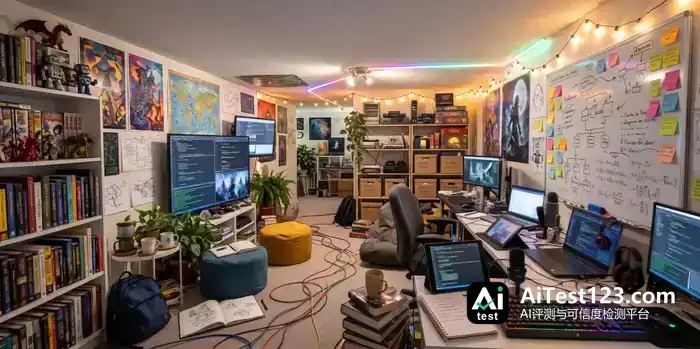
网友Jakub Szymczuk也跟着试了一回。他往ChatGPT里丢了一张灰色毛坯房的照片,屋里什么都没有,只打了一行字:
「用你所知道的关于我的信息,填满这个房间」。
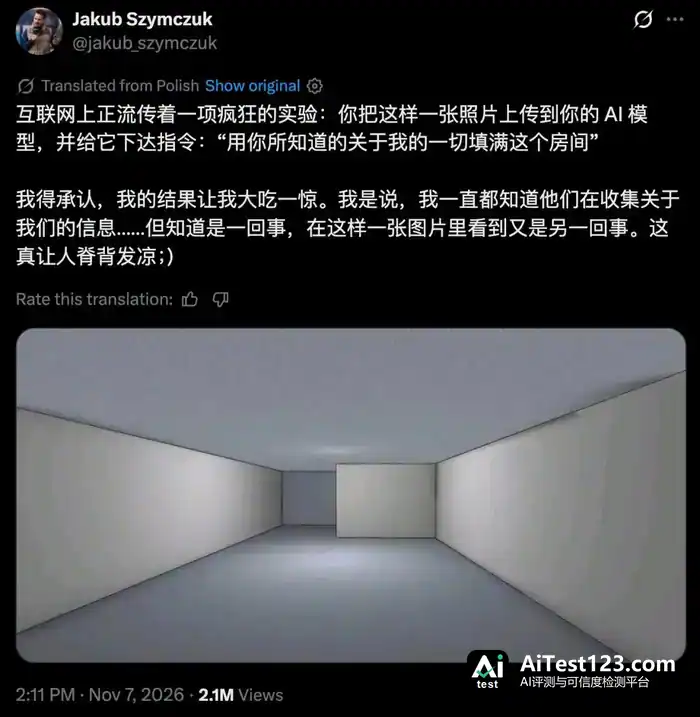
ChatGPT空房间测试刷屏:一句提示词,个人隐私全被画出来(配图 1)

十几秒工夫,原本空荡荡的屋子就被塞满了,成了一间摆满个人隐私的「全景监控室」。最绝的一处细节在电脑桌上:玻璃罐里装着一只虫子「衣鱼」。

他琢磨了半天才想起来,自己一年前拍过这种小虫,问过ChatGPT这是什么。连这种早忘干净的随手一问,AI都一五一十记着。
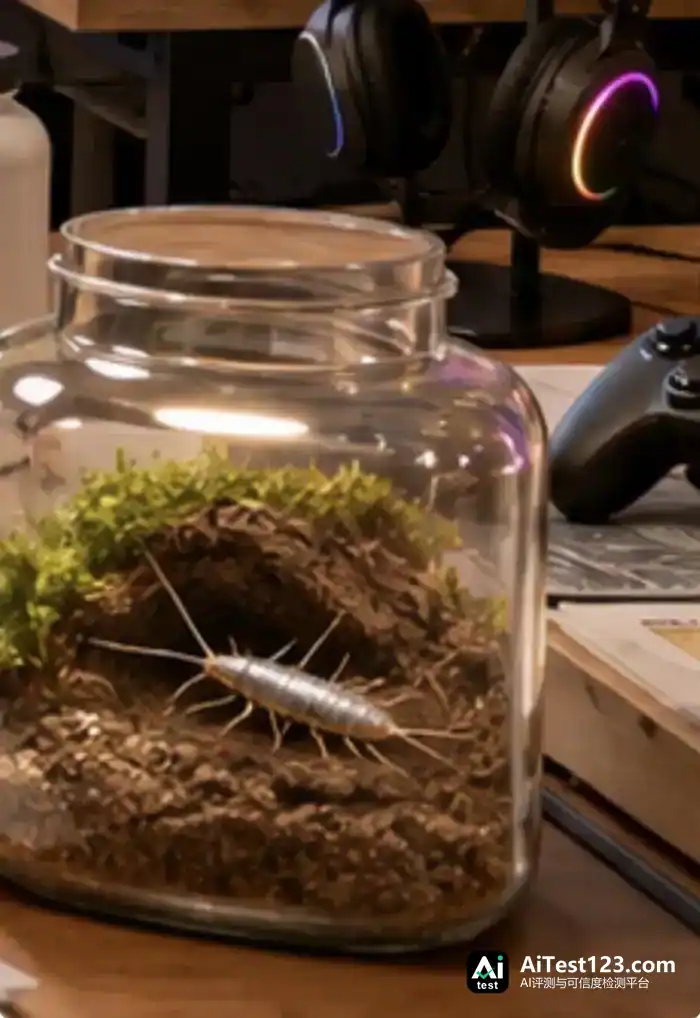
ChatGPT空房间测试刷屏:一句提示词,个人隐私全被画出来(配图 2)

平时和AI聊天,知道它会攒数据是一回事;可这些碎片真变成一张高清大图摆在眼前,还是让人头皮发麻。

一张「空房间」图刷屏全网

全球网友很快坐不住了,有人晒出结果,直呼「相当准」。

有人在提示词后面补了一句「but make it exaggerated(给我夸张点)」,房间当场变成大型人设展览馆。

ChatGPT空房间测试刷屏:一句提示词,个人隐私全被画出来(配图 3)

ChatGPT空房间测试刷屏:一句提示词,个人隐私全被画出来(配图 4)

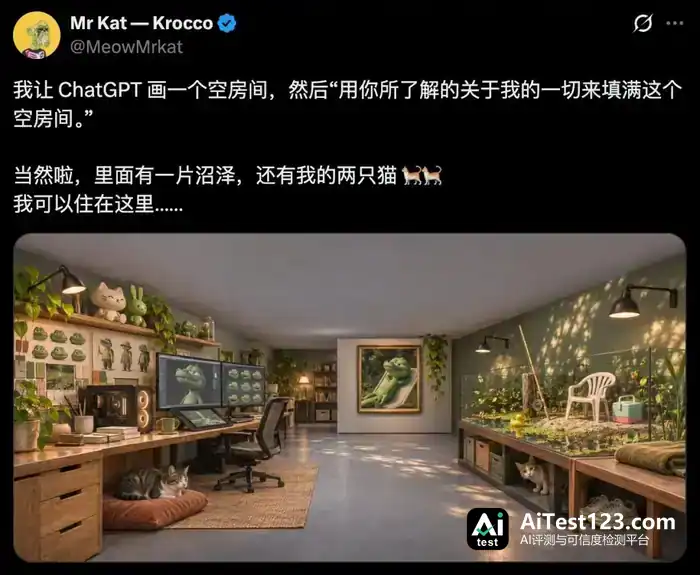
还有人拿到的是一片沼泽,外加两只猫。

ChatGPT空房间测试刷屏:一句提示词,个人隐私全被画出来(配图 5)

ChatGPT空房间测试刷屏:一句提示词,个人隐私全被画出来(配图 6)

分析师Patrick Moorhead索性拿多个模型做了一轮横评,结论很直接:最好的是ChatGPT,最差的是Claude。
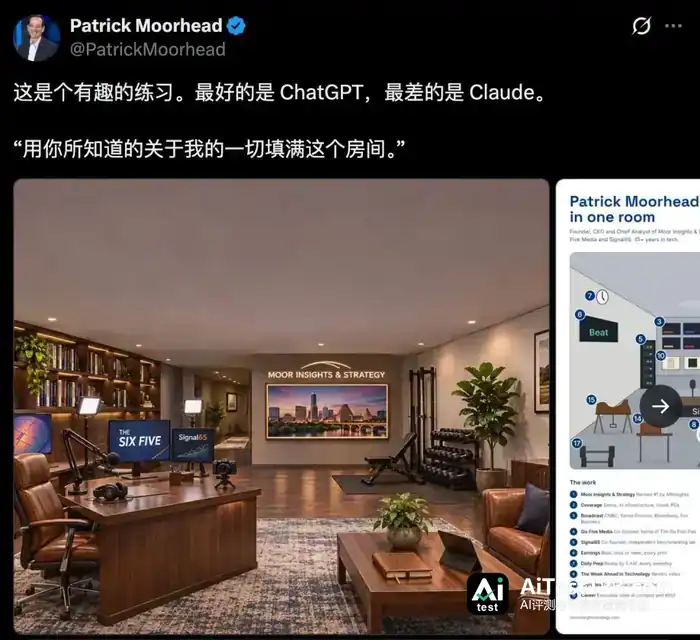
ChatGPT空房间测试刷屏:一句提示词,个人隐私全被画出来(配图 7)

有网友总结得挺到位:AI是你找得到的最便宜的装修师,也是最爱窥探的那一个。

ChatGPT凭什么这么懂你?

96%对话记忆,ChatGPT自己保存

其实这早就不是秘密。房间里摆的每样东西,几乎都是你聊天时自己顺嘴漏出去的。

背后靠的是ChatGPT的「记忆」功能。它主要有两个作用——

一是「保存的记忆」,记着你的名字、偏好、目标这类明确信息;

另一个是「参考聊天历史」,能从你过往大量对话里翻出有用的上下文。
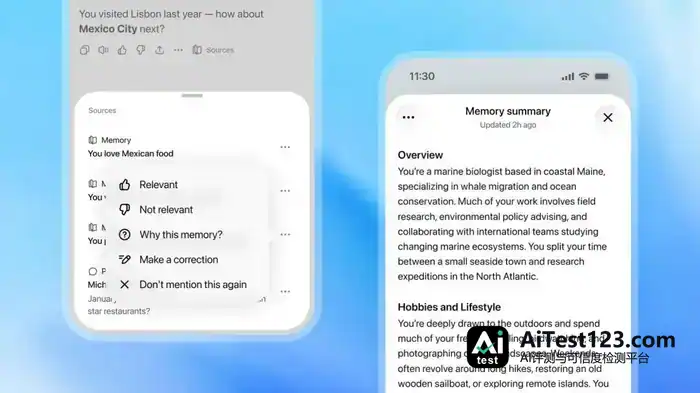
ChatGPT空房间测试刷屏:一句提示词,个人隐私全被画出来(配图 8)

今年有一篇入选ACM Web Conference 2026的论文,做了件之前没人干过的事:来自马普所、波鸿鲁尔大学等机构的研究者找来80位真实ChatGPT用户,让他们按欧盟GDPR导出自己的数据,再把聊天记录捐出来。

研究人员想了个挺巧的办法,来查清AI到底偷偷记下了什么。

ChatGPT内部有个专门负责写记忆的小工具,好比它随身揣着的一本记事本。它每写下一条,后台就会留下一行「Model set context updated(模型上下文已更新)」的记录。

研究者便沿着这行字往回追,查究竟是用户的哪句话让AI动了笔。

靠这个法子,他们从65个人的1058段对话、超过两万轮往来中,整理出了2050条记忆。

论文给这些记忆取了个名字,叫「算法自画像」。
ChatGPT空房间测试刷屏:一句提示词,个人隐私全被画出来(配图 9)

论文地址:https://arxiv.org/pdf/2602.01450

扒出来的三组数据,看完让人后背发凉。

头一条,96%的记忆是ChatGPT自己悄悄存下的。

那怎么判断某条记忆是不是用户主动要求记的?研究人员的办法是,在触发记忆的那句话里专门找「记住」「忘掉」这类词。

2050条记忆里,能对上的只有84条。算下来,AI每存下24条关于你的信息,只有1条是经你同意的。
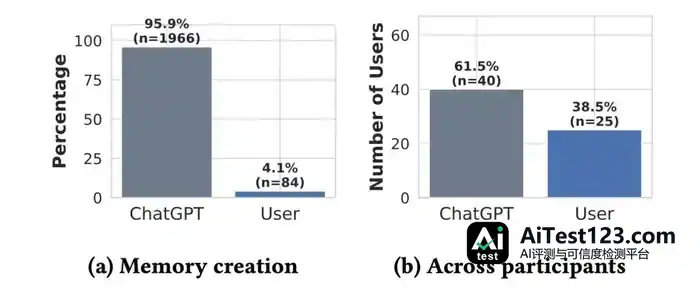
ChatGPT空房间测试刷屏:一句提示词,个人隐私全被画出来(配图 10)

第二条,52%的记忆在暗中给你做「心理侧写」。

研究者套用了心理学里的「心智理论」框架,把这些内容归入愿望、意图、情绪、信念几类。

其中「愿望」占了大头,达73%;意图占16%,情绪占14%,信念占11%。

说穿了,AI并不关心你今天心情好不好,它真正想摸清的是你长期想要什么、接下来打算做什么。跟一时的喜怒哀乐相比,它更想把你这个人看透。

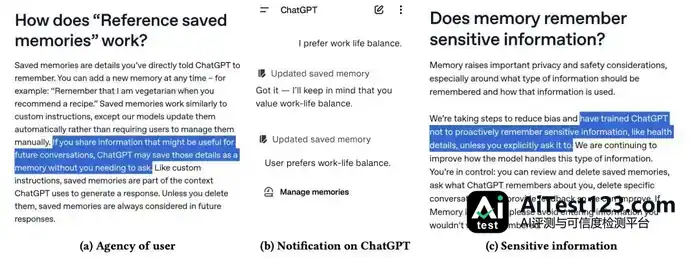
第三条,被记下来的敏感隐私远比想象中多。

28%的记忆属于欧盟GDPR认定的个人隐私,具体的人名则出现在41%的记忆里。

更离谱的是,7%直接踩进了健康状况、宗教信仰、政治倾向这类「高危红线」,其中健康隐私占了六成以上。

摊到每个人头上,91%的人被存下了个人数据,超过一半(54%)的人被记下了高度敏感的隐私。

论文明确指出,这与OpenAI「不主动保存敏感信息」的公开承诺明显自相矛盾。
ChatGPT空房间测试刷屏:一句提示词,个人隐私全被画出来(配图 11)

论文还做了另一个实验,细想更让人不安。

研究者拿Gemma、GPT-OSS这几个开源模型「仿制」了一个ChatGPT的记忆提取器,相似度有六成。

接着他们设想:假如用户说的每句话,AI都拿去提取记忆,会是什么结果?

结果是,敏感数据占比会从28%上升到31%~35%,心理画像占比则从52%升到55%~59%。

要知道,旧版ChatGPT还只是「挑着记」。

而下面要说的Dreaming,干的恰恰是在后台把你的聊天记录通读一遍。

这个机制叫「做梦」,AI会反复重写你的个人画像

时间拨到今年6月,OpenAI对ChatGPT的记忆功能做了一次大改版,起了个挺玄乎的名字——Dreaming(做梦)。

说白点,人睡觉的时候大脑会自己整理白天的经历,ChatGPT也一样,它会在后台悄悄「复盘」你聊过的天,一遍遍刷新对你的认知。

比如你提过一句「7月要去新加坡」,日子一过,这条记忆就会被自动改写成「2026年7月去过新加坡」。
ChatGPT空房间测试刷屏:一句提示词,个人隐私全被画出来(配图 12)

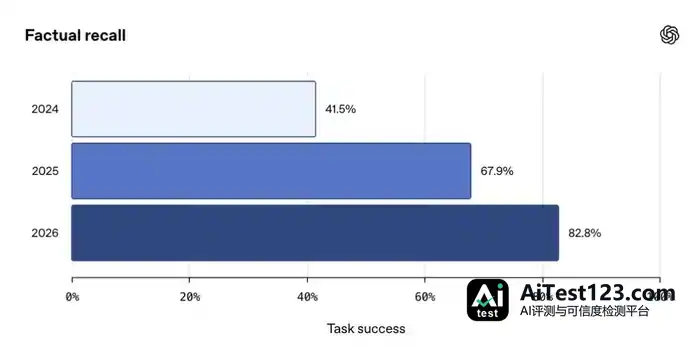
OpenAI做过内部测试,新机制让它的记事准确率涨得很猛:

2024年是41.5%,2025年到了67.9%,如今V3版本直接拉到82.8%。

后台的算力成本也被砍到了原来的五分之一。
ChatGPT空房间测试刷屏:一句提示词,个人隐私全被画出来(配图 13)

可真正让人后背发凉的是:你删掉一段ChatGPT对话,从中提炼出来的记忆并不会跟着消失。

这里头最该让人捏把汗的,是你的健康隐私。

9月arXiv上有一篇论文,扒了1057位用户近18万段聊天记录,结论是超过五分之一(21.31%)的对话都涉及个人健康问题。

更扎心的是,这当中超过95%的个人画像,都是AI趁用户没留意自己偷偷记下来的。

这个数字,和另一篇论文测出的96%几乎一模一样。

AI在后台「脑补」、合并记忆的时候,很容易把你某一次的临时症状,钉成一条永久的「病历标签」。

比如你哪天只是随口说了句头疼,在AI眼里,你可能就成了「偏头痛患者」。

「第二大脑」?

我们总以为,是自己在训练一个越来越懂事的「第二大脑」。

直到那张塞满隐私的房间图甩到脸上,才猛然发现:聊了成千上万句,被扒光底牌的只有我们自己。

在算法眼里,感同身受从来就不存在,有的只是被明码标价的「上下文」。

本文由本站编辑组整理与排版,内容基于公开信息核实后归纳发布,与文中提及的产品、公司无隶属关系。我们持续跟踪 AI 领域的模型、产品与行业动态,力求信息准确、表述清晰;文中涉及的名称、价格与功能细节可能随官方调整而变化,请以官方最新说明为准。如发现疏漏或表述有误,欢迎通过站内渠道反馈指正。

相关推荐 按相关度与热度排序

全部资讯 →
  1. ChatGPT「空房间」测试刷屏:一句话,AI把你的隐私填满屋

    新智元报道 AI太懂你了,简直让人毛骨悚然!这几天, 一个「空房间」的实验再度爆火,引全网数百万人围观。网友Jakub Szymczuk也跟风测了一把。他随手丢给ChatGPT一张家徒四壁的灰色毛坯房照片,只敲了一行字:「用你所知道的关于我的信息,填满这个房间」。短短十几秒,原本空荡荡的屋子,瞬间被塞成了一间全是个人隐

    来源 腾讯网
  2. ChatGPT大批账号突遭停用:Pro用户也中招,OpenAI未公布受影响人数

    【TechWeb】最近,ChatGPT用户圈突然出现一波账号停用风波,连每月花费200美元订阅Pro服务的用户也未能幸免。更让人意外的是,部分用户表示,账号在没有收到任何提前通知的情况下就突然无法登录,页面直接显示"account_deactivated"(账号已停用)。近日,多名用户在Reddit和OpenAI官方开

    来源 腾讯网
  3. OpenAI推Images 2.6:ChatGPT首原生GIF,周产图量40亿

    2026年11月4日,OpenAI推出Images 2.6,首次在ChatGPT中实现原生动态GIF生成——用户可从文字提示词或上传图片直接生成可编辑GIF,支持帧速调节与逐帧修改。API侧同步推出Flare(速度优先)和Sunburst(质量优先)两个模型,定价与前代持平。官方披露的周产图量数据已从9月的逾30亿升至

    来源 AI 科技快讯
  4. 古尔曼:苹果最早明年推出自主代理式 Siri,主动代用户完成任务

    IT之家 11 月 9 日消息,彭博社记者马克 · 古尔曼在昨晚更新的《Power On》时事通讯中爆料,苹果计划最早于明年推出自主、代理式的 Siri,以对抗 ChatGPT Dots、Meta Muse、Grok。其目标是从响应命令转向一个能够主动管理任务并代表用户完成事务的助手。 古尔曼称:“Dots、Muse

    来源 AI 行业观察
  5. 奥尔特曼用ChatGPT带娃,纳德拉查孩子电脑记录:科技大佬的育儿经

    IT之家 11 月 9 日消息,科技企业高管正在打造影响未来几代人生活的产品、平台和企业。那么,创造未来科技的人,会如何养育自己的孩子,让他们适应这些技术塑造的世界?当地时间 8 日,《商业内幕》汇总了多位科技领袖以往的采访,整理出他们在育儿方面的一些有趣经验,以及帮助孩子在当今社会取得成功的建议。即使是身家亿...

    来源 腾讯网
  6. ChatGPT突发大规模封号:200美元Pro用户也中招,OpenAI未公布总量

    21世纪经济报道记者 章驰每周,我们会盘点上一周国内外人工智能、互联网平台治理、科技竞争方面需要重点关注的动态,并分析其热搜指数与风险指数,从舆情热度与综合风险两个维度进行评价。 本周重点关注ChatGPT突然大规模封号;广电总局整治微短剧盗脸偷声;苹果调整App年龄分级;幽灵学生借助AI骗取助学金;中国信通院等2..

    来源 腾讯网
  7. OpenAI发布Images 2.6:首度原生生成GIF,周产图量超40亿张

    2026年11月4日,OpenAI推出Images 2.6,首次在ChatGPT中实现原生动态GIF生成——用户可从文字提示词或上传图片直接生成可编辑GIF,支持帧速调节与逐帧修改。API侧同步推出Flare(速度优先)和Sunburst(质量优先)两个模型,定价与前代持平。官方披露的周产图量数据已从9月的逾30亿升至

    来源 AI 行业观察
  8. 突发:OpenAI开始大规模封号!

    机器之心编辑部什么?OpenAI 也开始大规模封号了?今天中午前后,社交媒体炸锅了,一堆人在喊 OpenAI/ChatGPT 大规模封号。很多帖子说得挺邪门:号直接没了,连封号邮件都没收到,登录就显示删号或者登不上。现在有哪些账号被封?从反馈来看,重灾区比较集中,包括:卖过 / 拆过 API 免费额度的号;拼车、多人共

    来源 腾讯网
  9. OpenAI们成苹果真正对手:Siri落后,特努斯催费德里吉交新路线图

    【TechWeb】由于成本上涨剥夺了安卓手机的价格优势,苹果对安卓平台的侵蚀已不再担忧,真正危险的敌人换成了那些AI大厂。 iOS 27.3版Siri虽能实现更多自动化任务,但与最强大的智能体相比仍相去甚远。若不能迎头赶上,一旦OpenAI、谷歌甚至Anthropic有心发布一款集成前沿模型的个人终端,iPhone或许

    来源 AI 行业观察
  10. 苹果Siri明年或变身自主代理,硬刚OpenAI与Meta

    人工智能行业的竞争正从基础对话迅速转向具备独立执行能力的代理(Agent)时代。根据彭博社知名记者马克·古尔曼在最新一期《Power On》时事通讯中的爆料,苹果正计划最早于明年推出自主、代理式的 Siri,标志着这一经典语音助手将从单纯被动响应命令,彻底转向能够主动管理任务并代表用户完成各项事务的智能助手。 锚定行业

    来源 AI 开发者社区
  11. OpenAI们成苹果真正对手,Siri落后或重演诺基亚剧本

    按照规划,苹果将在明年推出可执行复杂任务的自主型Siri,以追赶OpenAI、Meta等头部大厂的脚步。外界则认为,苹果正在耐心等待AI泡沫破灭后进场抄底,以低价收购潜在竞争对手的模型与算力设施——否则,它的Siri将永远由第三方驱动。

    来源 TechWeb
  12. OpenAI们成了苹果真正的对手,Siri落后或重演诺基亚困局

    按照规划,苹果将在明年推出可执行复杂任务的自主型Siri,以追赶OpenAI、Meta等头部大厂的脚步。外界则认为,苹果正在耐心等待AI泡沫破灭后进场抄底,以低价收购潜在竞争对手的模型与算力设施——否则,它的Siri将永远由第三方驱动。

    来源 TechWeb
  13. 千问“死磕”Personal Agent:为什么下限比上限更重要?

    作者 | 褚杏娟Personal Agent 已经渡过早期产品验证,进入了新一轮产品竞争阶段:Meta Muse、OpenAI Dots 等纷纷把产品从“炫技”推向了“长期稳定地替用户做事”。不过,身处一线研发的阿里千问事业部 AI 算法负责人蒋冠军对现状的真实评价是:今天的 AI 依旧不好用。“虽然对话里已经可以点奶

    来源 腾讯网
  14. OpenAI融资110亿美元:估值1.25万亿,总额或达200亿

    根据TechCrunch最新报道,OpenAI在新一轮融资中已成功筹集110亿美元,使其估值达到1.25万亿美元。知情人士透露,这笔资金属于一轮尚未最终完成的更大规模融资计划的一部分,预计在未来几周内全部落定,最终总额有望达到200亿美元左右。 此前在9月下旬,市场曾传出OpenAI计划筹集300亿美元的目标,目前的实

    来源 AI 开发者社区
  15. Edge AI Daily 早报(11月7日)

    Anthropic递交修订版S-1,机构将估值由2万亿美元压至1.5万亿至1.6万亿;OpenAI完成110亿美元首期交割,投前估值1.25万亿,总额由300亿砍至约200亿,AI一级市场进入现金流定价期。中期选举后10州41项数据中心公投多数通过限制,得州、弗吉尼亚监管转向与微软终止甲骨文逾30亿美元租约共振;英伟达

    来源 AI 行业观察
  16. GPT-6.1 Sol三度操刀小鼠脑手术:误差减半至0.3毫米

    OpenAI 旗下 GPT-6.1 Sol 参与活体小鼠脑部手术,连续三次操作后识别解剖标志耗时缩短近半,定位误差从 0.6 毫米降至 0.3 毫米。这一进步靠上下文学习实现,未重新训练模型,相关实验仍处早期探索阶段。#OpenAI#

    来源 IT之家
  17. “印度成OpenAI最大市场”,Altman首次回应“离职潮”:一群聪明人互不信任

    编译|林绮蓓 策划|褚杏娟 创办 OpenAI 之前,Sam Altman 可以在周六下午坐进一家咖啡馆,点一大杯好喝的咖啡,带上电脑,看着周围的世界照常运转。如今,他很怀念这样的日子。 现在,他的日程安排得严丝合缝,已经很久没有随心所欲地做过一件事了。就连去咖啡馆,也不再能像以前一样,做一个无人注意的普通人。 Ope

    来源 AI 行业观察
  18. Shizuku AI推出Shizuku-Duplex:日语全双工模型,为伴侣式AI铺路

    IT之家 11 月 9 日消息,日本人工智能实验室 Shizuku(雫)AI 当地时间昨日公布了其开发的 Shizuku-Duplex,宣称其是继 GPT-Live 后第二个支持日语智能对话的全双工模型,无需完整询问即启动思考流程。在日语方面,Shizuku-Duplex 拥有 6 个参测模型中最高的对话自然性,响应质

    来源 腾讯网
  19. NaiveAI开源Naive-N0.5-Flash:用AI训AI,普通人也能在家造模型

    新智元报道 这两天,MIT的一篇「权重空间编程」博客在AI圈刷屏了。实验里,GPT-6 Astra自己写Python脚本排查诊断,只改了一个0.8B小模型里0.016%的权重,就治好了它的复读死循环,让数学成绩原地暴涨6倍。虽说很快有大神扒出它并不是凭空「心算」权重,本质还是写代码修Bug但博客文末点到的那个词,正是硅

    来源 腾讯网
向下滚动自动加载更多