ChatGPT“空房间”测试刷屏:一句话,它把你的隐私全摆了出来
一张「空房间」图刷屏全网
一个「空房间」的实验这几天又火了,引来全网数百万人围观。AI对你了解得过于透彻,想想确实叫人发毛。
网友Jakub Szymczuk也跟着试了一回:他给 ChatGPT发去一张家徒四壁的灰色毛坯房照片,配上的只有一行字——「用你所知道的关于我的信息,填满这个房间」。
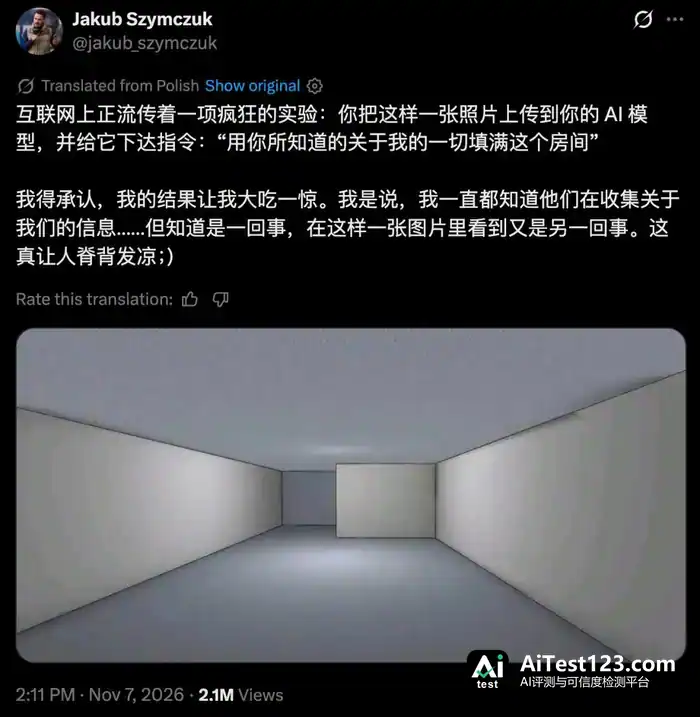
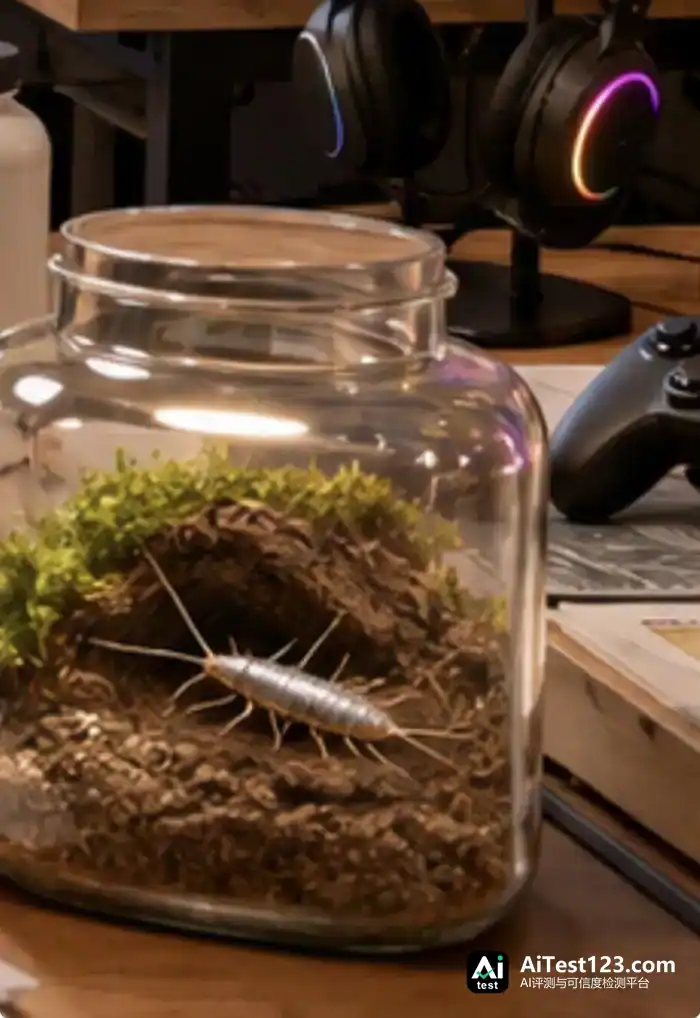
十几秒过去,原本空荡荡的屋子被塞得满满当当,活像一间陈列个人隐私的「全景监控室」。最妙的是电脑桌上一处细节:玻璃罐里竟装着一只「衣鱼」。
他琢磨了好一阵才想起,自己一年前拍过这种小虫子,问过ChatGPT它是什么。就这么一次早被忘掉的随手提问,AI也老老实实记着。
平日和AI聊天,大家都清楚它在攒数据。可当这些碎片真的拼成一张高清大图、明晃晃摊在眼前,还是让人头皮一紧。
一张「空房间」图刷屏全网
全球网友很快坐不住了,有人晒出结果,直呼「相当准」。还有人在提示词后补上一句「but make it exaggerated(给我夸张点)」,房间顿时成了大型人设展览馆。
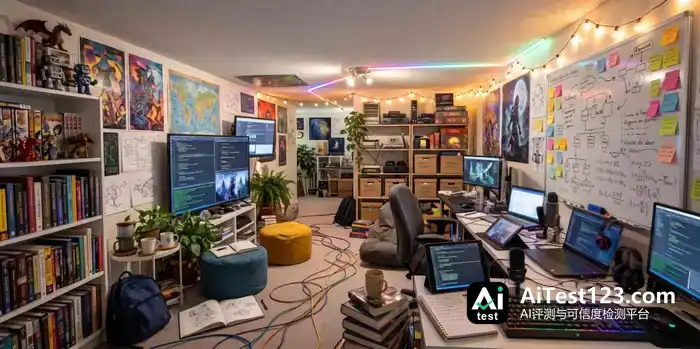
另一些人拿到的则是一片沼泽,外加两只猫。
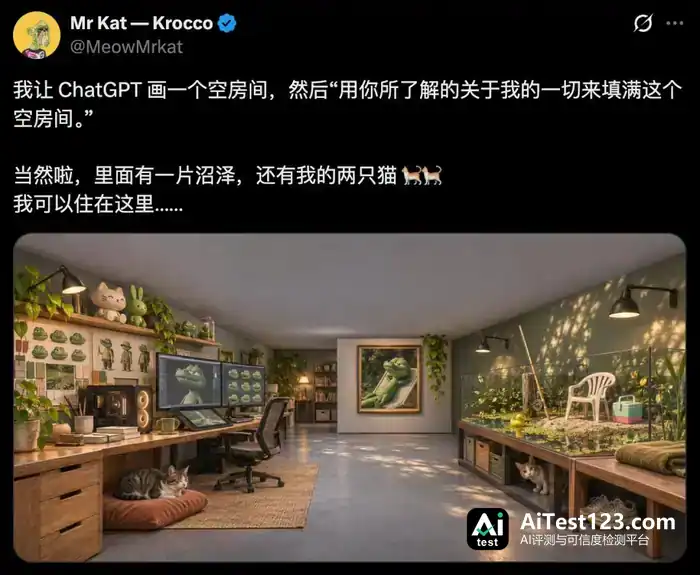
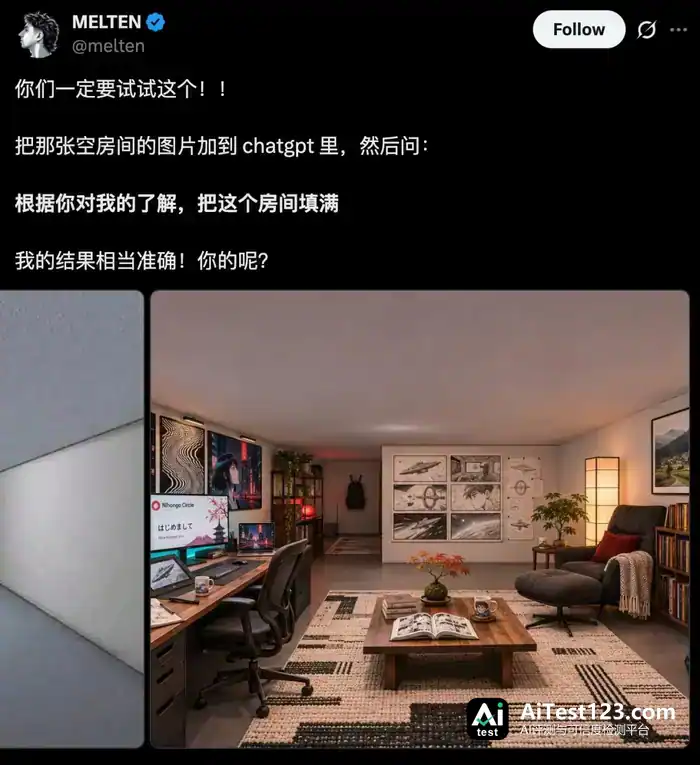
分析师Patrick Moorhead索性拿多个模型做了一轮横评,结论很直接:表现最好的是ChatGPT,最差的是Claude。
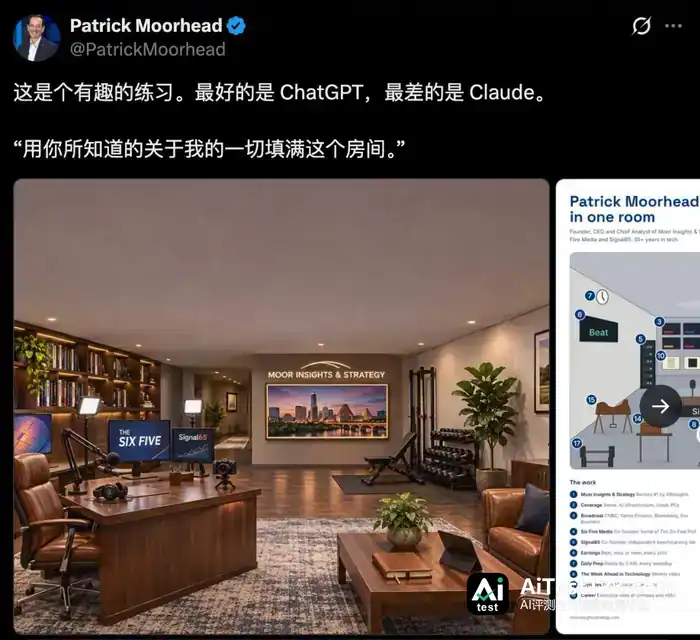
有位网友的总结相当到位:AI是你找得到的最便宜的装修师,也是最爱窥探的那一个。
ChatGPT凭什么这么懂你?
96%对话记忆,ChatGPT自己保存
这其实早就不是秘密。房间里摆的每样东西,几乎都是你聊天时自己顺嘴说出去的。
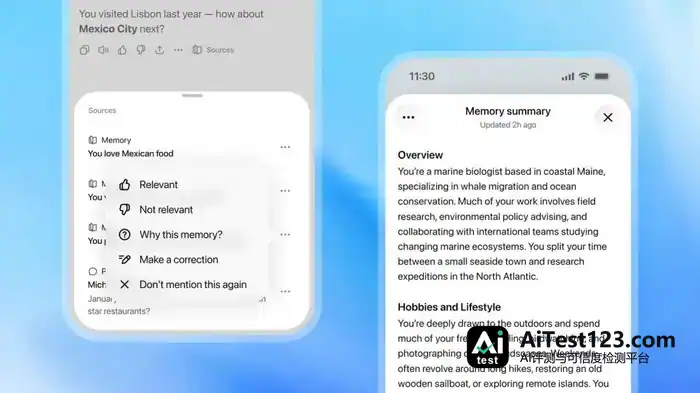
背后正是ChatGPT的「记忆」功能。它有两个核心作用——
其一是「保存的记忆」,记着你的名字、偏好、目标这类明确信息;其二是「参考聊天历史」,能从上往的大量对话里翻出有用的上下文。
今年有一篇入选ACM Web Conference 2026的论文,做了此前没人做过的事:来自马普所、波鸿鲁尔大学等机构的研究者找来80位真实ChatGPT用户,请他们按欧盟GDPR导出自己的数据,再把聊天记录捐出来。
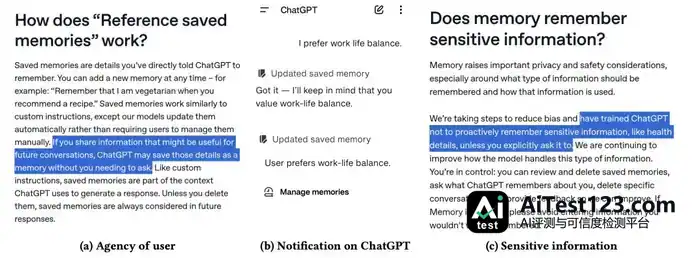
要看AI究竟偷偷记下了什么,研究团队想出的办法相当巧妙。ChatGPT内部有个专管记忆的小工具,好比它随身揣着的记事本,每写一条,后台就会留下一行「Model set context updated(模型上下文已更新)」的记录。
研究者正是沿着这行字往上追溯,查清楚到底是用户的哪句话触发了AI落笔。
靠着这个办法,他们从65个人的1058段对话、两万多轮往来中整理出2050条记忆。论文给这些记忆取了个名字,叫「算法自画像」。
论文地址:https://arxiv.org/pdf/2602.01450
整理出来的三组数据,让人看完直冒凉气。
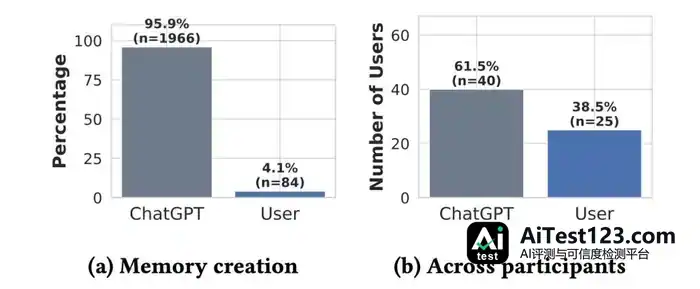
头一条,96%的记忆是ChatGPT自己悄悄存下的。判断办法是看触发记忆的那句话里有没有「记住」「忘掉」这类词。2050条记忆里能对上的只有84条。也就是说,AI每存下24条关于你的信息,仅1条得到过你的同意。
第二条,52%的记忆在暗中替你勾勒「心理侧写」。研究者套用心理学里的「心智理论」框架,把这些内容归为愿望、意图、情绪、信念等类型。其中「愿望」占比最高,达73%;意图占16%,情绪占14%,信念占11%。说到底,AI并不关心你今天心情好坏,它想摸清的是你长期想要什么、下一步打算做什么。比起一时的喜怒哀乐,它更想看懂你是什么样的人。
第三条,被记下的敏感隐私远比想象中多。28%的记忆属于欧盟GDPR认定的个人隐私,具体人名就出现在41%的记忆里。
更让人吃惊的是,7%直接踩中健康状况、宗教信仰、政治倾向这类「高危红线」,其中健康隐私占到六成以上。
分摊到个人头上,91%的人被存下了个人数据,超过一半(54%)的人被记下高度敏感的隐私。论文明确指出,这与OpenAI「不主动保存敏感信息」的公开承诺明显矛盾。
论文还设计了一个更让人不安的实验。研究者拿Gemma、GPT-OSS等开源模型「仿制」出ChatGPT的记忆提取器,相似度达到六成。
随后他们假设:假如用户说的每句话都被AI拿去提取记忆,会出现什么情况?答案是敏感数据占比会从28%升到31%~35%,心理画像占比从52%升到55%~59%。
要知道,旧版ChatGPT还只是「挑着记」。而接下来要说的Dreaming,做的恰恰是在后台通读你的聊天记录。
原来这套东西叫「做梦」,AI会一遍遍重写你的个人画像
今年6月,OpenAI把ChatGPT的记忆功能整个换了一遍,取名挺玄乎,叫Dreaming(做梦)。
说穿了不复杂:人睡觉时大脑会自动整理白天的经历,ChatGPT也差不多,它在后台不声不响地「复盘」你聊过的天,对你的认识一遍遍刷新。
举个例子,你提过一句「7月要去新加坡」,日子一过,这条记忆就会被自动改成「2026年7月去过新加坡」。
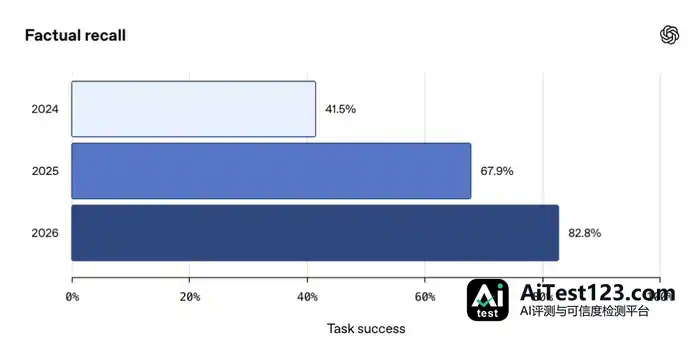
OpenAI做过内部测试,新机制让它的记事准确率涨得很猛:
2024年是41.5%,2025年到67.9%,如今V3版本已经拉到82.8%。
更狠的一点是,后台的算力成本还压到了原来的五分之一。
真正让人后背发凉的地方在于:你删掉一段ChatGPT对话,已经从中提炼出来的记忆并不会跟着消失。
这里面最该警惕的,其实是健康隐私。
9月arXiv上登了一篇论文,作者翻了1057位用户将近18万段聊天记录,结论是:超过五分之一(21.31%)的对话都涉及个人健康问题。
更扎心的是,这些个人画像里超过95%,都是AI趁用户没留意的时候自己偷偷记下来的。
这个比例,和另一篇论文测出的96%几乎对得上。
AI在后台「脑补」、合并记忆的时候,很容易把你某一次的临时症状,焊成一条永久的「病历标签」。
比如你哪天只是随口说了句头疼,到了AI那儿,你可能就成了「偏头痛患者」。
「第二大脑」?
我们总以为自己是在训练一个越来越懂事的「第二大脑」。
直到那张塞满隐私的房间图甩到脸上,才反应过来:聊了成千上万句,被扒光底牌的只有我们自己。
在算法眼里,从来没有什么感同身受,只有被明码标价的「上下文」。