海光推智能体全周期方案:异构算力如何分工
Agentic时代算力底座的关键指标:国产底座、模块化节点、本地部署。

一场由智能体带动的应用变革,正在推动AI底层算力体系重新洗牌。
今年9月,IDC在《2026年中国人工智能计算力发展评估报告》中给出了一组关键预判:全球AI算力需求满足率从2024年的79%一路下行,2027年触底到71%,直到2030年才回到77%。
算力消耗的变化可以用一个简单逻辑概括:Token消耗量≈多智能体协同×单智能体资源消耗×单任务执行次数。智能体持续运行的模式,正不断加大AI基础硬件的负载压力。
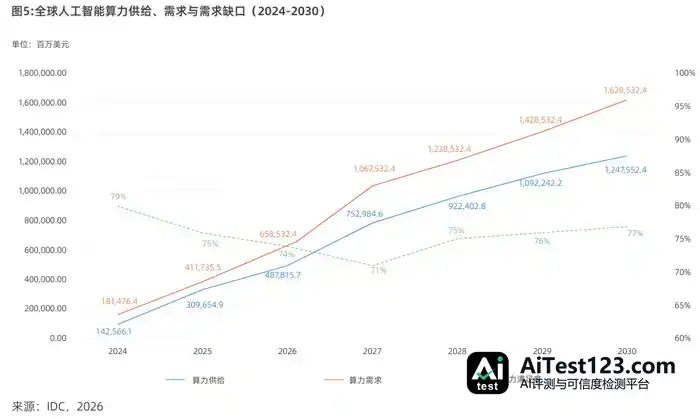
▲2026年中国人工智能计算力发展评估报告(图源:IDC)
于是AI应用和底层算力之间冒出了新的矛盾:智能体要长周期推理、反复多轮规划、高频调用工具、动态调度多任务,这套运行特征给AI基础设施出了一道全新且非标准化的题——不再只盯着FP16峰值算力,时延、吞吐、访存、任务调度、稳定性都成了新约束。
那什么样的基础设施,才算得上Agentic(智能体原生)时代的最优解?
智能体长流程、多轮调用、频繁读写数据的特点,印证了行业早有的一个判断:AI竞赛已经不是单芯片算力的比拼,GPU集群之外,CPU节点和存储节点的价值正被重新审视。
顺着这个思路,我们将开启一个系列专题,沿着智能体思考、编排、推理、记忆、执行的完整链路,探讨异构算力分工、安全隔离、分层存储、交付形态、全栈可控等底层命题,回应智能体规模化落地给AI基础设施出的新考题。
一、拆解智能体工作闭环,性能天花板藏在五大环节里
智能体早已渗入生活与工作的方方面面。眼下火起来的个人AI助手,把任务丢给它就能自动拆解、调用工具,生成完整报告或PPT;编程智能体接到自然语言描述的需求,分分钟帮你开发出应用;视频智能体凭几句话指令,就能完成脚本策划、画面生成和成片剪辑……
和百模大战阶段相比,智能体的竞争不只在模型层面,还延伸到了整套体系能力的较量,基础设施要分别适配不同负载。
模型层充当智能体的大脑,负责感知信息、推理判断、拆解规划,并琢磨怎么调用工具;Harness执行层接住模型输出的指令,完成任务编排、记忆管理和工具调度;知识库是智能体的信息养料,读取企业私有数据、文档与业务资料,为模型输出提供可靠的事实支撑;工具层是智能体执行动作的手脚,既能调用已有系统能力,也能按需生成新工具;沙箱则充当安全隔离层,把智能体和真实业务系统隔开。
在这套架构上,智能体运行会形成接收多模态输入、思考推理、任务编排、工具调用、记忆检索的闭环,循环推进。
底层基础设施的负载特征也因此出现三大明显变化。其一,负载不再是一次性生成就结束,任务属于长链路、多轮次,伴随大量状态读写,对算力和存储的持续性占用模式,与传统大模型推理请求完全不同。
其二,任务调度带有不确定性,执行分支会动态衍生,流程很难提前预判。基础设施得具备弹性调度能力,才能接住意料之外的工具调用和分支跳转。
其三,对基础设施可靠性的要求更高。智能体任务常常要连续跑数十步,中间任何一个环节出现推理异常、调用超时、资源中断,整条业务链路都会失效,重试成本和业务损失都更高。
说到底,智能体的能力上限不再只由模型算法和峰值算力决定,底层基础设施架构能否适配新负载,成了一道隐性天花板。
二、智能体热潮之下的隐性瓶颈,亟需分层解耦算力
那当下的AI基础设施,能完全接住这波智能体热潮吗?答案是否定的。
现有基础设施大多是为百模大战时期的单次生成场景设计的,面对智能体这种间断、随机、高访存的长任务,资源利用率偏低;任务分支随时变化,预先规划好的算力池很容易出现局部拥堵或者资源闲置。
另外,现有体系的容错机制偏单薄,智能体跑了几十步之后一旦出故障,时延和算力浪费都会被拉高,放到企业业务场景里还会带来业务风险。
智能体应用越铺越广,应用方与底层基础设施厂商之间开始形成深度协同的硬需求。硬件厂商的角色已经不只是把芯片、服务器交出去:一手往下打磨硬件底座,一手往上适配智能体的完整工作流。
智能体整条链路里,各阶段吃硬件的方式差别很大,资源得按任务特征去配。
推理和多模态生成这两环,对显存容量、带宽要求极高;DAG任务编排、循环自检、沙箱内工具调用里有大量分支判断、状态持久化和外部接口IO,更依赖CPU并发与内存;向量检索、知识库查询、长上下文KV缓存路由属于高吞吐随机检索负载,交给存储优化型节点更合适。
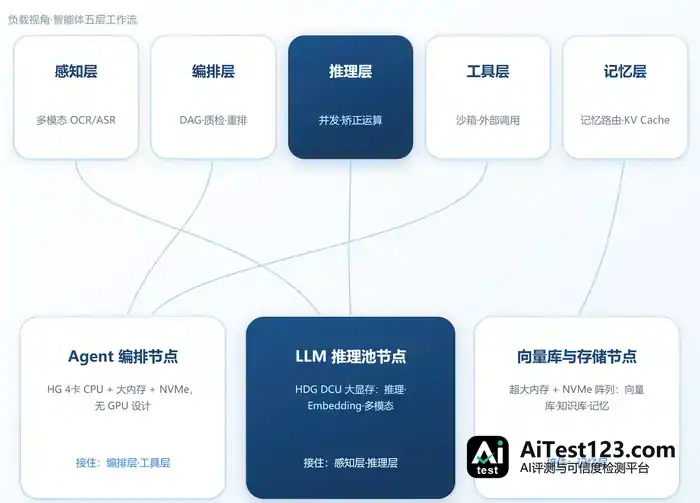
算力分层解耦之后,不必再为统一架构做妥协,高价显卡空转、检索环节资源拥堵这类错配可以避开,智能体链路能从目标输入一路低成本、稳定地跑到结果交付。
三、海光掏出Agentic时代最新布局:国产底座、模块化节点、私有化部署
智能体对算力提出的这些新要求,落到基础设施企业身上,角色也在变:从单一算力硬件供应商转向全栈协同伙伴。以前是大模型提供商去适配现成算力,往后可能反过来——底座跟着上层智能体负载迭代,双方互相推着走。
对大多数算力厂商来说,CPU高并发、DCU推理加速、分层存储、安全沙箱要一起补齐并不轻松。这条能力曲线恰恰是海光深耕数年的主线。
从即将发布的基于海光路线的系列整机产品,能看出海光服务器在智能体时代的新思路:联合产业链上下游伙伴,做一套适配Agentic时代的完整产品组合。
思路落成两条产品路径。一条面向云端与大型数据中心,主打模块化节点组合,含智能体编排沙箱节点、LLM推理节点、向量库及记忆节点三类专用节点,各管一摊、协同调度,业务可按需弹性扩缩,适合大规模智能体集群运营。
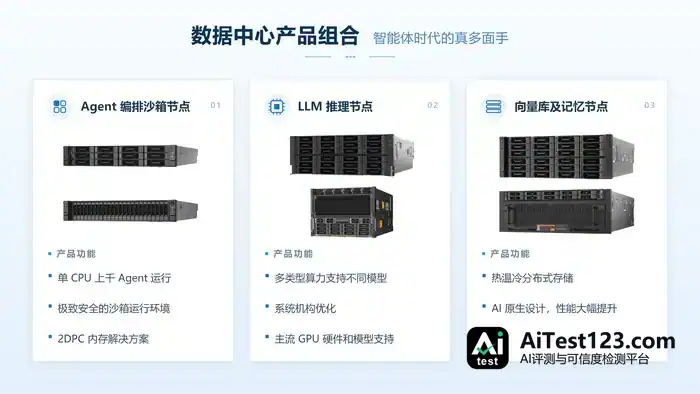
智能体编排沙箱节点以CPU为核心,单节点能承载上千个智能体并发运行,支持CSV文件处理,提供隔离可靠的沙箱执行环境;16路内存通道、支持2DPC,智能体高频状态读写和本地记忆存取的性能需求有着落。
LLM推理节点可适配OAM模组、高密度多卡集群、超节点等多种形态负载,把GPU算力和Token吞吐放得更大,主流GPU硬件与大模型都能兼容。
向量库及记忆节点走热温冷分布式存储架构,全闪、混闪、大容量归档存储分层都覆盖,是为AI原生场景设计的。
云端集群解决的是海量智能体并发、弹性调度的规模化难题。可大量政企、金融、制造场景还有强合规、数据不出园的刚性约束,第二条交付形态由此而来:面向企业私有化场景的AgentServer Flex智能体算力矩阵。
单套配置由3–9台编排/LLM/存储节点组成,按需组合、弹性扩展,能快速对接软件伙伴链条,终端客户上线交付也快。
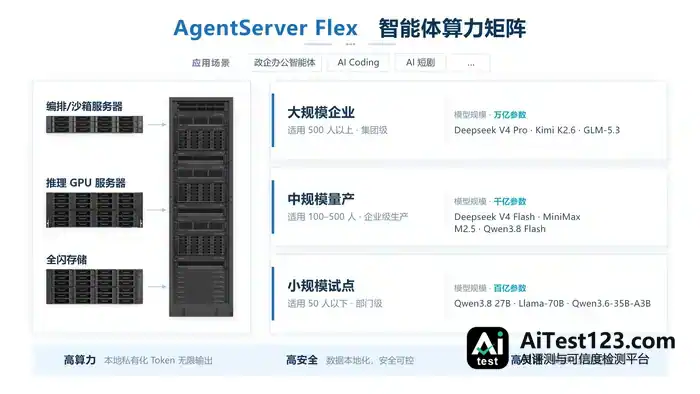
私有化方案让数据留在本地、不出园区,安全合规诉求顾得上,企业部署周期也能压缩,集成与运维成本随之降低。
整套方案还有一层底座保障:依托国产CPU+国产DCU搭建,对齐主流x86性能基准,从芯片到整机柜全链路自主可控,交付确定性有保证。
智能体浪潮真正的底层变化,是算力需求从单一模型推理扩展成包含调度、思考、记忆的复合负载。过去一套通用算力集群包打一切,推理吞吐、IO并发、记忆检索这些完全不同的负载很难兼顾。海光这套分工清晰的数据中心产品组合,回应的正是智能体全链路的差异化诉求。
结语:从对话到自主执行智能体,正重新定义AI基础设施
智能体浪潮带来的变革不止于一个个自动执行的AI助手,它在重塑整条AI产业链上下游的合作关系。AI应用侧需求上规模之后,上层创新与底层基础设施的深度协同,已经从加分项变成必选项。
接下来,我们会推出系列专题,把海光这套面向Agentic时代的新产品组合当作观察样本,逐项拆解:当AI从对话生成迈向自主执行,下一代基础设施究竟该具备哪些核心要素。