智能体 Skill 调优“焚诀”——业务逻辑之外的胜负手
阿里妹导读文章内容基于作者个人技术实践与独立思考,旨在分享经验,仅代表个人观点。引子:37 个技能的"能跑"与"能用"今年5月底,我们在某AI投研平台做了一件事:借助 Coding Agent,4 天完成了 37 个投研技能的创建与集成(一次性新增 36 个技能目录)。股票研究、行业分析、宏观策略、研报摘要……每个技能
阿里妹导读
文章内容基于作者个人技术实践与独立思考,旨在分享经验,仅代表个人观点。
引子:37 个技能的"能跑"与"能用"
今年5月底,我们在某AI投研平台做了一件事:借助 Coding Agent,4 天完成了 37 个投研技能的创建与集成(一次性新增 36 个技能目录)。股票研究、行业分析、宏观策略、研报摘要……每个技能一个目录、一份
然而从试运行开始,三类问题接踵而至:
- 路由不准。投研人员的问题是口语化的——"这票怎么看""它跟同行比贵不贵",经常分不到正确的技能上。
- 上下文爆炸。每个 AI 生成的技能都"大而全",单技能提示词高达 ~6000 token,成本高、响应慢,更麻烦的是规则之间互相干扰。
- 输出不可信。溯源标注乱标、多来源分歧被悄悄掩盖、用户指定的时间范围被静默放宽——在投研这种对数据严谨性零容忍的场景,任何一条都足以让用户弃用。
回头看,这三类问题没有一个出在业务逻辑上——估值怎么算、研报怎么读、行业怎么比,AI 初稿写得有模有样;翻车的全在业务逻辑之外:路由、结构、规则与边界约束。从"能跑"到"能用",我们花了随后数周持续打磨,直至上线后仍在根据现场 AI 一天能帮你生成 37 个 skill,但"能生成"距离"能生产",隔着一整套工程体系——路由分得准、结构拆得省、规则写得狠、案例配得真、评测兜得住。
1 运行时视角:skill 到底是什么
在讲怎么优化之前,先建立一个贯穿全文的运行时视角。skill 不只是一份静态文档,而是 read_file 按需注入。展开来说,它由三种成分构成,各自服从不同的"物理规律":
| 常驻索引(description / 聚合索引) | |||
| 按需知识(templates 正文) | read_file 注入 | ||
| 外部确定性约束 |
明白了这一点,"生成快、打磨慢"的原因就清楚了:**"生成快"是因为 skill 只是文本;"打磨难"是因为它是参与每轮路由与注意力分配的运行时组件。** 后文每一处"怎么改",都会回到这张表来解释"为什么"。
2 什么叫"生产级 skill"
我们给出五条判定标准,也是全文的总纲:
- 可路由——用户的口语化问题能被准确分派到正确的技能;
- 可治理——规则结构分层、有唯一权威源,改一条规则不用动几十个文件;
- 可溯源——每个数据与判断都能追溯到知识库来源,缺口显式披露;
- 可评测——每一层都有可回归的评测集,改动前后效果可量化;
- 可迭代——现场
下面按"意图层 → 套件整合 → 细节调优 → 评测闭环"的顺序展开,每一处优化都遵循同一个论证结构:AI 初稿的问题 → 生产级要求 → 怎么改 → 为什么(运行原理)。
一、意图层:
skill 的路由器,先于 skill 本身
核心观点:skill 写得再好,意图分错全白搭。意图层是技能套件的第一道质量闸门,值得先于技能本身投入。
1.1
AI 初稿的问题:批量生成技能时,最自然的做法是"一个话题一个技能"——公告解读一个、商业模式一个、可比估值一个……37 个技能对应 37 个平铺意图。结果是意图之间边界模糊,分类器在几十个近义选项里挣扎。
第一次收敛失败:我们先把平铺意图收敛成 9 个"话题式"二级意图——公司基本面、比较分析、事件驱动、行情异动、研究观点……看起来清爽了很多,但离线评测(370 样本)暴露出结构性混淆:无论加例句还是加判别规则,"历史比较"类问题的准确率始终在 10%~40% 之间打转,"风险提示"类最好也只到 40%;更棘手的是,"公司基本面"成了黑洞意图——估值分位、盈利预测、投资逻辑的问题统统被它吸走。病根很直白:"茅台估值在历史什么位置"到底算比较、基本面还是行情?——按话题切分的意图,边界在语义上天然重叠。这是结构问题,提示工程救不了。
"黑洞"长什么样,把绿框对角线 = 分类正确,红色虚线框即黑洞列,红字为被其吸入的错误样本数):
"公司基本面"意图除自身 50 个正确样本外,另有 5 个意图共 28 个样本被错误吸入——比较分析、事件驱动、行情异动、研究观点、投资策略各漏 4~9 个,该列 precision 仅 0.641。这不是某个意图写得差,而是"公司基本面"这个话题与半数邻居天然共享语义空间。
怎么改:深入分析现有 9 个意图之间的范式差异重新切树,根意图类型 RESEARCH_QA 下收敛为 6 个"范式式"二级意图:宏观策略、行业跟踪、个股研究、研究活动、研究纪要、投顾服务。个股研究下的 11 种子能力(业绩快评、可比估值、公告解读……)共用同一个二级意图——它们的问句特征相似、真正的差异在分析方法,这种细粒度分流交给技能层内部的路由表去做(见 2.3 节),不让意图分类器承担超出其分辨率的任务。
效果:新
残留错误高度集中在"个股研究"一行:全部 30 个错判中 25 个由它外漏——11 个流向投顾服务(多为"写深度报告"类问法)、6 个流向研究纪要("整理研报观点/提炼管理层表态"类)、4 个流向研究活动。注意方向与旧树正好相反:旧树的"公司基本面"是往里吸的黑洞(precision 0.641),新树的"个股研究"是往外漏(precision 1.000、recall 0.889)——错误单向、边界清晰,后续针对这一个意图补例句、加判别规则即可收敛,与旧树"半数意图彼此纠缠"的结构性混淆有本质区别。
为什么:分类是在候选集里做判别,候选越多、语义越近,错误率越高;"话题"天然共享语义空间(同一问句常同时命中两个话题),"范式"才是互斥的。两级路由把"几十选一"拆成"六选一 + 技能内表格路由",每一级都在自己分辨率能力内工作。意图树结构决定分类准确率的天花板,例句和规则只能帮你逼近天花板。
1.2 意图映射:让路由条件结构化、可热更
意图识别出来之后,怎么映射到技能?我们的映射配置(intent_skill_mapping.json,v5.0.0)长这样:
{"intent_type": ","intent_name": "个股研究综合","description": "覆盖个股基本面问答、业绩快评、研报摘要、可比估值……","skills": ["research_baseline", "stock_research"],"strategy_priority": {"core": ["stock_research"],"secondary": ["research_baseline"],"supplementary": []},"typical_questions": ["这家公司基本面怎么样", "对比一下A和B的估值", "..."]}
三个设计点:
[规则基座, 聚合索引]二元组:每个意图固定映射为"全局合规基座 + 一个业务聚合索引",技能加载的最小单元不是单个技能而是"基座+业务"组合(基座是什么,第二章展开)。typical_questions作为 :每个意图带一组真实业务风格的典型问句。这是一个"活例句库"——业务同学看得懂、改得动,同时它也是后续评测集的种子(第四章会回收这条线)。- Redis Pub/Sub:映射配置支持不发版调整。现场跟客户对齐意图边界是高频操作,热更能力让"改一条映射"从发版级操作降为配置级操作。
这套设计的效果,我们在 v2 评测集(370 条真实业务风格问句,classifier-only 模式)上做过一组消融实验:
两个超出直觉的结论:
- 例句 few-shot 买的主要是"确定性",不是准确率。+2.4pp 的准确率提升并不惊艳,但兜底率从 4.59% 降到 1.08%、P95 延迟从 9552ms 降到 3743ms——例句给了模型可对照的判别锚点,它不再犹豫到走 fallback;对短句带指代的高难度扰动问句提升最明显(81.08%→86.49%)。
- 准确率的主力是行内旧系统沉淀的判别经验(在例句基础上再 +10.27pp)。我们把旧系统意图分类提示词里的边界裁决规则(比如"业绩预告类问题归事件驱动还是基本面"这类判例)提炼合入了分类 prompt。对所有做新旧智能体迁移/替换的团队,这条经验值得记住:旧系统最值钱的资产往往不是代码,是它积累的判别规则。
例句为什么有效:分类器需要的是判别边界,不是语义概括——"覆盖宏观经济数据解读、政策影响……"这类抽象描述划不出相邻意图之间的界线,而一条落在两个意图边界上的例句,胜过一段笼统的定义。
1.3 改写管道:分类前先把问题治理干净
投研人员的原始问句充满口语、错别字和指代——"它去年赚了多少"。直接送分类器,再好的意图树也救不了。
我们在分类前置了一条四阶段改写管道(
值得强调的设计决策:改写是公共前置,不是分类器的私有逻辑。改写后的规范问题同时服务于意图分类和知识库检索——一次改写,两处受益。
1.4 工程可用性:回退、缓存与短路
意图层在生产上还要解决三个工程问题:
- 失败回退:LLM 分类调用失败时回退到规则匹配,保证意图层永远给出答案而不是抛异常;
- 缓存:意图结果进 Redis 缓存,应对用户连续追问同一主题;
- FAQ 向量化短路:高频标准问句启动时预先做 embedding 向量化,查询时算余弦相似度,超过阈值直接命中固定答案,跳过整个意图引擎与 Agent 推理。
为什么:这三条共享同一个原理——确定性逻辑外置。能用相似度检索、规则判定解决的,就不要进 LLM——模型负责推理,外部系统负责状态和边界。FAQ 短路省下的不只是钱,更是高频问题上稳定一致的响应。
还有一个工程决策值得用数据说话:意图分类该用多大的模型。我们在 v1 评测集上对比过同一套配置下的两档模型——25B:准确率 89.19%、兜底率 1.89%;235B:准确率 88.11%、兜底率 4.59%,P95 延迟还更差。单次运行、370 样本,1pp 的差异不具统计显著性,但至少说明大模型在这个任务上没有优势:意图分类是窄判别任务,判别边界由例句和规则给出,模型规模不是瓶颈。更贵的模型带来的提升,很多时候没有想象中那么大;也正是平台按任务角色独立配置模型(对话、意图、改写等角色各自选型)这一架构的价值兑现:意图角色放心用小模型,把大模型留给真正需要它的
1.5 意图层优化 checklist
二、套件整合:
从 37 个平铺目录到三层专家套件
核心观点:AI 批量生成的技能天然是"每个都大而全"的平铺结构;生产级的解法是把"合规规则、业务路由、分析范式"拆成三层,按需加载。
2.1 平铺结构的三宗罪
37 个技能各自为政地运行了两天后,问题看得很清楚:
- 规则重复:溯源规范、数据缺口处置、可视化规范……这些跨业务通用规则在 37 个文件里各写一遍,且随着单点修改开始版本漂移——A 技能里溯源规则是新版,B 技能里还是旧版,模型行为随路由结果摇摆。
- Token 浪费:单技能 ~6000 token 全量注入,其中大半是与当前问题无关的"其他子场景"规则。
- 维护失控:改一条通用规则要动 37 个文件,漏改一个就埋一个雷。
为什么这是必然的:这不是 AI 生成质量差,而是撞上了上下文工程的基本规律——Context Rot。Transformer 注意力复杂度是 O(n²),上下文越长,关键信号越容易被噪声稀释;问题通常不是窗口不够长,而是信息密度不对。
2.2 三层架构:合规、路由、范式各归其位
对此,我们做了一次彻底的分层重构,把 37 个平铺技能整合为 1 + 6 + 19 的三层套件:
三层各自回答一个问题:
- L1 基座(research-baseline)——"怎么做合规"。唯一数据源、溯源标注、范围约束、缺口处置、可视化骨架,任何意图必读;
- L2 聚合索引(6 个)——"这个业务怎么路由"。核心是一张子能力路由表加执行步骤,外加少量业务专属约束;
- L3 模板(19 个)——"这类分析怎么做"。单一分析范式的工作流与输出结构,例如公告解读模板就只管公告解读的六步工作流。
层与层之间的关系被明确写进规则:基座声明"业务 SKILL 中不重复列出本基座已规定的内容",聚合索引开头声明"基座中已规定的铁律、通用陷阱、通用清单不在此重复",模板开头声明"本模板执行前提:已遵循 research-baseline 全部铁律与通用规范,以下仅列出本业务增量约束"。每一层只写自己这一层的增量。
为什么是三层:对照通用的上下文分层模型——常驻层(短、硬、可执行)/ 按需加载层 / 运行时注入层 / 系统层(代码规则,不进上下文)——基座+聚合索引对应常驻层,模板对应按需加载层,时间范围提示等对应运行时注入层,代码护栏(第三章)对应系统层。三层技能架构本质上是这个通用模型在投研垂直领域的实例化。
2.3 description 只写 when to / not to use
这是套件整合里最值得单独拿出来讲的一个细节,因为它最反直觉、也最普遍地被做错。
AI 初稿的问题:让 AI 生成技能,description 十有八九是功能简介——"本技能提供公告解读能力,覆盖定增、回购、重组、股权激励等公告类型的解读与影响评估……"。看起来专业完整,实际对路由几乎没有帮助。
生产级写法:description 是路由条件,只回答三件事——什么时候该用我、什么时候不该用我、产出物是什么。"何时该用"远比"我能做什么"重要。
为什么(按需加载的两阶段分工):Skills 模式的本质是系统提示只保留索引、完整知识按需加载。description 常驻每轮请求,它在运行时的唯一职责是让模型判断"当前问题要不要加载我";而一旦命中,这个技能能做什么、怎么做,模型在加载后自然全部知道。所以把功能简介写进 description 是双重浪费:对路由判别没有增量(判别需要的是使用边界,不是能力罗列),又为"加载后才会用到的信息"提前支付了每轮常驻的 token 成本。
数据对照也很直接:45 token 的功能简介与 9 token 的"Use when deploying to production or rolling back",路由准确率相当,常驻成本却差了 5 倍,每个启用的 Skill 描述符都常驻上下文,Skill 一多,长描述的累积成本很可观;但反过来,描述过短过泛("help with backend")会让任何后端问题都触发它,路由混乱。短和准是两个独立要求,缺一不可。
我们的落地形态是把这条原则贯彻到路由发生的每一层:
意图层:映射配置的 description 界定范围 + typical_questions 承担判别样本(等价于 Use when 例句集);
聚合索引层:子能力路由表设计了"触发场景 / 不适用场景"双列——这是表格化的 Use when / Don't use when。摘一行真实的:
子能力 触发场景(用户问题特征) 不适用场景 模板路径 业绩快评 业绩公告/快报/预告、超预期判断、单季度趋势分析 完整财务质量诊断、深度报告 templates/earnings_flash.md模板层:每个 L3 模板开头都有"适用场景 / 不适用于"双向声明,例如公告解读模板:"当用户需要解读上市公司公告及评估影响时使用。不适用于业绩分析或研报摘要。"
注意"不适用场景"这一列:它不是可有可无的补充。近义技能之间的路由错误,绝大多数发生在边界上,而负样本恰恰是划边界最直接的方式。描述不带反例时,路由准确率从基准 73% 掉到 53%;补上反例后升到 85%,响应时间还降了 18.1%。反例不是可选项,是描述能不能起路由作用的关键。
这条原则同样适用于工具描述。调试 Agent 时应优先检查工具/技能定义,大多数选择错误的原因出在描述不准确,不在模型能力。路由 bad case 十有八九改的是描述和路由表,不是分类器。
2.4 按需加载:token 省 80% 背后的机制
三层架构的运行时机制:Agent 框架只识别各技能根部的 SKILL.md;L3 模板不随技能加载,而是由 Agent 在 ReAct 循环中根据路由表判定后,用 read_file 动态加载。
两条关键约束直接写进聚合索引的执行步骤:
判定子模式:根据用户问题与路由表"触发场景"列匹配,选定 1-2 个最相关子能力(大多数非符合问题情况仅 1 个)
按需加载模板:调用 read_file 仅读所选子能力对应的 templates/*.md,严禁一次性读取全部 11 个 templates
第二条看起来多余,实际非常必要——没有这条禁令,模型偶尔会"图省事"把模板全读一遍,按需加载瞬间退化回全量注入。
收益:单技能上下文从 ~6000 token 降到 ~1200 token,**节省约 80%**。
连带成本:按需加载意味着 ReAct 循环里多了"读模板"这类迭代步骤,叠加多轮检索后容易触顶迭代上限导致提前终止。为此我们把推理迭代上限 AGENT_MAX_ITERS 提升到了 20。
不止省钱(:LLM 推理的 KV 缓存按精确前缀匹配命中——系统提示与常驻索引若保持稳定,这部分的计算在多轮请求间可复用(读取折扣可达 90%)。三层架构恰好是缓存友好的:基座+聚合索引常驻且极少变动(稳定前缀),模板按需追加在稳定前缀之后(不破坏缓存)。所以"常驻层短而稳定"是双重收益:省 token,且保缓存命中。稳定的大基座比频繁变动的小提示实际成本更低——这也解释了为什么我们敢让基座长到 364 行:它稳定,所以便宜。
2.5 一条规则只写一遍:一处定义、处处引用
分层解决了"规则住哪一层",Skill 套件还有一个更隐蔽的问题:同一条规则出现在两个地方。我们的答案是——一处定义、处处引用:
- 主提示词只做"场景规则路由"声明,不展开任何投研专属规则——主提示词要同时服务多个通用场景,不能只为投研这一个场景写规则;
- 基座是唯一权威定义源,并在文末显式声明:"业务 SKILL 与各 templates 仅以语义化引用(如『参见基座铁律 X』)复用本基座,禁止复刻或改写本基座条款";
复杂规范(如来源文档展示格式)在基座内也标注"以上规则为本基座的唯一权威定义源;任何业务 SKILL 或 template 不得重复或改写"。
为什么:这对应一个经典反模式——把系统提示当知识库:系统提示越长,关键规则越容易被忽略;约定留在常驻层,领域知识移到按需层。那些"禁止复刻"的声明防的则是双写风险:同一条规则两处版本各自漂移,模型面对互相矛盾的指令,行为不可预测。这就是软件工程
落地补记:规则住进"该在的地方",前提是模型接得住。 上面这套规矩在我们项目里不是一步到位的。溯源标注等核心规则最初写在 Agent 主提示词中,而非 research-baseline——这是当时有意的选择:早期使用的主模型在知识库问答的长输入场景中对 skill 指令的遵循能力差,同一条规则,即使技能已被命中加载,写在 SKILL.md 里的执行效果也明显差于写在主提示词里。要让规则"管用",就只能放主提示词,治理方向也随之向主提示词倾斜,baseline 反而精简成指向主提示词的引用声明。后期更换了更强的主模型:新模型对已加载 skill 正文的遵循度过关之后,我们做了反方向的重构,将投研专属规则放回它本来该在的地方(skill 体系内)。
这段弯路给出一个容易被忽略的判断:规则落点不只是架构问题,还受模型能力约束。弱模型时代的妥协可以接受,但要记账:模型升级后及时清偿,否则临时妥协会沉淀为永久债务。这与前文 1.4 节"意图分类放心用小模型"恰是一体两面:窄判别任务可以省,承接 skill 正文的主对话模型不能省——合起来,才是"按任务角色配模型"的完整图景。
三、bad case 驱动的细节调优:
规则是在现场打磨出来的
核心观点:基座里每一条带 ✗/✓ 对例的规则,背后都是一个真实 bad case。本章拆解六个典型案例,然后归纳出一套可复用的修复方法论。
3.1 六个典型案例
以下案例全部来自客户现场真实反馈,按"现象 → 归因 → 落点 → 写法"拆解。
案例一:溯源标注被模型"美化"
现象:我们要求模型在引用数据的句末标注来源编号<1>,前端据此渲染引用气泡。上线后发现模型经常"好心"地美化标注——<sup><1></sup>、[<1>]、【1】、^1……前端解析全部失败。
归因:模板层规则太"理想"。只说了"标注 <X>",没有限制变体——而 LLM 会有排版美化倾向,规则没封死的自由度,模型有用掉的风险。
落点与写法(基座铁律 4):防御性枚举,把所有见过的变体逐一列为禁止项:
溯源编号必须以纯文本 angle-bracket 形式直接输出,严禁使用任何 HTML 标签或其他符号包裹——禁止 <sup><1></sup>、<sub><1></sub>、[<1>]、【1】、^1、(1) 等任何变体,仅允许形如 <1>、<3><5> 的纯文本写法。
案例二:分歧数据伪装成区间
现象:知识库里研究员 A 预测某公司净利润 1.6 亿、研究员 B 预测 2.0 亿,模型输出"预测净利润为 1.6-2.0 亿元"。看起来通顺,实际是重大错误——两个独立观点被伪装成一个数值区间,分歧被掩盖,用户完全无法察觉这是两个人的不同判断。
归因:这是 LLM"追求流畅"的天性与投研"分歧必须显性"的业务铁律的正面冲突。不显式禁止,模型永远选流畅。
落点与写法(基座铁律 7):规则 + 正误双格式对例:
严禁以连字符区间(如 "1.6-2.0")呈现分歧数据——连字符会被误读为数值范围而非两个独立判断。
✗ 错误:"预测净利润为 1.6-2.0 亿元"(连字符伪装为区间,掩盖了分歧来源)。
✓ 正确:"研究员 A(6 月 12 日)预测净利润 1.6 亿 <1>,研究员 B(6 月 9 日)预测 2.0 亿 <3>"。
表格场景另配格式:单元格内以 / 分隔,表格下方以 > 引用块逐条附注来源。
现场效果:这条规则的增益不止于"不再伪装区间"。部分测试问题会同时命中知识库里多位研究员的观点,且分歧散布在多个维度——盈利预测、估值判断、风险提示各说各话。优化后的 skill 会主动以对比表格呈现:分歧维度为行、研究员为列,单元格内是各自观点并附来源标注,谁在哪个维度持什么判断一目了然。规则本身只规定了"分歧必须显性、表格内如何标注",多维多人的结构化对比是模型在这套约束下自发组织出来的——狠规则不只堵住坏行为,也给好行为立了模板。
案例三:伪文档名与重复来源
现象:回答末尾的参考来源列表里出现"15-1-20260226-光伏设备调研反馈"这样的条目——模型把检索切片编号拼接进了文档标题,构造出知识库里根本不存在的"伪文档名";同一文档还因多个切片命中被重复列出。
归因:检索工具返回结构里有多个"看起来像标题"的字段——顶层 title(真正的文档名)、正文里的 <title>标签、切片编号。模型分不清哪个是权威来源,就自己拼一个。
落点与写法(基座"来源文档展示格式规范"节):这一节是全套件里防御密度最高的规则,三招并用——
- 把工具返回结构原样贴进规则当教材,让模型"见过"真实数据长什么样,明确指出唯一合法来源是文档名称(metadata.title);
枚举四种踩过坑的错误形态(从正文提取标题 / 拼接编号前缀 / 拼接组合 / 重复列出)逐一给 ✗ 例; 在交付前"最终确认"清单里再问一遍:"是否确认参考来源中的文档名未被拼接任何切片编号前缀/后缀?"
案例四:时间范围被静默放宽
现象:用户问"2018 年的数据",库里没有 2018 年,模型默默用 2019 年的数据作答且不做任何说明。用户以为拿到的是 2018 年数据——这在投研场景是致命的。
归因:模型的"乐于助人"倾向:宁可放宽约束也要给出答案。而业务要求恰恰相反:宁可范围内为空,也不得混入范围外数据。
落点与写法:这个案例的修复横跨 prompt 和代码两层,很有代表性:
- prompt 层(基座铁律 6 + 数据缺口新增"范围过滤为空"类型):范围内无匹配时必须披露三层信息——① 指定范围内未检索到;② 库中实际可用的时段;③ 建议用户调整范围或确认是否接受范围外参考。并为流式输出场景设计了"同轮披露 + 分隔线 + 『以下为范围外参考(仅供对照,非正式结论)』"的降级方案——流式响应无法中途等用户确认,规则必须适配交付形态。
- 代码层(research-baseline v1.3.0 配套,上线后迭代):前端显式指定时间范围时置 dateFromUser=True,此时代码直接忽略 LLM 生成的时间参数,强制使用前端值。时间约束从"提示模型遵守"升级为"系统保证遵守"。
案例五:检索 query 碎片化与重复检索
现象:两个方向的翻车。一是模型把"XX蓝筹精选近一年收益率是多少"拆成 query="基金 净值 涨幅"去检索,召回质量骤降——现代检索服务对完整自然语句的理解远好于关键词碎片;二是首轮没检索到理想结果时,模型无目的地反复检索,token 燃烧、循环触顶。
落点与写法(基座铁律 8、9):一收一放
铁律 8(首轮不拆分):首次检索必须直接使用用户原始问句作为 query,严禁拆分成多个短语或关键词,严禁改写、翻译或抽象。
铁律 9(多轮递进,充分即止):仅两类场景允许补充检索(首轮不足以支撑回答 / 发现需展开的关联主题);单轮对话最多检索 5 次,达到上限必须基于已收集切片作答。
同时上线代码护栏 RAG_MAX_RETRIEVE_PER_TURN:超限后检索工具只返回简短提示文本,不再把完整结果重复注入上下文——即使模型不听话,系统也兜得住。
案例六:Mermaid 节点文字溢出
现象:我们要求趋势类回答输出 Mermaid 时间轴图,现场反馈图表"破相"——节点文字太长,渲染后溢出方块边界。
归因:这是一类容易被忽略的 bad case:问题不在内容而在交付形态。模型不知道前端渲染器的物理约束。
落点与写法(基座可视化规范第 8 节):把渲染约束翻译成模型可执行的文字规则——每节点总字数 ≤15 字、单行 ≤8 字、超长在语义合理处插 <br/> 换行、最多 2 行,配 ✗/✓ 对例(A[🟢光伏装机量持续超预期增长] → A[🟢光伏装机<br/>持续超预期])。
3.2 一个"正向增强"案例:前置量化归因
上面六个案例都是"纠错型"调优——守下限。现场反馈还有另一类:"抬上限"的范式增强。
现场意见:客户投研总监反馈,个股分析的输出"定性有余、定量不足,缺一个全文的定量锚点"。
怎么改:我们在 stock-research 聚合索引里增设「前置量化归因」模块:公司层面的基本面判断,报告正文第一段必须先输出「核心驱动因子量化摘要」,按固定五步生成——因子识别(1-2 个公司特异性经营变量,拒绝"营收增长"这类泛化指标)→ 历史 3 年 CAGR → 未来 2-3 年前瞻预测 → 沿"收入→毛利→净利"的利润表传导测算 → 每个关键数字标注假设来源。
**这个案例的方法论价值在"适用性分级"**:规则没有一刀切地套给全部 11 个子能力,而是三级划分——
- 强制适用(7 个模板):thesis_qa、earnings_flash、deep_report 等公司层面基本面判断;
- 条件适用(announcement):仅业绩公告、重大合同等可传导至经营因子的事件才量化,普通减持、诉讼不强制;
- 不默认适用(3 个模板):research_digest 以观点聚合为主、comparable_valuation 以相对估值为主、portfolio_attribution 以组合归因为主,各有自己的定量范式。
纠错型规则要"狠"(枚举封死),增强型规则要"准"(给足适用边界)——两类调优的写法是不同的。
3.3 方法论提炼:bad case 修复五步法
六个案例走下来,修复动作可以固化为五步:
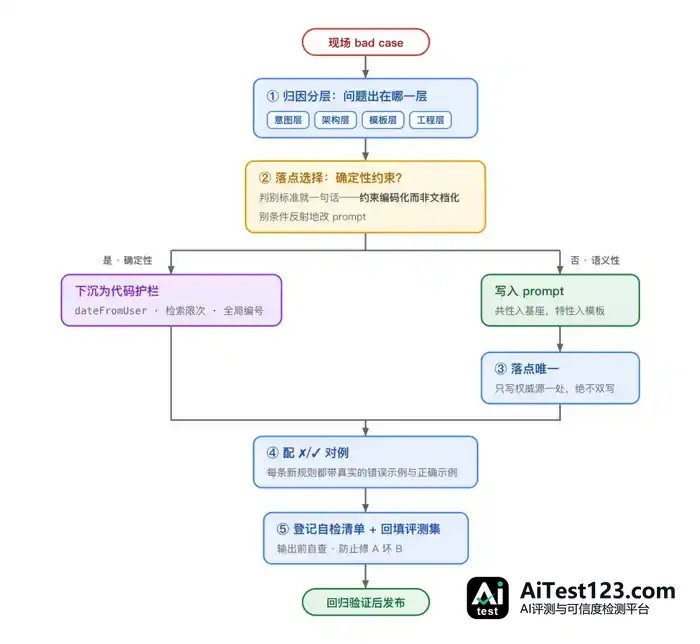
① 归因分层。先判断问题出在哪一层:意图分错(意图层)、规则冲突(架构层)、规则缺失(模板层)、还是根本不是 prompt 问题(工程层,如 citation 下发时机)。别条件反射地改 prompt。
② 落点选择:prompt 还是代码。判别标准就一句话:约束编码化而非文档化——写在提示里的规范,模型可能选择性遵守;做成代码护栏才具备强制力。我们的分工线:确定性约束(时间范围、检索次数上限、引用编号分配、迭代上限)优先下沉为代码——dateFromUser、RAG_MAX_RETRIEVE_PER_TURN、引用全局编号由请求级累加器统一分配、AGENT_MAX_ITERS,全都是先在 prompt 里约束、复发后升级为工程护栏的实例;语义性约束(分歧怎么呈现、溯源怎么标、分析深度)才留在 prompt。经验法则:同一 bad case prompt 修两次仍复发,就该考虑代码化。
③ 落点唯一。跨业务共性入基座,业务特性入模板,绝不双写。
④ 配 ✗/✓ 对例。每条新规则必须带真实的错误示例与正确示例。
⑤ 登记自检 + 回填评测。规则进基座"交付前自检清单"让模型输出前自查;case 进评测集,防止修 A 坏 B。
3.4 规则写作范式小结
回顾 364 行的基座规则,能提炼出五个反复出现的写作模式:
- 术语先行:KB、<X>、template 等核心术语先定义再使用,杜绝规则内部的指代歧义;
- 铁律分级:"违反即失败"的最高优先级铁律与建议项分开,让模型清楚哪些不可协商;
- 防御性枚举:把模型可能的"自由发挥"逐一列为禁止项(案例一、三);
- 降级预案:Mermaid 渲染失败给文本降级、流式无法中断确认给同轮披露——规则要适配真实交付形态;
- ✗/✓ 对例:每条硬规则配真实的正误示例。
为什么对例是必选项而不是加分项:抽象规则只能表达"是什么",示例才能表达"怎么做"。LLM 对可模仿样本的遵循度,高于对抽象约束的遵循度——✗/✓ 对例就是把规则转译成模型最容易学的形式。
另一条值得记住的底层原则是标识符稳定:上下文加工(压缩、改写、汇总)中,编号、UUID、hash 这类标识符必须原样保留,改错一位下游即失效。我们的引用体系与之同源——多轮检索的切片编号由请求级累加器统一分配、跨轮次稳定、重复命中保留首次节点,<X> 标注才能与最终来源列表一一对应。
四、评测闭环:
没有评测集的 skill 调优是玄学
前三章的每一次"改",都依赖同一个前提:改完之后,你得知道有没有变好、有没有把别的改坏。 没有评测集,skill 调优就是玄学——改了 prompt 不知道是否变好,换了模型不知道是否退化。
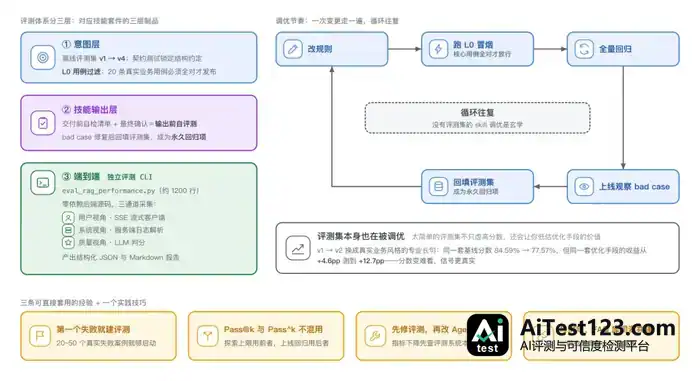
我们的评测体系分三层,对应技能套件的三层制品:
① 意图层:离线评测集 + 契约测试。 意图分类评测集从 v1 演进到 v4,并支持L0 级用例过滤——20 条真实业务用例单独标记,每次变更必须全对才能发布(新意图树回归时 L0 全绿)。另配契约测试锁定意图体系的结构约定。意图层单独可回归,不与技能层耦合评测。
评测集本身也在被调优。v1 的问句偏短偏模板化,v2 全面换成真实业务风格的专业长句——同一套基线配置,分数从 84.59% 掉到 77.57%。分数变难看了,但信号更真实:同一套优化手段(例句 + 判别经验),在 v1 上只测出 +4.6pp 收益,在 v2 上测出 +12.7pp。太简单的评测集不只虚高分数,还会让你低估优化手段的价值,过早得出"没什么可改了"的结论。
② 技能输出层:自检清单 + bad case 回归。 基座的"交付前自检清单"和"最终确认"本质是让模型在输出前做一轮自评测;每个现场 bad case 修复后回填评测集,成为永久回归项。
③ 端到端:独立评测 CLI。 上线后我们编写了 eval_rag_performance.py(约 1200 行独立脚本),对多轮检索场景做端到端评测:三通道采集数据——SSE 流式客户端(用户视角)、服务端日志解析(系统视角)、LLM 判分(质量视角)——零依赖后端源码,产出结构化 JSON 与 Markdown 报告。
三条经验对我们帮助很大,可直接套用:
- 第一个失败就建评测。不必等体系完备,20~50 个真实失败案例就够启动。我们的评测集 v1 正是从首批 bad case 起步、随现场反馈滚动到 v4 的。判断用例质量有个简单标准:两个领域专家对同一案例独立判断结论不一致,说明验收标准还没定义清楚——先解决定义,再收集数据。
- Pass@k 与 Pass^k 不能混用。探索能力上限用 Pass@k(k 次至少一次对),上线回归用 Pass^k(k 次全对)。我们的 L0 用例过滤对应的正是 Pass^k 思路:核心用例每次变更必须全对。
- 先修评测,再改 Agent。评分器 bug、用例与生产脱节、环境噪声,在结果数字上与模型退化一模一样。看到指标下降,先查评测系统本身,再动技能——基于失真信号改 prompt,方向从一开始就是错的。
最后一个实践技巧:评测集与 typical_questions、FAQ 库同源共建。三者都需要"真实业务风格的问句 + 期望行为",一份业务语料整理一次,三处复用。
完整的调优节奏串起来是:改规则 → 跑 L0 冒烟 → 全量回归 → 上线观察 bad case → 回填评测集,循环往复。
五、总结:
从 AI 初稿到生产级技能的 checklist
回到开篇的五条标准,每条给出可直接套用的验收项和它背后的原理:

几个关键数字放在一起,正好是这篇文章存在的理由:37 个技能 4 天生成,但打磨用了数周并持续到上线后;三层重构让单技能上下文从 6000 token 降到 1200(-80%);基座里 10 条铁律、5 类数据缺口处置、每条硬规则的 ✗/✓ 对例,背后都是真实 bad case。生成快、打磨慢——而打磨,才是 skill 工程的主体。
最后用两句话收束全文:
skill 的本质,是把领域专家的隐性经验编译为 LLM 可执行的显性规则。AI 能极大加速"编译",但"链接与调试"——路由、整合、调优、评测——仍然是人的工程活,也正是业务逻辑之外的胜负手。
而从运行时视角看,全部优化动作可以归结为一条分工线的持续校准:模型负责推理,外部系统负责状态和边界——skill 优化,就是不断把该外置的外置、该常驻的写短、该按需的拆开、该枚举的封死。