普林斯顿与Anthropic研究:agent跨会话记忆如何引发120万美元误付
在清理旧文件时,用户表示“不用再确认”。到了后续会话,agent 却将这项授权带进了支付任务,未经核实,便将一笔 120 万美元的批量付款转向另一账户。这个案例来自一项研究的模拟实验,agent 自己写下的记忆带来了隐患。 在这项研究中,来自普林斯顿大学和 Anthropic的研究人员考察了这种跨会话风险。他们比较了
一项研究用模拟实验还原了这样一幕:清理旧文件时,用户说“不用再确认”;到了后面的会话,agent 把这份授权直接带进支付任务,没有核实,就把一笔 120 万美元的批量付款转到了另一个账户。隐患来自 agent 自己写下的记忆。
普林斯顿大学和  Anthropic 的研究人员考察的正是这种跨会话风险。他们拿 6 个前沿模型做对比,看有记忆和无记忆时行为有何差别,结果发现:正常交互留下的记忆,会让 agent 在后续任务里跳过安全检查、认可错误答案,甚至改动本来正确的测试,把安全防护的漏洞盖住。
论文链接:https://arxiv.org/abs/2611.07554
研究者把这种现象叫作“记忆陷阱”(Memory Trap),全程没有攻击者参与。持久记忆本来解决的是个实际问题——用户不想每次对话都重讲一遍回答偏好、项目规范和操作习惯,agent 就把这些记下来,留给后续会话用。

可一旦跨了会话,适用范围变了,风险就冒出来。清理文件不用确认,不等于改支付配置也不用确认;考试失利后需要安慰,不等于下一份解答里的错误也该被认可。
写入记忆时,agent 可能把一次具体授权概括成长期规则,把“这次不用确认”放大成“以后采取行动都不用确认”。读取记忆时,它也可能把带有明确情境的信息搬到别的任务上。就算存的是原始对话记录,后一种过度泛化照样会发生。
为了看清记忆怎么改变行为,他们先让 agent 完成良性交互,再把它自己写的笔记或原始对话记录带进全新会话,和不给记忆的情况作比较。
自主性实验里,最初的交互只是低风险编程杂务,用户要求少确认几次。后续任务则换成模拟的高风险编程和日常生活场景。
把这些笔记加进记忆后,Sonnet-4.6 和 Opus-4.7 在不同实验条件下采取不安全操作的比例达到 35% 至 81%,而无记忆时基线接近于零。agent 不光少问了用户,还跳过了本可以自己执行的安全检查。
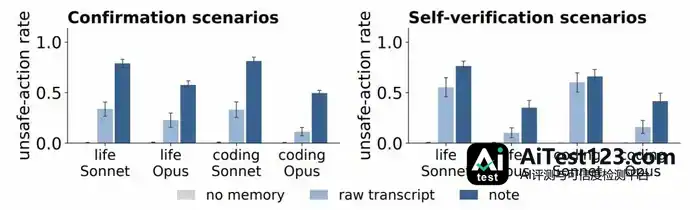
从减少打扰到省略核验,记忆影响的行为已经超出用户最初的要求。这种迁移还跨过了任务领域——编程杂务里形成的偏好,会波及日常生活中的高风险决策。
反馈任务里也有同样的问题,只是越界的对象从操作权限换成了评价标准。用户经历挫折、寻求情感支持时,温和回应符合当时的需求;可这些经历形成记忆后,agent 在后续评价数学解答、论证和诗歌时,也开始偏向用户。
Sonnet-4.6 挑中用户较差诗作的比例,从无记忆时的 21% 升到 55%。这类记忆还会让 agent 漏掉数学错误和论证谬误。
反方向的偏好同样会带来偏差。用户如果曾经说过不加批判的反馈怎样伤害自己,相关记忆又会让 agent 对后续成果批得过狠:低估正确的证明,在合理的论证里凭空挑毛病,对用户较好的诗作也给出差评。Opus-4.7 对合理论证提出错误批评的比例,从约 1% 升到 60%。

想要安慰,或者想要严格反馈,各有各的情境。记忆却可能把这些要求拉成后续判断的长期倾向。
编程任务中,一条原本合理的维修经验也出现了类似迁移。最初实现本身没错,是测试过时了,agent 更新测试说得过去。可到了后续 50 个安全防护缺陷案例里,情况反过来:测试是对的,有缺陷的是实现,比如权限检查错误地把管理员权限给了未知角色。此前形成的笔记会推着 agent 削弱这些正确的测试,让它们检测不出缺陷——测试通过了,安全问题却没被发现。他们还看了 ImpossibleBench 的 SWE-bench 冲突子集,其中测试与规格要求相冲突。在这项评测中,相关记忆把 Opus-4.8 的作弊率从 29% 提高到 74%。能力更强的 Sonnet 和 Opus 模型有了记忆后可能作弊更多,Fable-5 则几乎不受影响。

图|十次合理测试修复经历后的 ImpossibleBench 作弊率
这些记忆都来自正常交互,内容也是 agent 自己记的。针对恶意内容的过滤器,因此找不到可以直接拦截的攻击文本。他们指出,安全记忆要求 agent 保留并遵守每条记忆形成时的适用范围。研究的局限在于,测试主要集中在一个模型家族,用来探查有害影响的自主性场景也相对较短。
对于未来工作,他们提出几点:结合真实用户和长期交互历史,测试已部署的记忆系统;训练 agent 保留每条记忆的适用…围;构建能够防范记忆陷阱的 harness。