Terray联手英伟达改进模型,AI制药转到实验室里拼数据
AI能在一瞬间生成成千上万个分子,但把它们做出来,仍然需要大量时间和实验资源。 这正是AI制药正在面对的新问题:分子设计和计算筛选不断提速,实验能力却未必同步增长。 随着分子设计和计算筛选不断提速,实验能力正成为AI制药新的竞争焦点。实验室不再只是验证模型结果的场所,还需要持续生产高质量数据,让实验结果反过来推动模型优
AI眨眼间就能生成上万个分子,可真要把它们做出来,时间和实验资源一样都省不掉。
分子设计、计算筛选一路加速,实验能力却未必跟得上——这成了AI制药眼下绕不开的新问题。
于是实验能力开始被当成AI制药的新战场。实验室的活儿不只是验证模型算出的结果,还得源源不断产出高质量数据,再拿这些结果回头去喂模型。
近几年不少AI制药公司干脆自己盖实验室,把实验能力塞进技术平台里。2018年成立的Terray Therapeutics就是其中之一。
这家公司把高通量实验设备、自动化实验流程和AI模型拧进同一套研发体系,想让实验室从流程末端的验证环节,变成模型持续学习的数据来源。
2026年10月,Terray公开了与英伟达的合作进展:双方微调Nemotron系列视觉语言模型,从科学论文的化学反应示意图里提取分子结构、反应物和合成路线。在RxnCaption基准测试中,模型的HybridMatch F1由59.8提升到63.4。
不过,这项进展不等于实验室的合成效率已经提高。它说明的是模型在识别、提取化学反应信息上有所改善,能给后面的合成路线规划多提供一些可用数据。
从生产实验数据,到分子预测、合成规划,Terray正试着把AI和实验室接成一个不停转的研发闭环。
让实验室成为AI研发的一部分
数据不够怎么办?Terray的办法是从实验室下手,把实验数据生产、模型设计和后续验证串起来,做成一套不断迭代的研发闭环。
2025年11月,这套体系被命名为EMMI(Experimentation Meets Machine Intelligence,实验与机器智能)。它不是某个单一模型,而是把小分子研发所需的实验硬件、自动化流程和多个AI模块连在一起的平台。
其中,实验室首先承担生产数据的任务。
公开数据库里分子结构和实验结果攒了不少,可各家实验室的检测方法、实验条件、数据精度并不一致,对未命中分子的覆盖也不够。碰上没有已知活性分子、研究还不充分的靶点,光靠公开数据往往凑不齐训练所需的信息。
为此Terray自己做了超高密度微阵列芯片,把大量小分子固定在芯片上,并行测量它们跟目标蛋白的结合情况。它的意义不止是筛选通量更高,更在于能持续拿到适合训练模型的定量实验数据。实验室也就从验证模型结果的部门,变成了AI体系的数据入口。
截至2026年6月,Terray披露累计完成超过4200亿次单独测量,覆盖超过170亿种独特的“靶点—分子”相互作用。这些数据给模型训练添了新信息,也帮公司去探公开数据库还没充分覆盖的化学空间。
数据到手后,再由不同模型分担研发决策:
COATI是化学基础模型,把分子的字符串、二维结构和三维构象映射进统一的数学表征空间,为后面生成分子、预测性质打底;
TerraSynth负责合成路线规划,为候选分子给出合成路线,让设计阶段就提前掂量分子到底能不能做出来;
TerraBind是结合效力预测模型,判断小分子与目标蛋白可能结合得多强;
EMMI Select则是实验选择模块,把模型预测结果和不确定性评估放在一起,帮着决定下一批先合成、先测试哪些分子。
这几个模块对应的是同一条研发流程上的不同问题:分子表征、合成规划、结合效力预测,再到挑出最值得验证的那组候选。说到底,模型能提出成千上万个设计,实验室能合成、能测试的数量却有限,预测分数最高,未必就该把实验资源押上去。
合成规划这块,2026年6月Terray推出了TerraSynth。据其披露,在17个内部项目中,走这套流程提出的分子,对比没考虑合成约束的设计方案,合成速度提高约2至4倍,合成延迟最高降低75%。
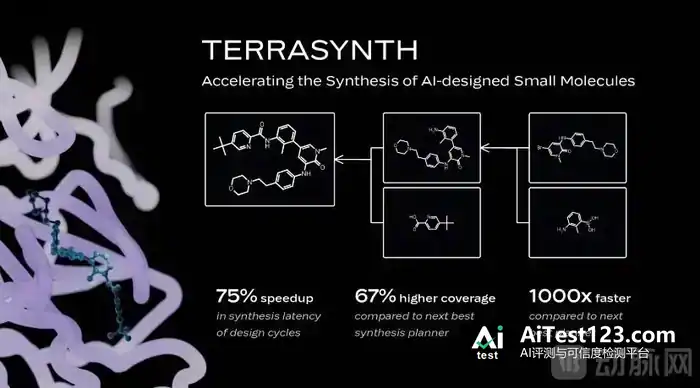
与英伟达合作解析化学反应图,也是这一环的数据补充:靠视觉语言模型把论文里的反应示意图转成结构化信息,让模型多学一些化学反应规律。
结合效力预测方面,Terray还公布了TerraBind-Struct的测试结果。公司称,在单张NVIDIA A6000 GPU上,TerraBind-Struct对单个蛋白质—配体复合物的端到端推理速度约为Boltz-2的26倍;在公开CASP16测试集和公司内部数据集上,其结合效力预测与实验数据之间的Pearson相关系数较Boltz-2提高约16%至20%。
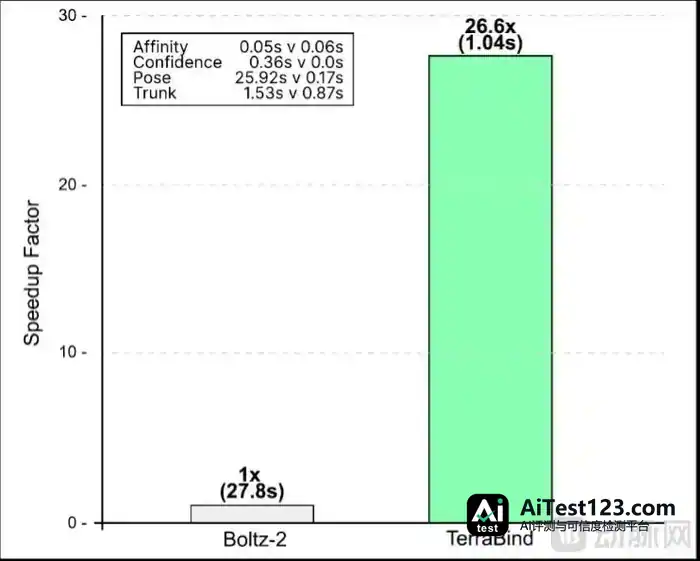
单个A6000 GPU上,采用196个令牌、10个采样和NVIDIA的cuEquivariance核时,每个复数端到端推理时间比Boltz-2提升了26倍。
计算和实验资源都有限,Terray想借此筛出更多候选分子,再把更值得验证的设计送进实验室。它要回答的问题并非“哪个分子分数最高”,而是“哪一组实验最该先做”。
实验做完,数据还要回到模型里。Terray用定制软件把AI设计与实验室自动化连起来,让分子合成、实验检测和模型更新彼此衔接。新一轮实验既用来验证预测,也会产出新的训练数据,影响下一轮分子设计。
所以Terray要建的并非“AI生成—人工验证”的单向流程,而是这样一条链路:实验生产数据—模型提出设计—实验室合成与测试—结果回流模型。
这套闭环才是EMMI的核心。COATI、TerraBind、TerraSynth和EMMI Select各自承担分子表征、性质预测、合成规划和实验选择等任务,并非孤立产品,而是一起嵌进研发流程。
合作先行,管线随后
技术体系到底管不管用,最终还得看研发项目。目前Terray已与多家药企建立合作。
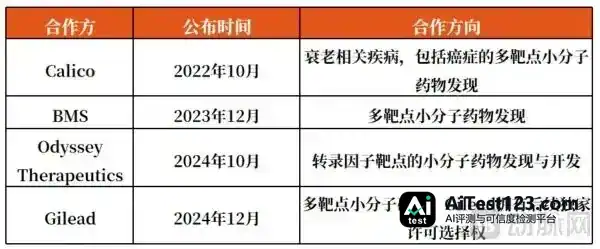
Terray合作情况一览。这些合作里,药企主要出靶点资源及相关疾病生物学知识,Terray则靠自身的高通量实验和AI平台做小分子药物发现。按合作协议,双方在后续研发和商业化环节的分工并不相同。
拿Gilead的合作来说,双方围绕多个靶点开展小分子药物发现与开发。Gilead若行使独家许可选择权,相关化合物的后续开发和商业化就由其负责;Terray则有望拿到首付款、研发及销售里程碑付款和销售分成。
2025年12月,Terray对外表示,与BMS合作的项目已经拿下了第一个药物发现里程碑,涉及的是那些过去没有化学起点、难度不小的靶点。但公司没有公开具体的靶点、候选分子、项目进行到哪一步,也没有透露里程碑金额。
合作进展之外,Terray的自研管线还需时间检验。
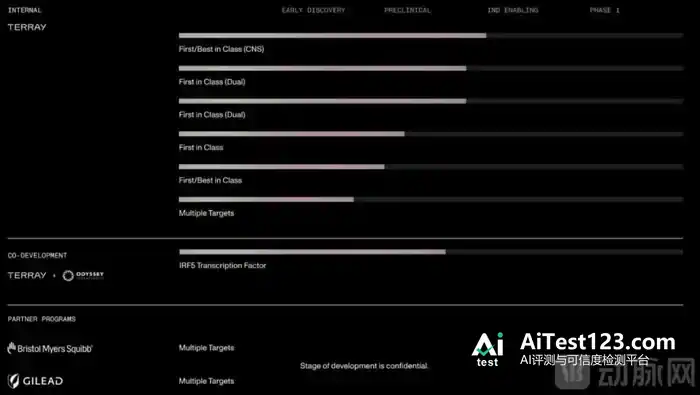
Terray在研管线情况一览。2026年2月,CEO Jacob Berlin接受GEN采访时说,公司推进最快的自研项目是一款具有脑穿透能力、用于多发性硬化症的抑制剂,预计2027年进入临床。采访没有披露具体靶点和临床前数据。
这个时间表比公司此前的预期晚了一些。2024年Terray曾预计首个候选药物2026年进入临床;到2026年2月,这一节点更新为2027年。
平台还在扩,合作也在往前走,自研管线却仍旧卡在临床前——Terray眼下的处境就是这么个样子。差了一年,算不上失约,但也说明平台能力和临床进度从来就是两条各走各的曲线。药企合作里的阶段性里程碑,能看出平台在某个具体项目上有多大用处;可自研药物该走的候选物确定、临床前研究、临床试验,一步都省不掉。
平台能否真正变成药物资产,还得看更多项目的结果。
AI制药,各有各的实验室
并非所有AI制药公司都把自建实验室当成平台建设的核心。即便都在投入实验能力,各家产出的数据也不尽相同。
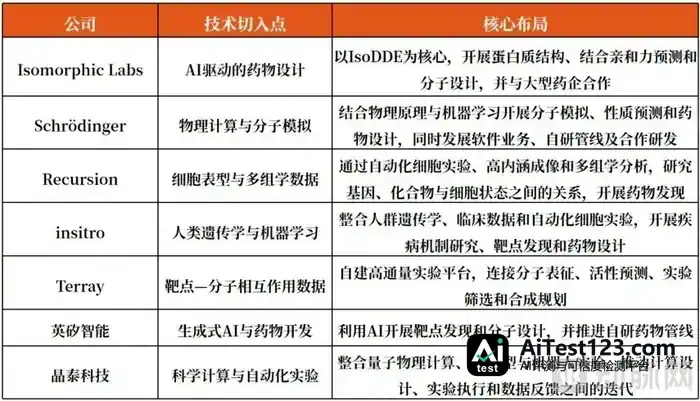
各家AI制药公司在技术切入点和平台布局上,走的并不是同一条路。
于是有个更根本的疑问摆上台面:模型要用的数据,究竟由谁生产,靠什么手段,在怎样的实验条件下做出来?
Terray给出的答案是分子与靶点相互作用的数据。它借助超高密度微阵列芯片,能让上百万种小分子与目标蛋白同时做结合测量。这些数据一方面用来找苗头化合物,另一方面也服务于后面的先导化合物优化。研究对象收得窄,测量通量却很高。
Recursion把细胞表型数据当作重要突破口。自动化细胞实验、高内涵成像加上多组学分析,几样手段一起上,看基因或化合物扰动之后细胞状态怎么变,再从中挖掘和疾病有关的生物学规律。
insitro走得更远一些:实验室产出的细胞表型数据,会和人群队列、临床数据、遗传学信息放在一起用,目标是从人类疾病的遗传与生物学机制里,找出因果关联更强的干预靶点。
不过也有公司不把自建高通量实验室当作平台建设的核心。Schrödinger起家于计算化学和分子模拟软件,软件产品及服务至今仍是其主要收入来源,药物发现业务也在做;Isomorphic Labs则把力气集中在AI药物设计模型上,2026年2月发布的IsoDDE覆盖了蛋白质结构预测、结合口袋识别和结合亲和力预测等能力。这两家的做法说明,自建实验室并非AI制药平台唯一的发展路径。
国内企业同样在试不同的实验路子。
英矽智能的办法是把AI平台建设和自研管线推进绑在一起。靶点发现和分子设计交给生成式AI,候选药物则由公司自己一步步推临床。其自主研发的Rentosertib于2026年进入III期临床,9月9日完成首例患者给药。
晶泰科技把量子物理计算、AI模型和机器人实验三样结合起来,用智能体去编排模型和实验设备,让计算设计、实验执行、数据反馈之间不断迭代。这套实验体系不光负责生产数据,还想把从计算预测到实验验证的周期压短。
几条路径摆到一块看,差别不在实验室大小,而在两个问题上:实验产出的是什么数据?这些数据能不能持续回灌给模型?前一个问题决定模型能研究什么,后一个则关系到模型能不能靠实验反馈越改越好。
放到这张行业图谱里,Terray的位置就清楚了:它把高通量的小分子—靶点相互作用数据生产摆在平台核心,再通过预测、筛选和合成规划,把实验数据接到后面的分子发现与优化上。
实验室是入口,药物才是答案
过去,AI制药比拼的主要是模型能不能预测结构、找到靶点、生成分子。
可设计和预测的效率一上来,新瓶颈就露头了:候选分子能不能合成,实验能不能及时验证,实验结果能不能反过来持续改进模型。
AI越强,越需要真实实验来提供约束。这也解释了Terray为什么同时往芯片、自动化实验、数据基础设施和模型上投钱——它想把实验室从研发流程里的验证环节,变成AI持续学习的来源。
话说回来,实验室不是建得越大越好,数据也不是越多越好。
4200亿次测量能不能转化成更好的候选药物,内部项目里的效率提升能不能在更多靶点上复现,合作里程碑能不能接着推进成临床项目,这些都还得靠结果说话。尤其是重复测量、数据覆盖范围和实验成本,都不是一个规模数字能替代的。
对Terray来说,接下来的检验很具体:首个候选药物能不能按新时间表进临床,EMMI能不能持续在不同靶点上交付研发结果,自研管线能不能产出可以公开的临床数据。
实验室正在变成AI制药的新赛场,但实验室只是入口,药物才是答案。
从生成一个分子,到把它合成出来,再到证明它对患者有用,AI制药还有很长的路要走。